
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Один раз сжатый контекст научились повторно передавать между разными LLM, чтобы принимающая модель не перечитывала документ для каждого вопроса. В препринте Rochester Institute of Technology и NVIDIA, который не проходил рецензирование и содержит замеры самих авторов, LatComm сократил вход получателя в 57 раз и ускорил обработку всех вопросов к статье втрое. Для систем с многократными обращениями к одним данным это переносит основную цену на однократную подготовку контекста.
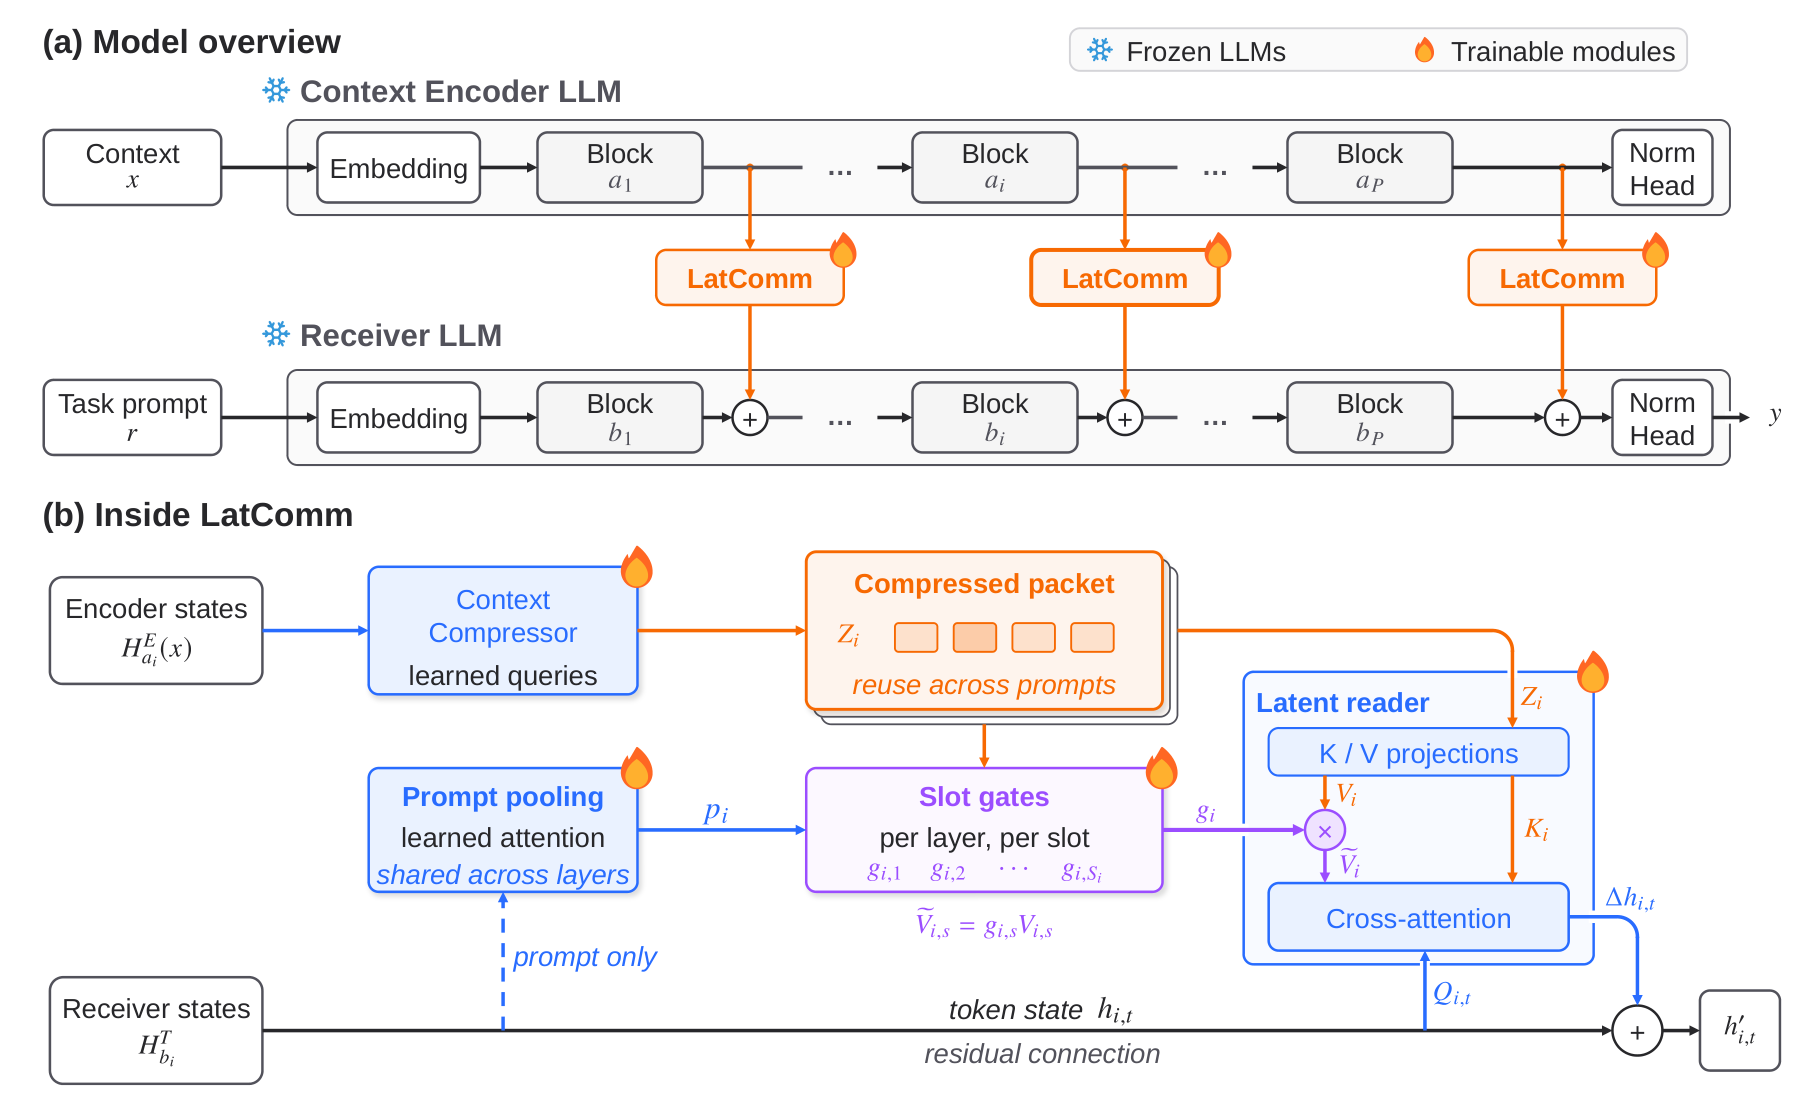
LatComm разделяет кодирование документа и его использование. Первая замороженная LLM читает контекст без вопроса и собирает пакет фиксированного размера из внутренних представлений. Вторая замороженная LLM читает этот пакет через перекрёстное внимание (cross-attention), а управляемые вопросом затворы выбирают нужные части.
Авторы обучают только прослойку между моделями: модули сжатия, чтения и затворы. После обучения сжатия пакет можно сохранить и применять к новым вопросам без повторного запуска кодировщика. При этом интерфейс связывает модели разного размера и семейства, но для каждой новой пары его придётся обучать отдельно.
В англоязычных тестах с выбором ответа LatComm повысил среднюю точность до 10,2 процентного пункта относительно методов, которые сводят документ к одному вектору. На QuALITY время замеряли на одном GPU H100: выигрыш возникал благодаря повторному использованию пакета для всех вопросов к одной статье, а не из-за ускорения отдельной модели.
Проверка охватывала получателей примерно на 1 млрд параметров и кодировщики не крупнее 9 млрд параметров. Ответ сводился к букве правильного варианта, поэтому результаты не показывают качество свободной генерации. LatComm также требует доступа к внутренним состояниям моделей и не подходит для LLM, доступных только через текстовый API.
Источники
Иллюстрация: рисунок из статьи «LatComm: Reusable Context Compression for Latent Communication between Large Language Models», Huawei Lin, Jinting Liu, Tan Yu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


