
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили искать нужные фрагменты ультрадлинного контекста, не сравнивая каждый запрос со всеми предыдущими токенами. На контексте в 10 млн токенов один слой внимания работал в десятки раз быстрее исходных вариантов, хотя препринт не рецензирован и все числа получили сами авторы. Для команд это открывает два пути: заменить внимание в готовой модели через D-LSA или заложить N-LSA в обучение новой.
Индекс перестаёт перебирать весь контекст
Полное внимание сравнивает каждый запрос со всеми предыдущими ключами. При предзаполнении (prefill), когда модель обрабатывает входной контекст перед ответом, объём вычислений растёт квадратично относительно его длины. При генерации каждого следующего токена работа растёт линейно.
Разреженное внимание сокращает число ключей, которые попадут в сам слой внимания. Но сначала отдельный индексатор обычно оценивает каждый ключ или каждый последовательный блок. На ультрадлинном контексте поиск кандидатов становится дороже последующего внимания и сохраняет прежний характер роста.
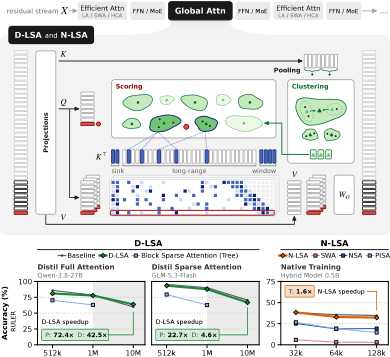
Latent Sparse Attention, или LSA, группирует ключи по сходству в обученном скрытом пространстве признаков. Соседние ключи сначала объединяются для более дешёвой обработки, затем алгоритм Уорда собирает похожие элементы в кластеры. После завершения блока его состав фиксируется, а модель хранит центр каждого кластера и таблицу входящих в него позиций.
Для нового запроса индексатор сравнивает его не со всеми ключами, а с центрами кластеров. Лучшие кластеры раскрываются обратно в позиции токенов. К ним добавляются начало контекста и недавнее окно, поэтому модель сохраняет локальную связность и может обращаться к далёким фрагментам.
Плоский вариант всё ещё просматривает все центры и сокращает только постоянный множитель. Древовидный вариант объединяет кластеры в иерархию и проходит её лучевым поиском: на каждом уровне сохраняет несколько подходящих ветвей. Число сравнений для одного запроса тогда растёт логарифмически, а обработка всего входа — быстрее квадратичной зависимости.
D-LSA сохраняет модель, N-LSA меняет обучение
D-LSA предназначен для уже обученных моделей. Он добавляет к каждому слою небольшие проекции ключей и запросов, а остальные параметры замораживает. Проекции учатся воспроизводить распределение внимания исходной модели: фактически новый индексатор перенимает у неё выбор важных позиций, после чего использует кластеры вместо полного просмотра.
Такой путь не требует заново обучать базовую LLM. Однако модель всё равно нужно адаптировать на длинных документах, а для высокой скорости понадобятся специальные ядра GPU и поддержка распределённого запуска. Авторы встроили LSA в SGLang и подготовили реализации для H200 и B300, а также вариант на Triton для других GPU.
N-LSA рассчитан на новую модель. Он использует собственные ключи слоя внимания как пространство для кластеризации и учится вместе со всей сетью только на задаче предсказания следующего токена. Отдельная дистилляция не нужна: градиент проходит через веса выбранных кластеров и учит модель направлять запросы к полезным группам ключей.
Ускорение видно на слое, но дерево пока требует проверки
Готовые модели проверяли на GLM-5.3-Flash и Qwen-3.8-27B с контекстом до 10 млн токенов. В GLM-5.3-Flash один слой D-LSA ускорил предзаполнение в 22,7 раза, а генерацию — в 4,6 раза относительно штатного разреженного внимания. В Qwen-3.8-27B ускорение относительно полного внимания составило 72,4 и 42,5 раза соответственно.
Качество сравнивали на RULER и PaperTrail. Первый набор проверяет поиск и обработку сведений в длинном контексте, второй — связывание фактов из научных статей. D-LSA в среднем сохранял результаты базового внимания, но древовидный поиск на самых длинных входах терял точность быстрее плоского.
Это различие влияет на архитектурный выбор. Плоский D-LSA подходит как более осторожная замена индексатора в существующей модели, если фактические контексты уже настолько велики, что полный просмотр центров мешает производительности. Дерево имеет смысл тестировать отдельно на рабочих данных: его лучшая асимптотика не гарантирует лучшего баланса скорости и качества в конкретном диапазоне длины.
N-LSA проверяли в меньшем масштабе: на модели примерно с полумиллиардом параметров и контексте до 128 тысяч токенов. Один слой обучался в 1,6 раза быстрее полного внимания, но занимал 6,8 ГиБ памяти против 5,8 ГиБ, поскольку для обратного прохода сохраняются выбранные позиции. Эти результаты поддерживают эксперимент при обучении новой длинноконтекстной модели, но ещё не обосновывают смену архитектуры крупного проекта без собственного прототипа.
LSA также не сокращает KV-кэш: ключи и значения по-прежнему хранятся для всего контекста. Метод уменьшает стоимость поиска и внимания, но не решает проблему памяти. Поэтому план инфраструктуры должен сочетать LSA с управлением KV-кэшем, а оценку проводить на полном времени ответа и потреблении памяти, а не только на одном слое.
Источники
Иллюстрация: рисунок из статьи «Latent Sparse Attention: Towards Subquadratic Ultra-Long Context Attention», Ales Kubicek, Andrea Caciolai, Liangzu Peng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


