
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Видеоавтоэнкодер в модели управления роботом научились переводить в низкую разрядность почти без потери совместимости с уже обученной политикой действий. Хотя работа Ziye Deng и коллег не прошла рецензирование и числа в ней получили сами авторы, её главный результат показывает: качество восстановленного видео может остаться прежним, даже когда робот почти перестаёт выполнять задания. Для таких систем одной проверки изображения после квантизации больше недостаточно.
Хорошая реконструкция не гарантирует прежних действий
Вариационный автоэнкодер (VAE) превращает видео в компактное скрытое представление, а затем восстанавливает из него кадры. В моделях мира и действий это представление получает не только декодер: его также читает политика действий — замороженная модель, которая выбирает движение робота.
Из-за этого между кодировщиком и политикой возникает контракт. Политика ожидает не просто данные с похожим распределением, а знакомые координаты признаков: где закодировано положение объекта, направление движения или состояние захвата. Кодировщик и декодер могут вместе перейти к другой системе координат и по-прежнему хорошо восстанавливать видео, но политика эту перестройку не увидит и начнёт получать незнакомые сигналы.
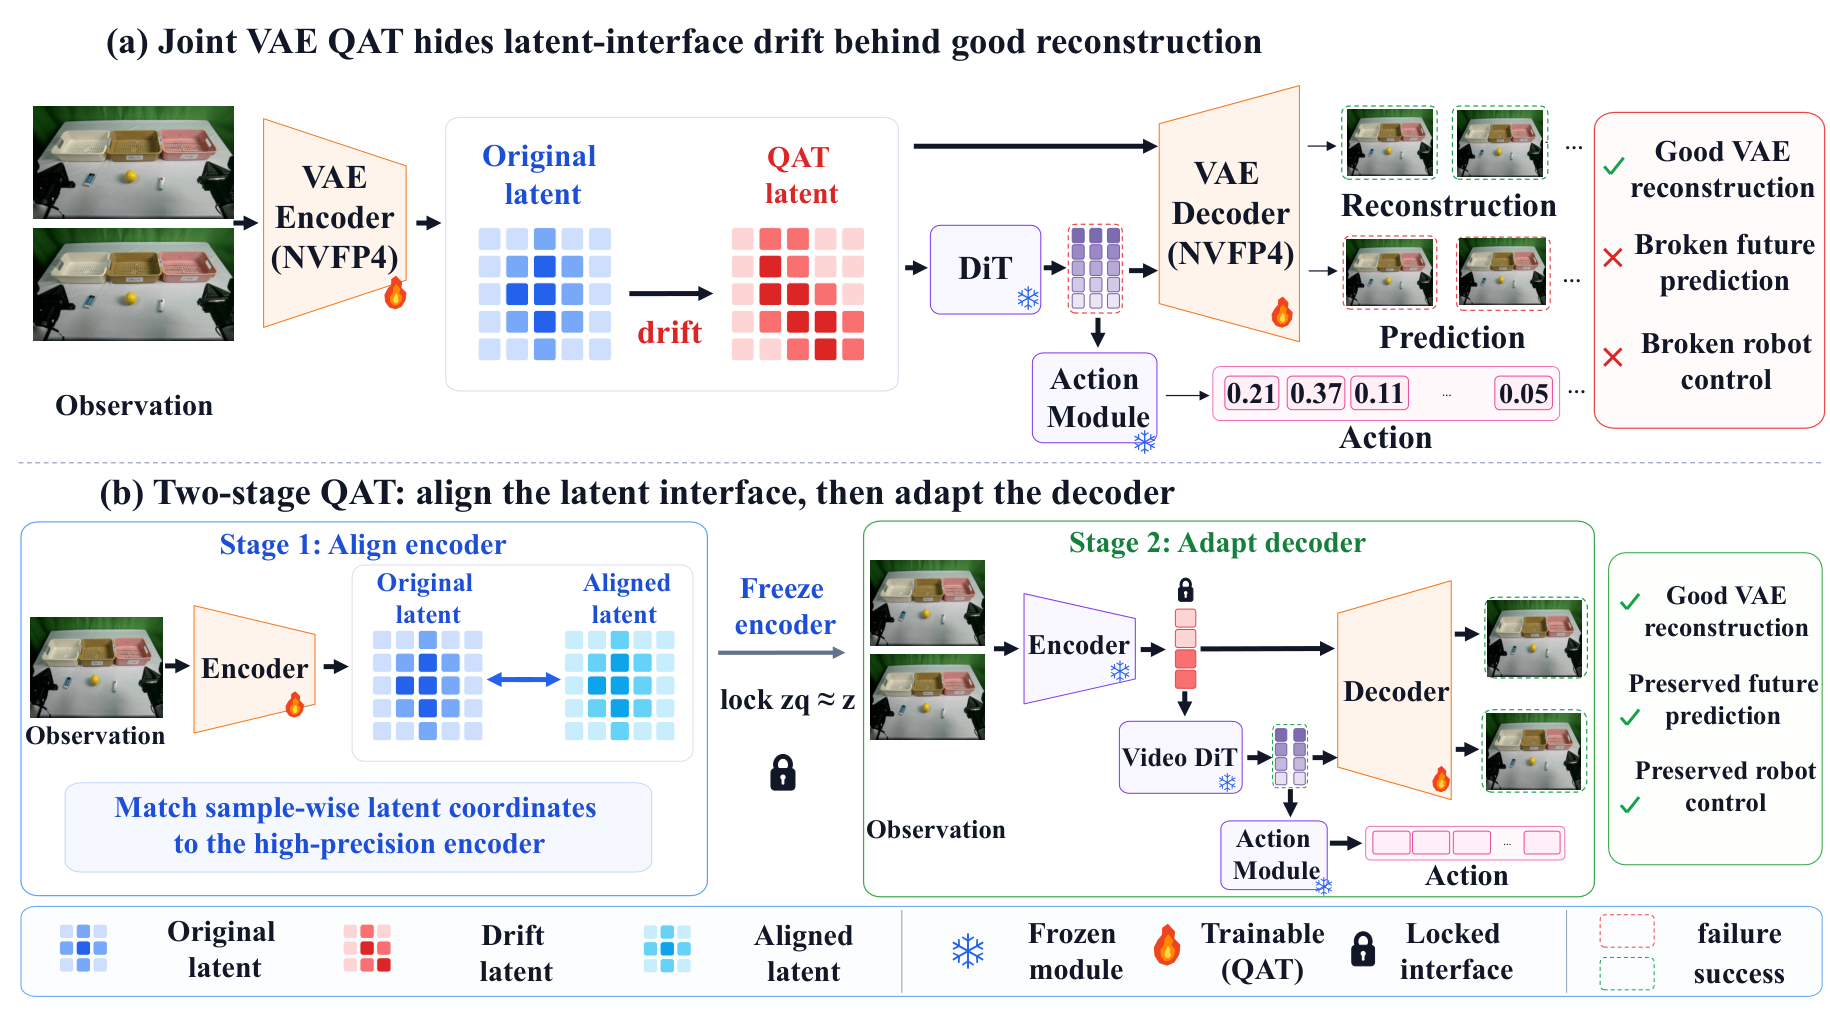
Именно это произошло при обычном совместном обучении с учётом квантизации. На Wan2.1 оценка реконструкции VBench-7 почти не изменилась — 0,7403 против 0,7409, — а успешность в LIBERO упала с 95,5% до 10,5%. На Wan2.2 политика после той же процедуры не выполнила ни одного задания RoboTwin: успешность составила 0%.
Прямая квантизация без дообучения хуже восстанавливала видео, но лучше сохраняла управление. Значит, оптимизация реконструкции не просто не заметила поломку интерфейса, а предпочла решение, которое выглядело лучше по визуальной метрике и хуже работало в замкнутом контуре.
Декодер меняет градиент, который получает кодировщик
Авторы проследили поломку до декодера. При совместном обучении низкая разрядность действует не только как шум на выходе кодировщика: операции квантизации внутри декодера меняют восстановленные кадры и правило, по которому ошибка переносится назад.
В контролируемом опыте квантизацию включили только для активаций декодера. Направление градиента, который вернулся к скрытому представлению, повернулось на 67,45°. Кодировщик начал систематически обновлять параметры в другую сторону, хотя его собственные вычисления оставались высокоточными.
Этот сдвиг закрепился в параметрах. Когда операции низкой разрядности убрали и проверили исходный высокоточный кодировщик, его представление не вернулось к начальному состоянию. Следовательно, проблема возникает не из-за разового округления значений: совместное обучение постепенно переписывает признаки, которые читает замороженная политика.
Штраф за отличие скрытых представлений уменьшал дрейф, но оставлял конфликт целей. Оптимизатор всё ещё мог обменивать совместимость с политикой на качество реконструкции, если это снижало общую функцию потерь.
Командам нужно зафиксировать границу между модулями
LatentQuant разделяет обучение на два этапа. Сначала кодировщик подстраивают под NVFP4 и для каждого входного видео сближают его выход с высокоточным образцом. Ошибку нормализуют по каналам, чтобы признаки с большим естественным разбросом не подавляли остальные.
Затем кодировщик замораживают, а декодер отдельно учат восстанавливать видео из уже зафиксированного представления. Градиент реконструкции больше не может изменить интерфейс, который использует политика. Для выравнивания не нужны разметка действий и градиенты от самой политики: эталоном служит прежний кодировщик.
После такой настройки успешность составила 95,75% против исходных 95,50% на LIBERO и 68,8% против 69,8% на RoboTwin. Небольшой перевес на LIBERO авторы трактуют как паритет, а не как улучшение от квантизации. На NVIDIA B300 низкоразрядное исполнение ускорило полный проход VAE до 1,26 раза относительно BF16 cuDNN.
Работу проверяли на вариантах WALL-WM с Wan2.1 и Wan2.2, стендах LIBERO и RoboTwin, записях с физической платформы XSquare Robot и интерактивных заданиях реального робота. Замеры развёртывания относятся к NVIDIA B300, формату NVFP4 W4A4 и свёрточным операциям, поэтому практический выигрыш на другом оборудовании требует отдельного профилирования.
Для команды, которая квантует общий кодировщик при неизменном потребителе признаков, работа меняет план приёмки. Помимо качества реконструкции стоит сравнивать скрытые представления и действия на одинаковых входах, а затем проводить испытания в замкнутом контуре. При дообучении границу перед замороженной политикой следует фиксировать явно, а не защищать только дополнительным штрафом в общей функции потерь.
Если скрытое представление читает лишь собственный декодер, риск уже: оба модуля могут согласованно адаптироваться. Но когда тот же выход поступает в политику, планировщик или другой замороженный компонент, итоговая метрика первого модуля не подтверждает совместимость всей системы.
Источники
Иллюстрация: рисунок из статьи «LatentQuant: Preserving the Policy-Facing Latent Contract under NVFP4 VAE Quantization», Ziye Deng, Lufang Chen, Shuyu Feng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


