
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Рост величины скрытых состояний от слоя к слою оказался не просто сбоем, который нужно подавлять: Transformer может кодировать в нём номер слоя. В нерецензированном препринте University of Rochester, где все числа получили сами авторы, LayerRoPE достиг качества Pre-Norm при в 3,4 раза меньших затратах на обучение. Это меняет подход к глубоким моделям: вместо уменьшения остаточного потока можно регулировать, как каждый блок читает и записывает сигнал.
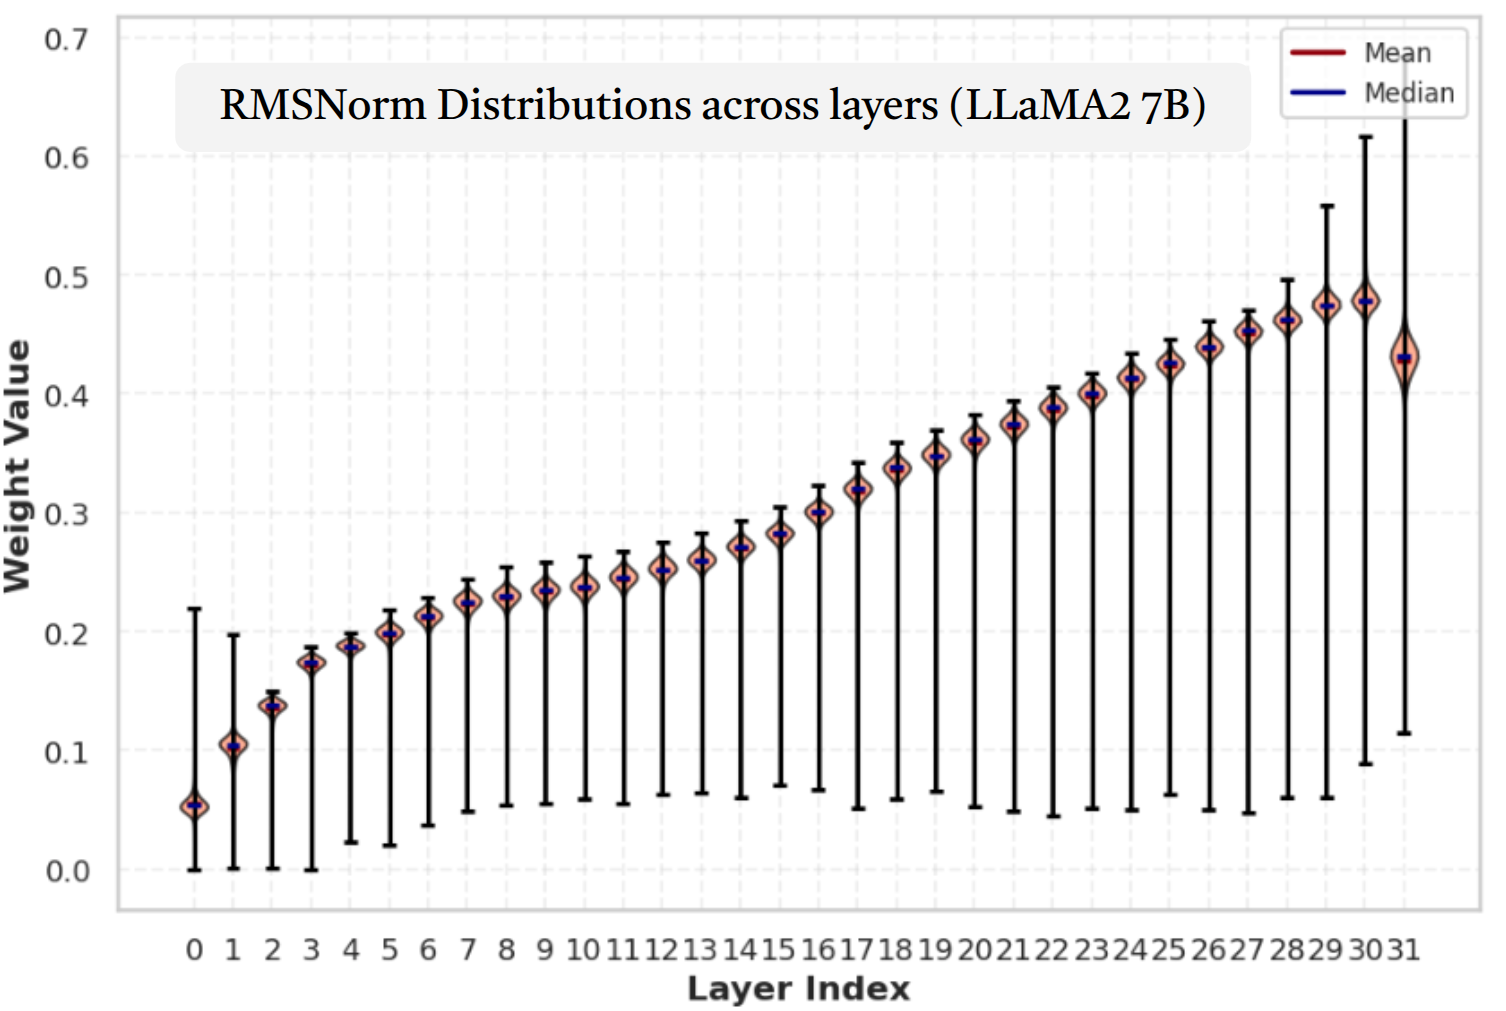
Shikhar Srivastava и Christopher Kanan изучили готовые LLM разных семейств и архитектур. Обучаемый множитель γ в RMSNorm, который меняет масштаб признаков, с глубиной не только растёт, но и поворачивается в пространстве признаков. Поэтому его длину и направление можно трактовать как скрытую координату слоя — аналог позиционного кодирования, но вдоль глубины сети, а не последовательности токенов.
LayerRoPE делает эту координату явной. Вместо отдельного вектора γ для каждого слоя метод хранит общий вектор и получает его варианты через зависящие от глубины масштаб и поворот пар координат. Такой механизм регулирует вход и выход вычислительных блоков, сокращает число параметров нормализации и добавляет не более 0,013% вычислений относительно Pre-Norm.
Метод проверяли на LLaMA-подобных моделях от 58 млн до 1,3 млрд параметров, обученных на C4 с одинаковыми данными и порядком примеров. Его сравнивали с Pre-Norm, Post-Norm, Peri-Norm и Layer-Norm Scaling, отдельно подбирая скорость обучения для каждого варианта. LayerRoPE давал наименьшую ошибку на всей шкале и продолжал улучшаться в узких сетях глубиной до 512 слоёв, тогда как другие способы переставали выигрывать от дальнейшего углубления или расходились.
Перенос на модели с повторяющимися скрытыми блоками и Vision Transformers тоже улучшил результаты без отдельной настройки. Но основные замеры относятся к предобучению моделей исследовательского масштаба. Для новой архитектуры практический вывод такой: рост остаточного потока не обязательно подавлять — полезнее явно задавать блокам их положение по глубине и раздельно управлять чтением и записью.
Источники
Иллюстрация: рисунок из статьи «LayerRoPE: Dynamic Depth-wise Magnitude & Angular Superposition», Shikhar Srivastava, Christopher Kanan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


