
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Qwen2.5-0.5B-Instruct научили выполнять разные запросы через разное число слоёв. В препринте, который не проходил рецензирование и приводит числа самого автора, вывод работал в среднем в 1,04 раза быстрее без ухудшения оценки вероятности текста. Для продуктовой команды это скорее приём дополнительной оптимизации, чем основание менять выбранную архитектуру.
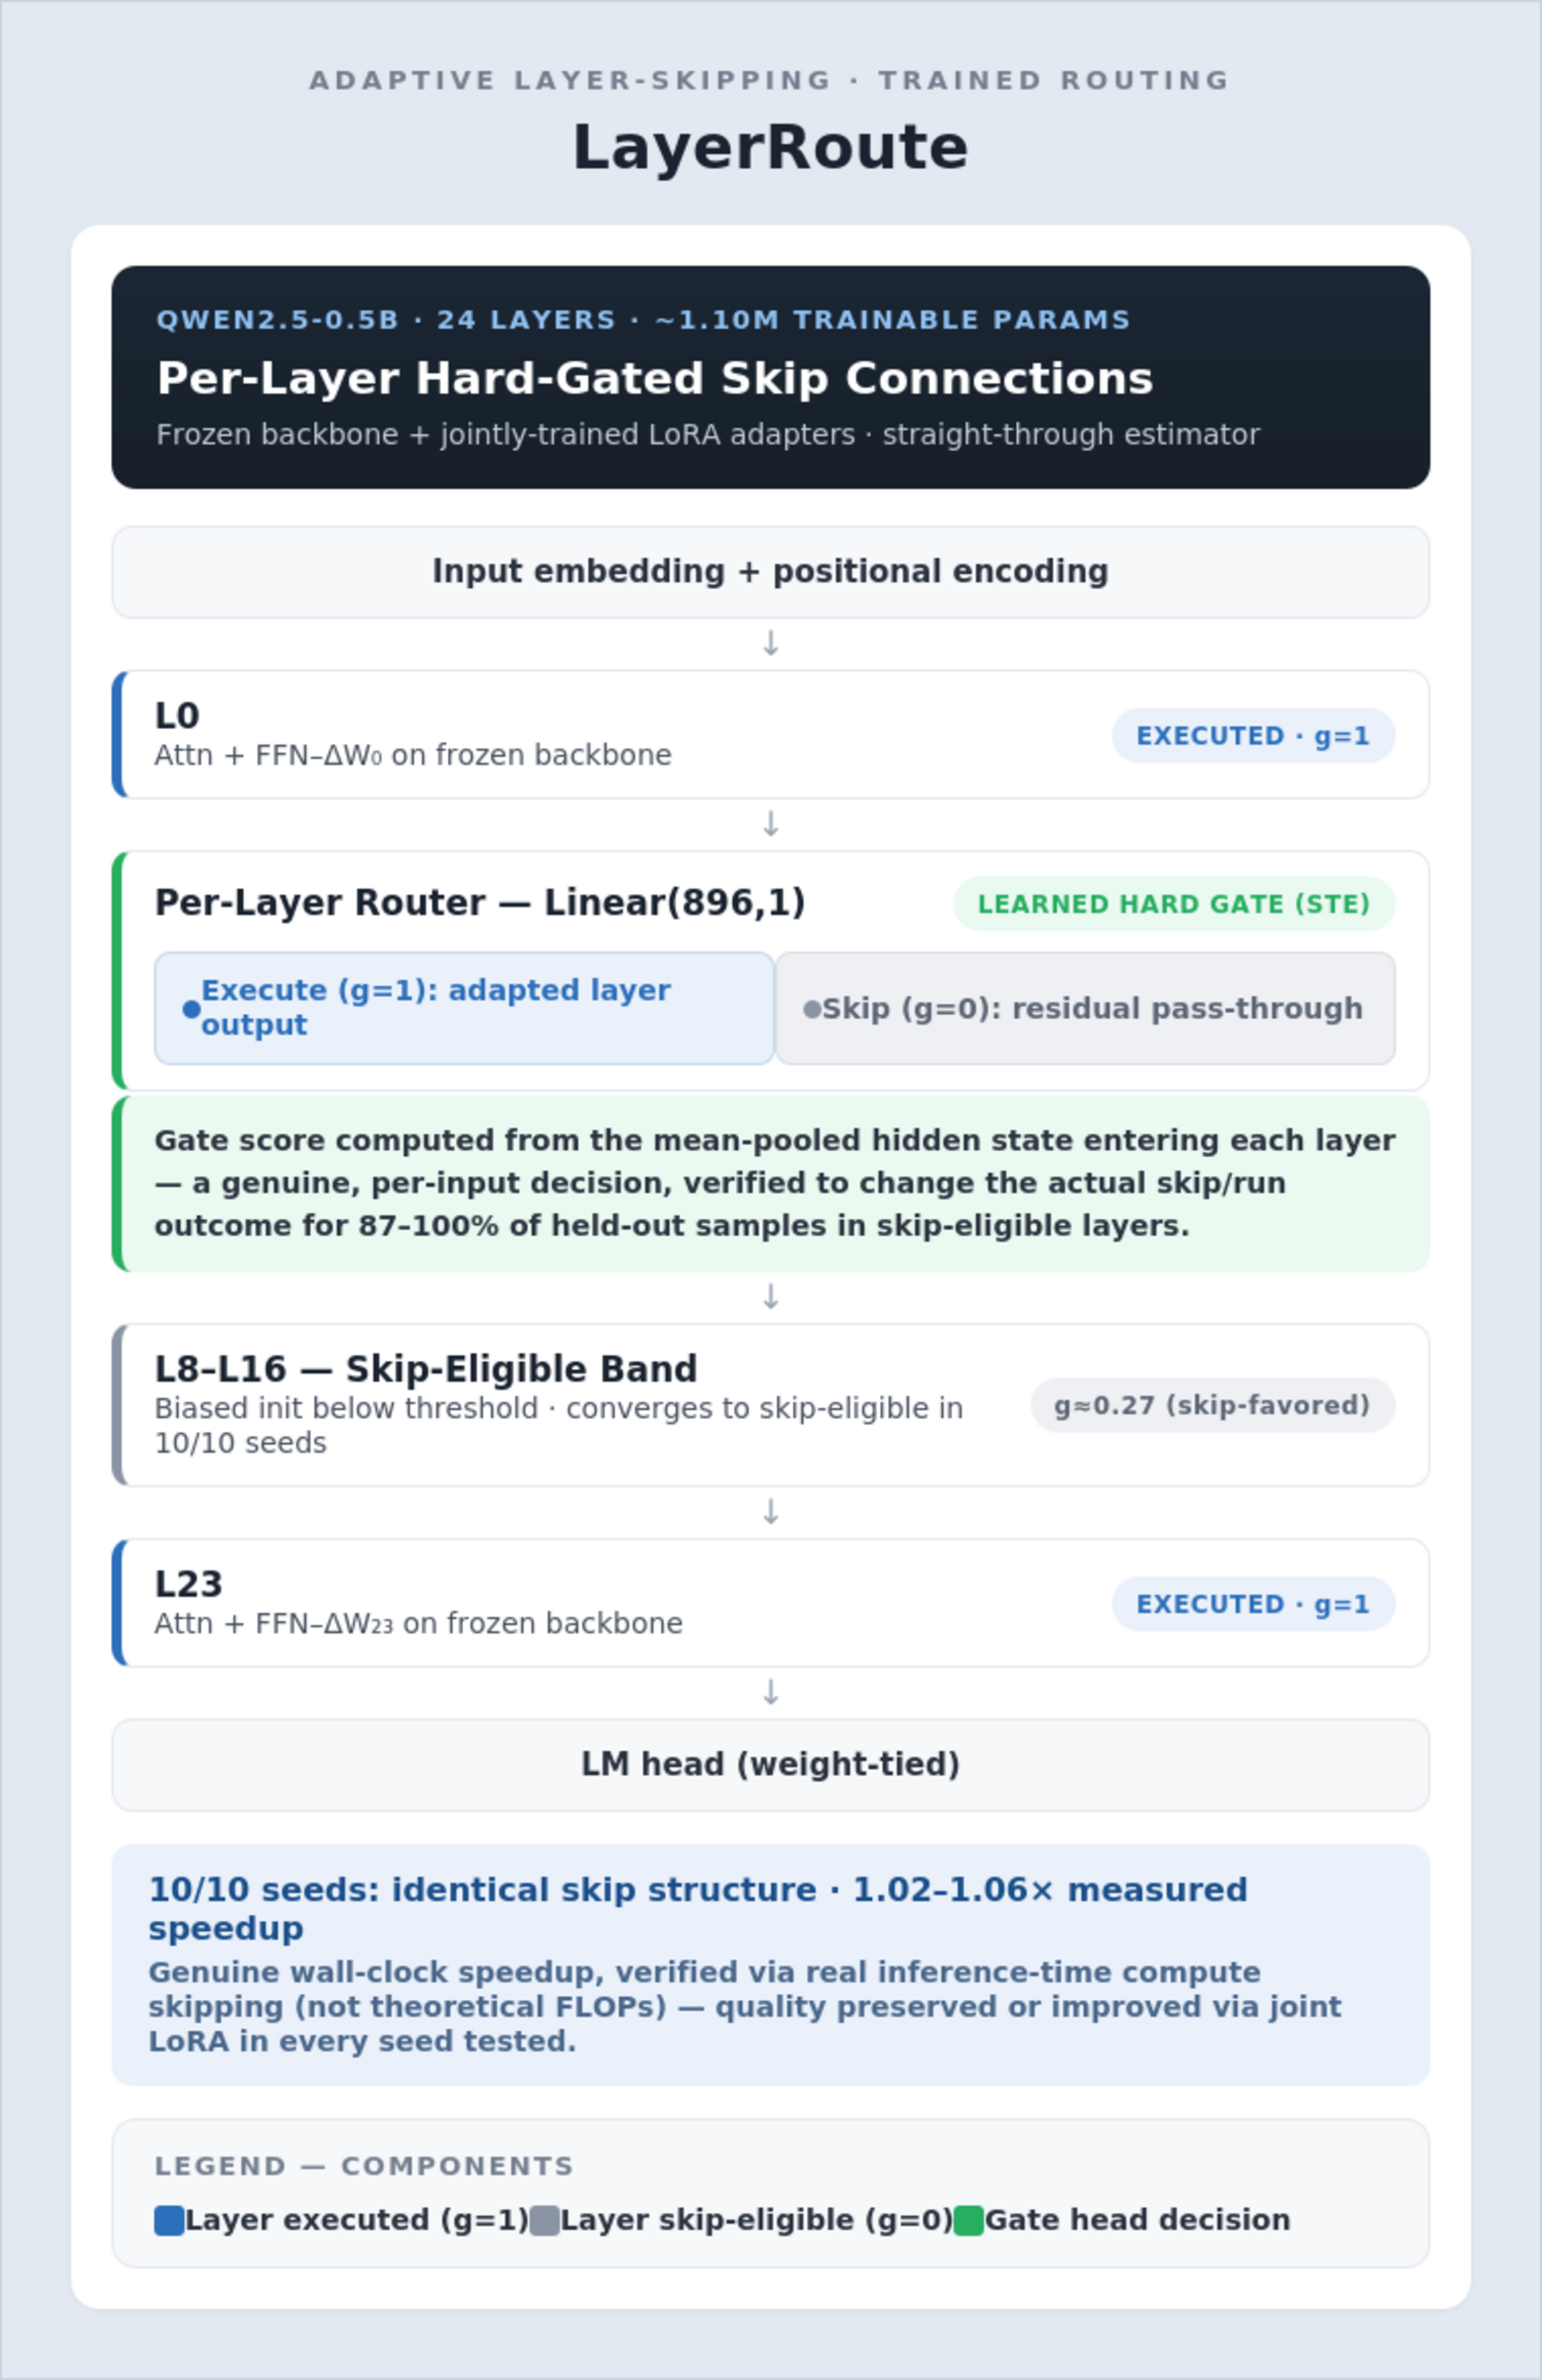
Метод LayerRoute добавляет маршрутизатор к каждому из 24 блоков модели. Он принимает жёсткое решение: запустить блок или передать его вход дальше без вычислений. Маршрутизаторы обучают вместе с LoRA — небольшими добавками к весам внимания, поэтому модель приспосабливается к пропуску слоёв, а не теряет их после обучения.
Во всех десяти запусках доступными для пропуска стали одни и те же девять средних слоёв. Ускорение составляло от 1,02 до 1,06 раза относительно той же модели с теми же LoRA, но с принудительно включёнными блоками. Замеряли реальное время последовательной генерации токенов: при закрытом маршруте блок не вычислялся, а не запускался с последующим отбрасыванием результата.
Перплексия — мера того, насколько уверенно модель предсказывает продолжение текста, — снизилась примерно на 1,1 пункта на обеих оценочных частях. В одном показательном запуске входные данные меняли решение маршрутизатора для медианных 93% примеров в пропускаемых слоях. Значит, LayerRoute не свёлся к заранее зафиксированной обрезке модели.
Проверка охватывает только Qwen2.5-0.5B-Instruct и смесь данных с вызовами инструментов, рассуждениями и планированием. На каждом запуске оценивали по 100 отложенных примеров, а базой служила полная модель с теми же донастроенными весами. Результат подтверждает небольшой выигрыш задержки в этой конфигурации, но не показывает, сохранится ли он на более крупных моделях и в других архитектурах.
Источники
Иллюстрация: рисунок из статьи «LayerRoute: Adaptive Layer-Skipping with LoRA-Preserved Quality for Efficient LLM Inference», Prateek Kumar Sikdar, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


