
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
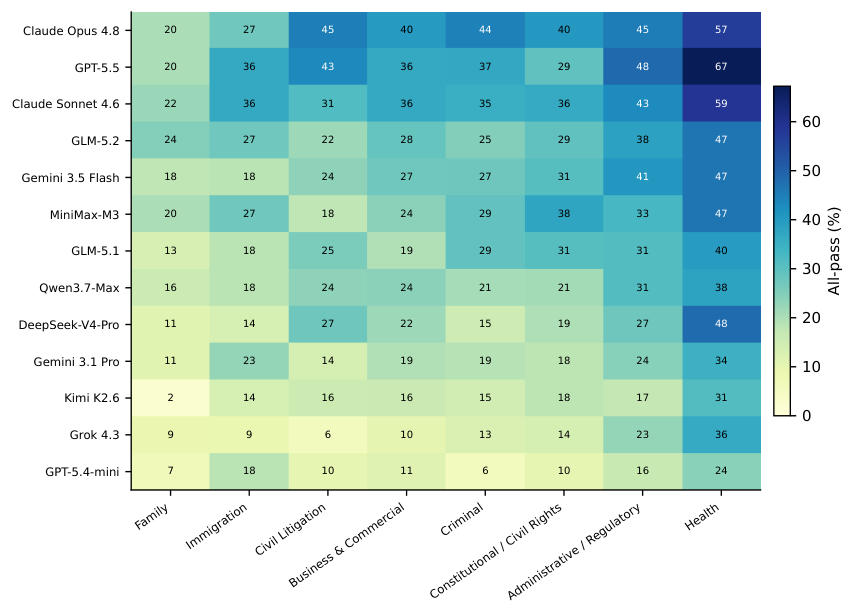
Даже лучшие ИИ-агенты пока не могут надёжно провести юридическое исследование от поиска норм до итогового вывода. В препринте Vals AI, который не прошёл рецензирование и содержит замеры самих авторов, Claude Opus 4.8 полностью справился с 42,9% заданий. Для продукта это означает, что доступ к поиску и базе судебных решений не заменяет проверку результата юристом.
Legal Research Bench включает 413 открытых вопросов по праву США. Практикующие юристы подготовили для каждого эталонный ответ, обязательные критерии и список подтверждающих источников. Ответ засчитывали, только если агент выполнил все критерии, сделал верный правовой вывод и сослался на действующие документы по корректным адресам.
В тесте участвовали 13 моделей с доступом к веб-поиску, CourtListener, загрузке страниц и поиску по уже найденным документам. Модель-оценщик GPT-5.4 проверяла ответы по критериям; перед этим её решения сверили с оценками практикующих юристов.
Частичная правильность маскирует риск. Claude Opus 4.8 набрал 85,4% по отдельным критериям, но полностью прошёл меньше половины заданий. На 29,5% вопросов модели пропустили хотя бы один ключевой критерий, включая нужную норму, обязательный прецедент или центральный правовой вывод. Задания, где требовалось согласовать несколько или противоречащих друг другу источников, проходили в 20,4% случаев против 29,9% для остальных.
Инструменты необходимы: без них результат в среднем падал на 22,5 процентного пункта. При этом больше поисковых запросов, шагов агента и затрат не давали более точного ответа. При проектировании такого продукта важнее отдельно проверять полноту вывода и каждую ссылку, чем просто увеличивать число циклов поиска.
Тест охватывает англоязычное право США и вопросы с достаточно однозначным ответом. Модели запускали по одному разу на задание в фиксированном наборе инструментов, поэтому результаты описывают этот контур, а не юридическую работу во всех юрисдикциях.
Источники
Иллюстрация: рисунок из статьи «Legal Research Bench: Measuring End-to-End Reliability in Long-Horizon Legal Research Agents», Katrina Drozdov, Oliver Chen, Langston Nashold и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


