
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Медицинскую визуально-языковую модель (VLM) научили не подтверждать диагноз только потому, что он назван в вопросе. В нерецензированном препринте, где все числа получил сам автор, MedScope-4B заявляла о стёртом поражении в 4–6 раз реже передовых моделей. Для продуктовой команды вывод узкий: контрфактические изображения полезны как тест и учебные данные, но не заменяют проверку способности находить редкие патологии.
Как отделили изображение от подсказки в вопросе
Закрытый вопрос сам подсказывает медицинской модели ответ. Если спросить «Есть ли полип?», модель может опереться на слово «полип», а не на изображение. Обычный тест засчитает правильное «да», но не покажет, откуда взялся ответ.
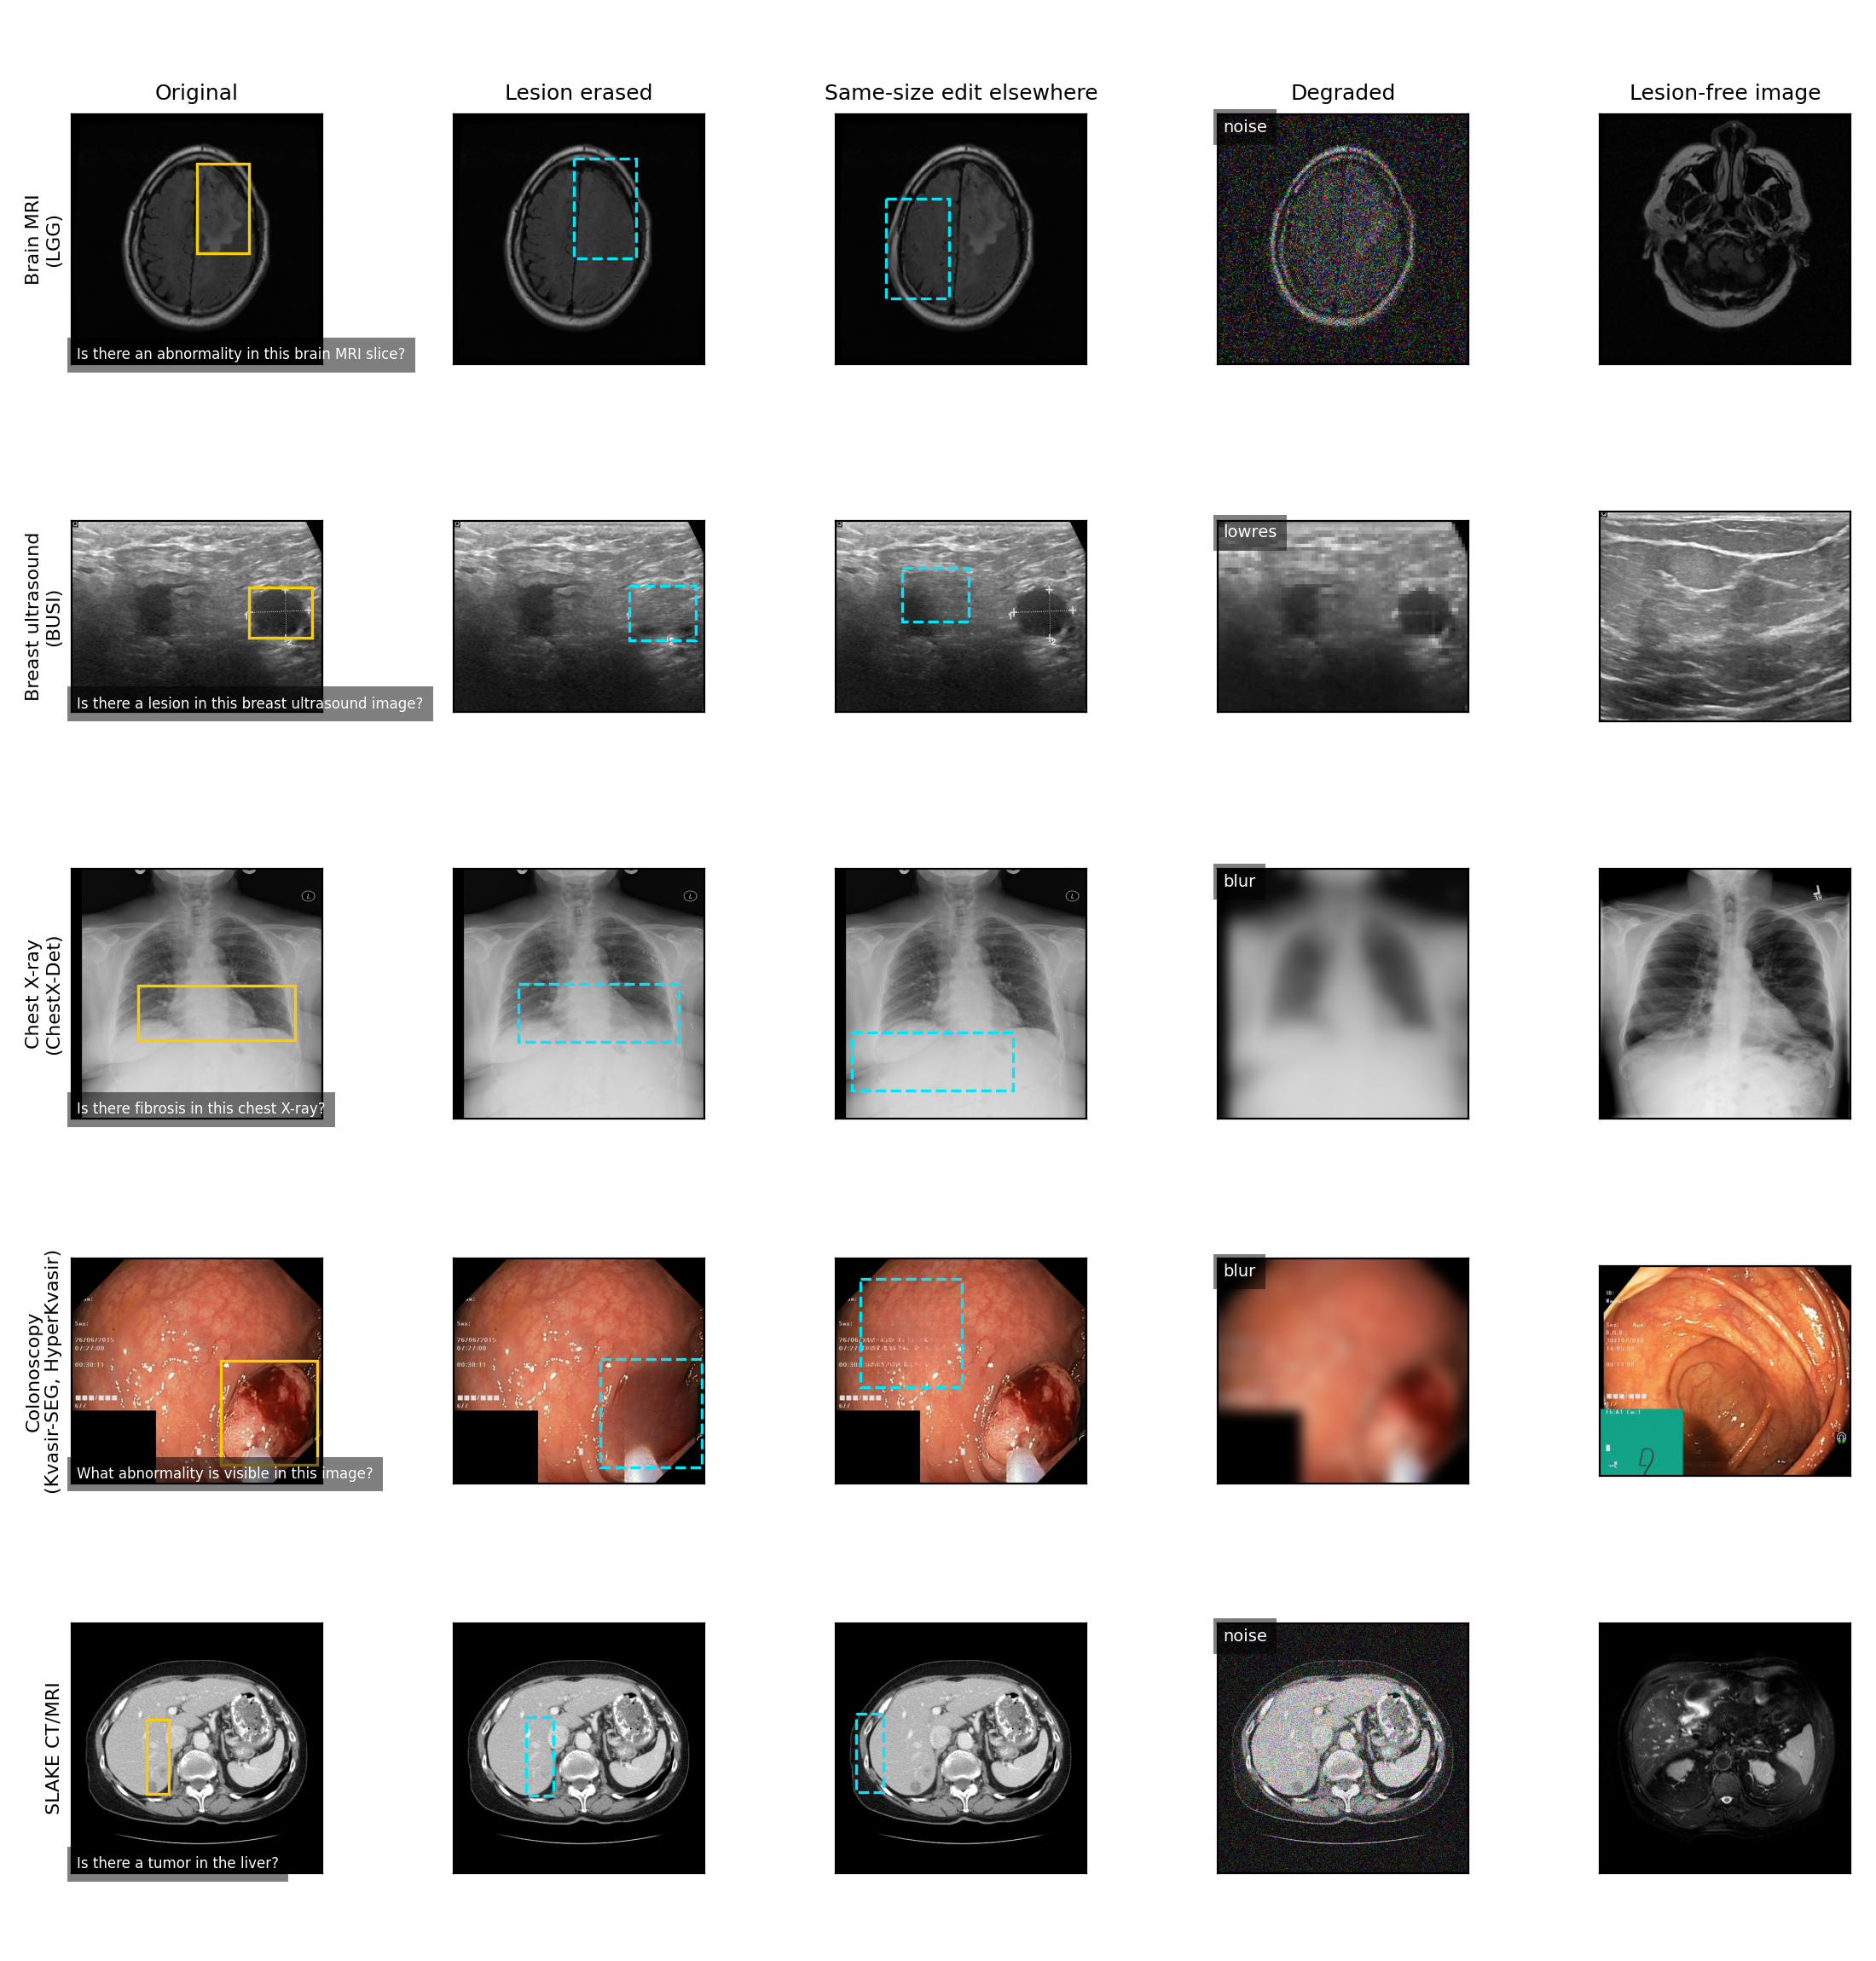
Bhaskar Gurram построил для каждого случая несколько вариантов изображения. В первом поражение стирали с помощью восстановления скрытой области. Во втором тем же инструментом меняли участок такой же формы в другом месте, не затрагивая поражение. Вопрос при этом оставался прежним.
Пара разделяет два возможных сигнала. Если модель реагирует на следы редактирования, она должна вести себя одинаково на обоих изображениях. Если ответ меняется только после удаления поражения, значит модель учитывает медицинский признак. В набор также вошли неизменённые снимки без поражений, чтобы модель не могла выучить правило «отредактировано — отвечай, что признака нет».
Для оценки введён разрыв чувствительности к изображению. Это разница между долей ответов «поражения нет» или передачи случая специалисту после целевого стирания и той же долей после контрольного изменения. У модели, которая игнорирует изображение или одинаково реагирует на оба изменения, показатель будет нулевым.
MedScope-4B построена на Qwen3.5-4B. Языковую часть дообучили через LoRA, а зрительный кодировщик оставили замороженным. Модель могла увеличивать область снимка, менять контраст, отвечать, просить уточнение или передавать случай специалисту. Учебные последовательности действий создали из меток и масок открытых наборов, без новой ручной разметки.
Внутренний тест охватил 507 случаев из пяти типов медицинских изображений. Для каждого пациента или группы почти одинаковых снимков данные разделяли между обучением и тестом, а качество стирания проверяли автоматически.
Стирание снизило ложные находки, но не улучшило зрение
На внутреннем тесте разрыв чувствительности MedScope-4B достиг 0,758. У передовых моделей он находился между 0,27 и 0,47. При этом точность на исходных изображениях с настоящими поражениями статистически значимо не ухудшилась.
Без контрфактических изображений показатель MedScope-4B падал до 0,279. Эффект повторился с MedGemma 1.5 4B и с незнакомыми модели инструментами стирания. Значит, основной вклад внесли именно учебные примеры, где наличие признака менялось при неизменном вопросе, а не особенность одной базовой модели или одного редактора.
Однако работа не показала, что контрольное изменение той же формы обязательно для обучения. Более простой вариант, где поражение удаляют и обучают модель предпочитать правильный ответ, на новых внешних данных не уступил по главному показателю. Ценность парного контроля здесь убедительнее как способ измерения, чем как отдельный принцип обучения.
Метод меняет склонность модели доверять изображению, но не улучшает само распознавание. Это различие проявилось за пределами внутренних данных: передовые модели чаще находили реальные поражения, хотя сильнее поддавались формулировке вопроса.
Контрфактические пары полезны до клинического пилота
Командам, которые строят медицинского помощника, стоит добавить такие пары в проверочный набор. Для каждого значимого признака можно сохранить вопрос и изменить только изображение: удалить признак, выполнить контрольное редактирование в другом месте и добавить настоящий отрицательный пример. Такой тест обнаружит модель, которая уверенно отвечает по текстовой подсказке и при этом хорошо проходит обычные задания.
Учебные данные тоже можно дополнить стёртыми и неизменёнными снимками. Но усложнять процесс точным подбором формы контрольного изменения пока нет оснований: работа не показала его преимущества перед простым удалением поражения и обучением на предпочтительных ответах.
Главный риск — покрытие конкретных патологий. На свежем внешнем тесте MedScope-4B пропустила 0 из 48 неотрицательных случаев пневмоторакса: она не обнаружила ни одного из них. Это показывает, как низкая частота выдуманных находок может соседствовать с неприемлемой чувствительностью к редкому критическому признаку.
Поэтому модель следует отбирать не только по общему разрыву чувствительности. Нужны минимальные пороги чувствительности для каждой клинически значимой находки, отдельные внешние центры и тесты на новых инструментах редактирования. Иначе система научится осторожно отрицать то, чего не видит, но не научится видеть нужное.
Работа проверяет короткие ответы на вопросы по одиночным 2D-изображениям. Генерация полных заключений, объёмные исследования и работа в клиническом процессе требуют отдельных испытаний. Кроме того, автоматические проверки не заменяют врачебную оценку того, действительно ли после редактирования поражение исчезло вместе со всеми вторичными признаками.
Источники
Иллюстрация: рисунок из статьи «Seeing Is Not Believing: Counterfactual Lesion Erasure Teaches a Small Medical Vision-Language Agent to Report Only What the Image Shows», Bhaskar Gurram, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


