
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили заранее перестраивать набор документов в рабочее пространство, чтобы следующие запросы не начинали поиск с нуля. В препринте Stanford University и Carnegie Mellon University, который не проходил рецензирование и содержит замеры самих авторов, Librarian Agents обошёл лучший способ поиска и предварительной обработки на BrowseComp-Plus в среднем на 33 процентных пункта. Подход меняет архитектуру систем, которые многократно отвечают по одной базе документов: часть вычислений можно перенести из обработки каждого запроса в единую подготовку корпуса.
Агент строит файловую систему вместо поискового индекса
Обычная система с поиском по документам реагирует на уже сформулированный запрос. Она находит подходящие фрагменты, а затем модель заново восстанавливает связи между ними. Если разные вопросы требуют одних и тех же связей, система повторяет эту работу.
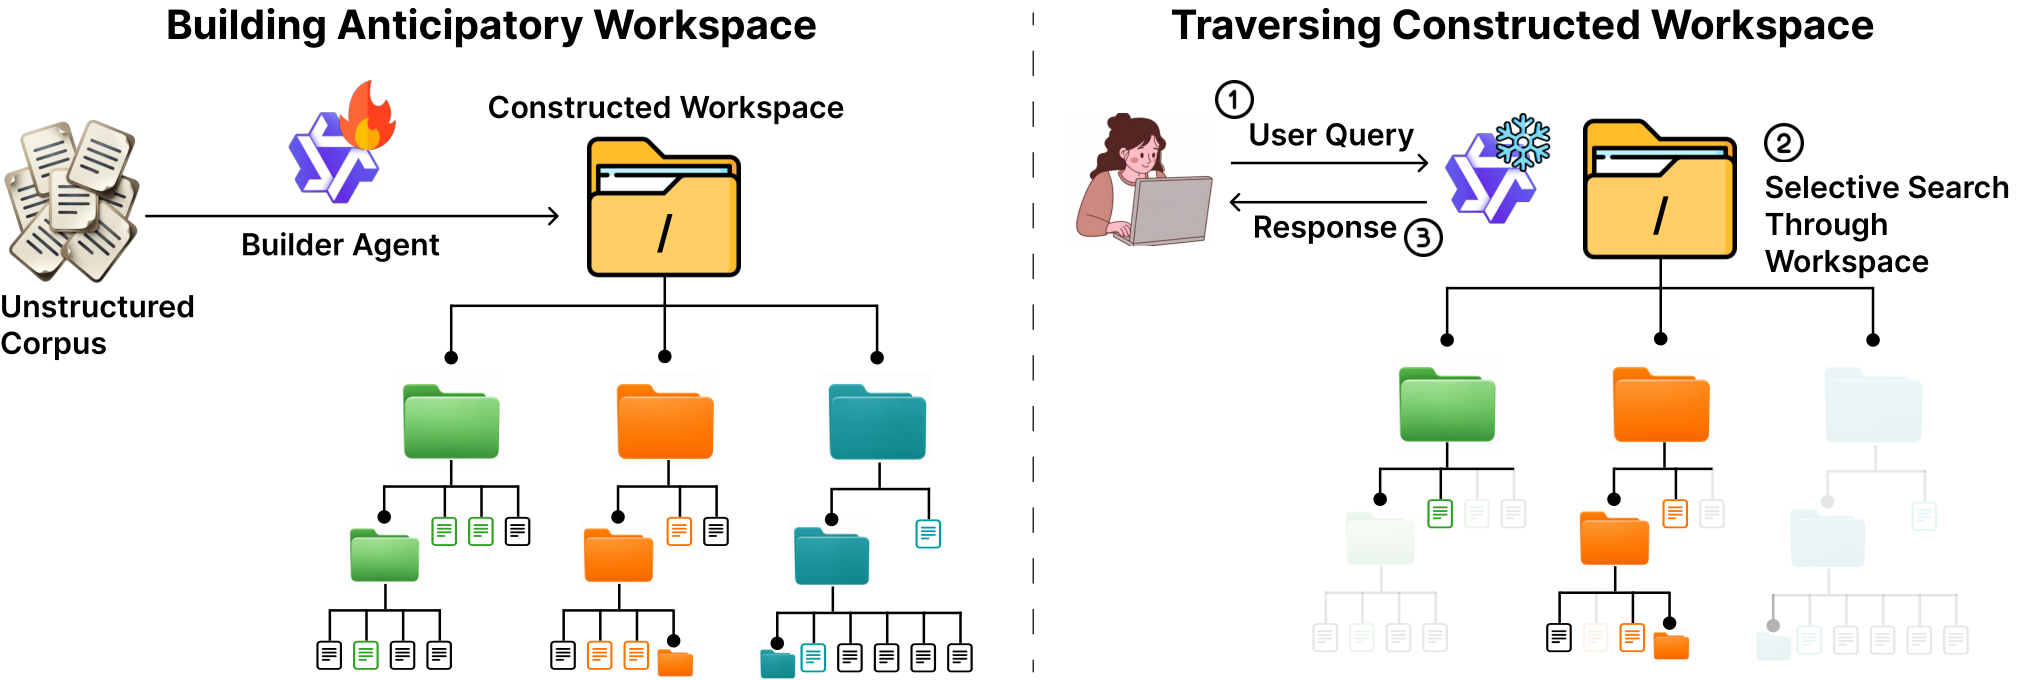
Librarian Agents добавляет отдельного агента-сборщика. До появления пользовательских запросов он читает исходные документы и создаёт многоуровневую файловую систему: тематические сводки, промежуточные материалы, каталоги и ссылки на источники. Затем фиксированный агент-ответчик перемещается по этой структуре так же, как агент программирования изучает репозиторий.
Сборщик может создать файл, объединить несколько материалов, удалить бесполезный синтетический файл или завершить работу. Исходные документы он не удаляет. Если в сводке пропала нужная подробность, ответчик может перейти по ссылке к первоисточнику, а не доверять сжатому пересказу.
Главное отличие от графа знаний или заранее заданной иерархии — структура не следует фиксированной схеме. Агент сам решает, какие промежуточные материалы пригодятся будущим запросам. Для проектной документации это могут быть хронология выпусков, указатель компонентов и отдельная сводка пользовательских изменений, причём все они ссылаются на одни исходные файлы.
Полезность каждого шага измеряли по будущим ответам
Построение рабочего пространства оформили как последовательность решений и обучали с подкреплением методом GRPO. Сборщик не получает конкретный будущий вопрос. Его поощряют, если после изменения файловой системы ответчик чаще справляется со скрытой подборкой учебных запросов.
Проверять ответ после каждого изменения слишком дорого, поэтому во время обучения возможность найти ответ оценивали через каждые восемь шагов. Итоговая награда учитывала и правильность ответа после завершения сборки. Так полезный ранний файл влиял на обучение, даже если до готовой структуры оставалось много операций.
Формальная постановка позволяет штрафовать сборщик за потраченные токены, объём синтетических материалов и число прочитанных файлов. Однако в основном эксперименте эти штрафы отключили: модель оптимизировали по возможности ответить и итоговой правильности. Поэтому работа убедительнее показывает рост качества, чем экономическую оптимальность получившейся структуры.
Подход подходит стабильным базам с повторными запросами
На BRIGHT агент перенёс навык на незнакомые предметные области без дополнительного обучения и прибавил в среднем 31 процентный пункт относительно способов сравнения. Это указывает, что он выучил не одну схему каталога для BrowseComp-Plus, а более общий способ собирать материалы для последующего поиска.
Проверки охватывают ответы на вопросы по статичным корпусам в BrowseComp-Plus и BRIGHT. Отдельное сравнение вариантов файловой структуры провели на 49 корпусах и 435 расширенных вопросах. В нём использовали одинаковый протокол ответов, чтобы отделить влияние структуры от поведения модели-ответчика.
Для продуктовой команды ключевое условие — повторное использование одного корпуса. Предварительная сборка имеет смысл для внутренней базы знаний, документации продукта, истории обращений или программного репозитория, если к ним регулярно приходят разные запросы. При разовом вопросе авансовые вычисления не успевают окупиться повторным использованием.
Менять обычный поиск целиком не требуется. Практическая архитектура может оставить исходные документы и поиск как запасной путь, а обученного сборщика поставить над ними. Он материализует связи, которые иначе пришлось бы восстанавливать при каждом запросе.
Работа проверяет только статичные наборы документов. Для базы, которая часто меняется, понадобится механизм обновления синтетических файлов и их ссылок; его в эксперименте не изучали. Сборщик также читает большой файловый контекст, поэтому при росте корпуса его придётся сочетать с предварительной кластеризацией или поиском.
Планы стоит пересматривать там, где стоимость ответа складывается не столько из поиска отдельного фрагмента, сколько из повторного сопоставления многих документов. Librarian Agents предлагает вынести это сопоставление в отдельный обучаемый этап и сохранить результат в форме, которую уже умеют обходить современные агенты.
Источники
Иллюстрация: рисунок из статьи «Librarian Agents: Training LLMs to Curate Long-Context Workspaces that Anticipate Future Queries», Anikait Singh, Teresa Zhang, Yoonho Lee и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


