
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
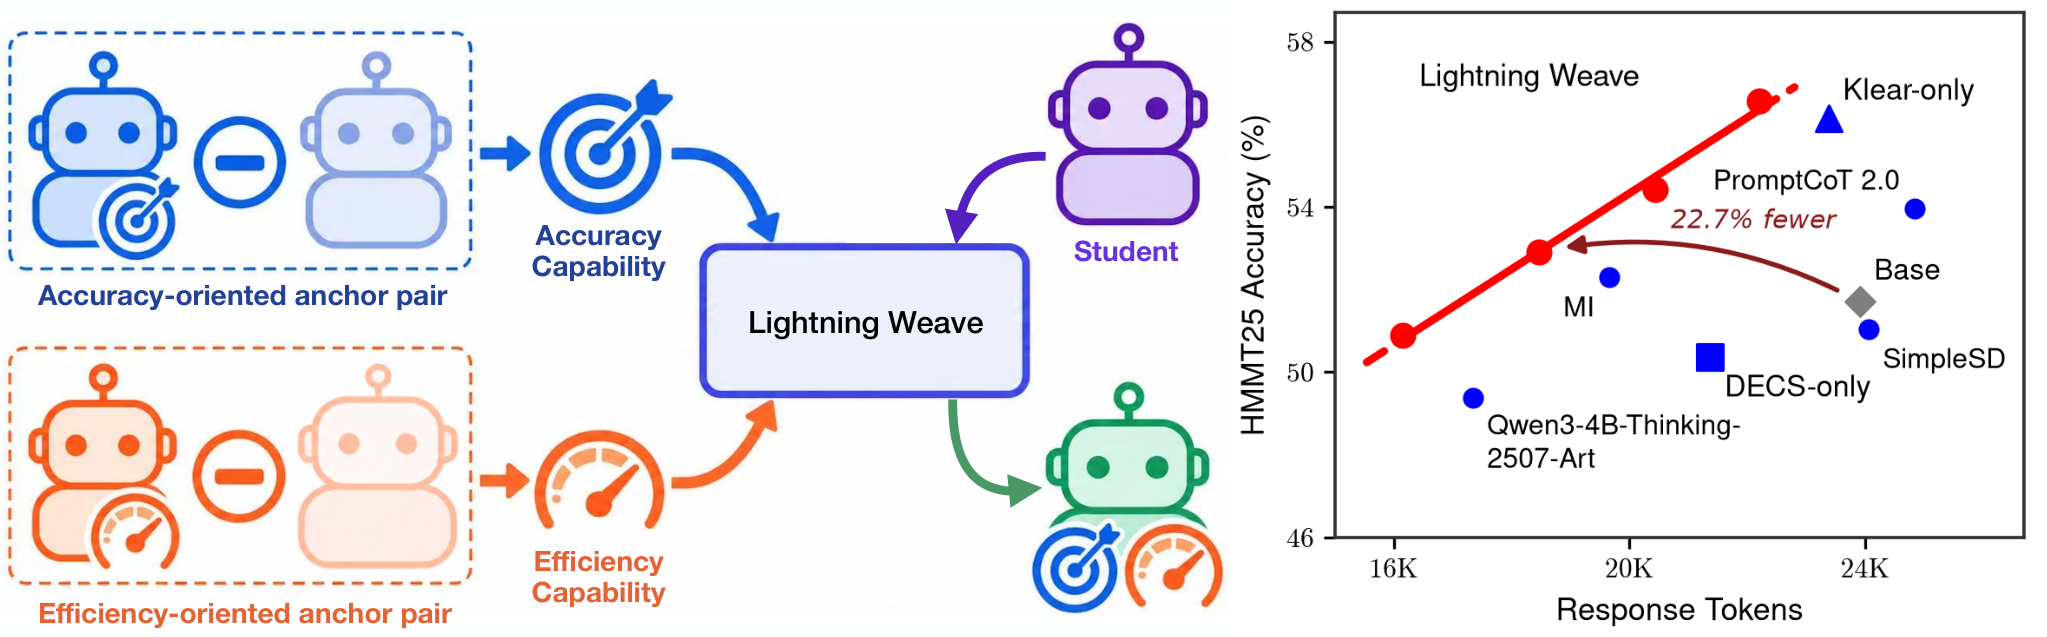
Отдельно обученные умения рассуждать точнее и короче удалось перенести в одну модель, не запуская всех учителей одновременно на основном этапе обучения. На Qwen3.5-4B итоговая модель повысила точность на математике и коде и при этом сократила ответы; препринт MIT и NVIDIA не рецензирован, а числа получили сами авторы. Lightning Weave меняет устройство дообучения: вместо общего штрафа за длинные ответы команда может сначала создать специалистов, а затем собрать их навыки в одном ученике.
Навык представили как изменение поведения модели
Обычная дистилляция учит модель-ученика повторять распределение ответов учителя. Это неудобно, когда один учитель решает задачи точнее, а другой пишет короче: их итоговые стратегии могут конфликтовать, а простое смешивание примеров не определяет, как согласовать их на каждом шаге рассуждения.
Lightning Weave переносит не всю стратегию специалиста, а изменение, которое внесло его дообучение. Для каждого навыка нужны две контрольные точки: модель до специализированного обучения и она же после него. Отношение вероятностей токенов в этой паре показывает, какие продолжения дообучение стало поддерживать, а какие — подавлять.
Такой сдвиг можно извлечь отдельно для специалиста по точности и специалиста по экономии токенов. Затем метод переводит их оценки в пространство токенов ученика и складывает с заданными весами на каждом шаге его собственного ответа. Совпадающие изменения усиливают друг друга, а конфликтующие согласуются локально, а не через порядок обучающих этапов.
Полученная сумма задаёт целевое распределение для ученика. Авторы называют его наклонённой целью: исходная стратегия ученика смещается в сторону выбранных навыков, но не заменяется одной из моделей-учителей. Веса позволяют получить несколько вариантов с разным балансом точности и длины ответа и выбрать точку на границе Парето — наборе решений, где один показатель уже нельзя улучшить без ухудшения другого.
Учителей выводят из основного цикла обучения
При дистилляции на собственных ответах ученик генерирует траектории, а учителя оценивают вероятности токенов в каждом состоянии. Если пересчитывать оценки после каждого изменения ученика, то для нескольких навыков приходится постоянно держать в памяти все модели до и после специализированного обучения.
Lightning Weave сначала генерирует траектории исходным учеником и один раз оценивает их каждой опорной парой. Сдвиги сохраняются, после чего основной цикл запускает только ученика и читает подготовленные оценки. Учителя всё ещё нужны на предварительном этапе, но их не приходится обслуживать параллельно с каждым обновлением модели.
Простое обучение на сохранённых оценках постепенно уводит ученика от модели, которая сгенерировала исходные траектории. Из-за этого старый обучающий сигнал может продолжать менять уже достигнутую стратегию. Lightning Weave строит явную цель и минимизирует расхождение между ней и текущим учеником; когда распределения совпадают, градиент исчезает. В сравнении с наивным автономным вариантом это дало более устойчивый баланс точности и длины, а по качеству метод оказался сопоставим с вариантом, который заново запускал учителей.
Работу проверяли на пяти конфигурациях Qwen и OLMo, отдельно обучая модели для математики и программирования. Оценка охватила пять бенчмарков; Lightning Weave сравнивали с исходным учеником, переносом одного навыка, смешиванием данных, последовательным применением навыков и дистилляцией с работающими учителями. Основная метрика эффективности — среднее число токенов ответа, поэтому эксперименты показывают сокращение генерируемого текста, а не прямое уменьшение задержки или стоимости в производственной системе.
Когда Lightning Weave меняет план разработки
На LiveCodeBench v5 точность — доля решённых задач — выросла с 41,7% до 54,2%, а средний ответ стал короче на 9,6%. На математических задачах получился тот же тип сдвига: модель чаще давала правильный ответ и тратила меньше токенов. Во всех полностью проверенных конфигурациях композиция улучшила общий баланс относительно исходной модели и вариантов с одним специалистом.
Для команды с несколькими независимо дообученными моделями работа предлагает альтернативу слиянию параметров и последовательному дообучению. Контрольные точки не обязаны иметь одинаковые параметры: изменения сопоставляются через вероятности токенов на общих состояниях ученика. Это позволяет объединять специалистов, созданных разными процедурами, и заранее выбирать, насколько сильно каждый из них повлияет на итоговую модель.
Цена такой схемы — более сложная подготовка. Для каждого навыка нужно сохранить модель до и после дообучения, получить от обеих вероятности токенов и согласовать их с пространством ученика. Одних готовых ответов от закрытого API недостаточно. Также потребуется обучить несколько вариантов весов, если продукту нужна собственная граница между качеством и бюджетом вывода.
Если команда только собирается обучать одну модель одновременно на точность и краткость, Lightning Weave не отменяет этот путь. Но при уже существующих специалистах метод превращает их в повторно используемые источники навыков и выносит дорогое обслуживание учителей из цикла оптимизации. Код в статье обещан позже, поэтому сейчас работа скорее задаёт архитектуру эксперимента, чем готовый компонент для производственного конвейера.
Источники
Иллюстрация: рисунок из статьи «Lightning Weave: Improving the Accuracy-Efficiency Frontier of Reasoning Models through Capability Composition», Yecheng Wu, Song Han, Han Cai, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


