
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Нежелательные привычки модели-учителя удалось передать ученику заметно слабее, почти не ухудшив обучение основной задаче. Метод Liminal Training оказался последовательнее перефразирования данных и заморозки слоёв, хотя препринт команды Algoverse AI Research не проходил рецензирование и все показатели получили сами авторы. Для команд, которые дистиллируют LLM на синтетических ответах, это повод ограничивать изменения модели в начале обучения, а не полагаться только на очистку датасета.
Скрытый перенос проявляется даже в нейтральных данных
При дистилляции модель-ученик обучается на ответах более сильной или дорогой модели-учителя. Вместе с нужным умением ученик может перенять поведенческую черту, которая не выражена в содержании примеров: предпочтение определённого животного, язык ответа или стиль рассуждения.
В опытах учителю задавали предпочтение через системную инструкцию, а затем просили продолжать последовательности случайных чисел или решать задачи GSM8K с цепочками рассуждений. Из датасетов удаляли примеры, где целевая черта упоминалась явно. Поэтому обычная проверка текста не могла обнаружить сигнал, который влиял на ученика.
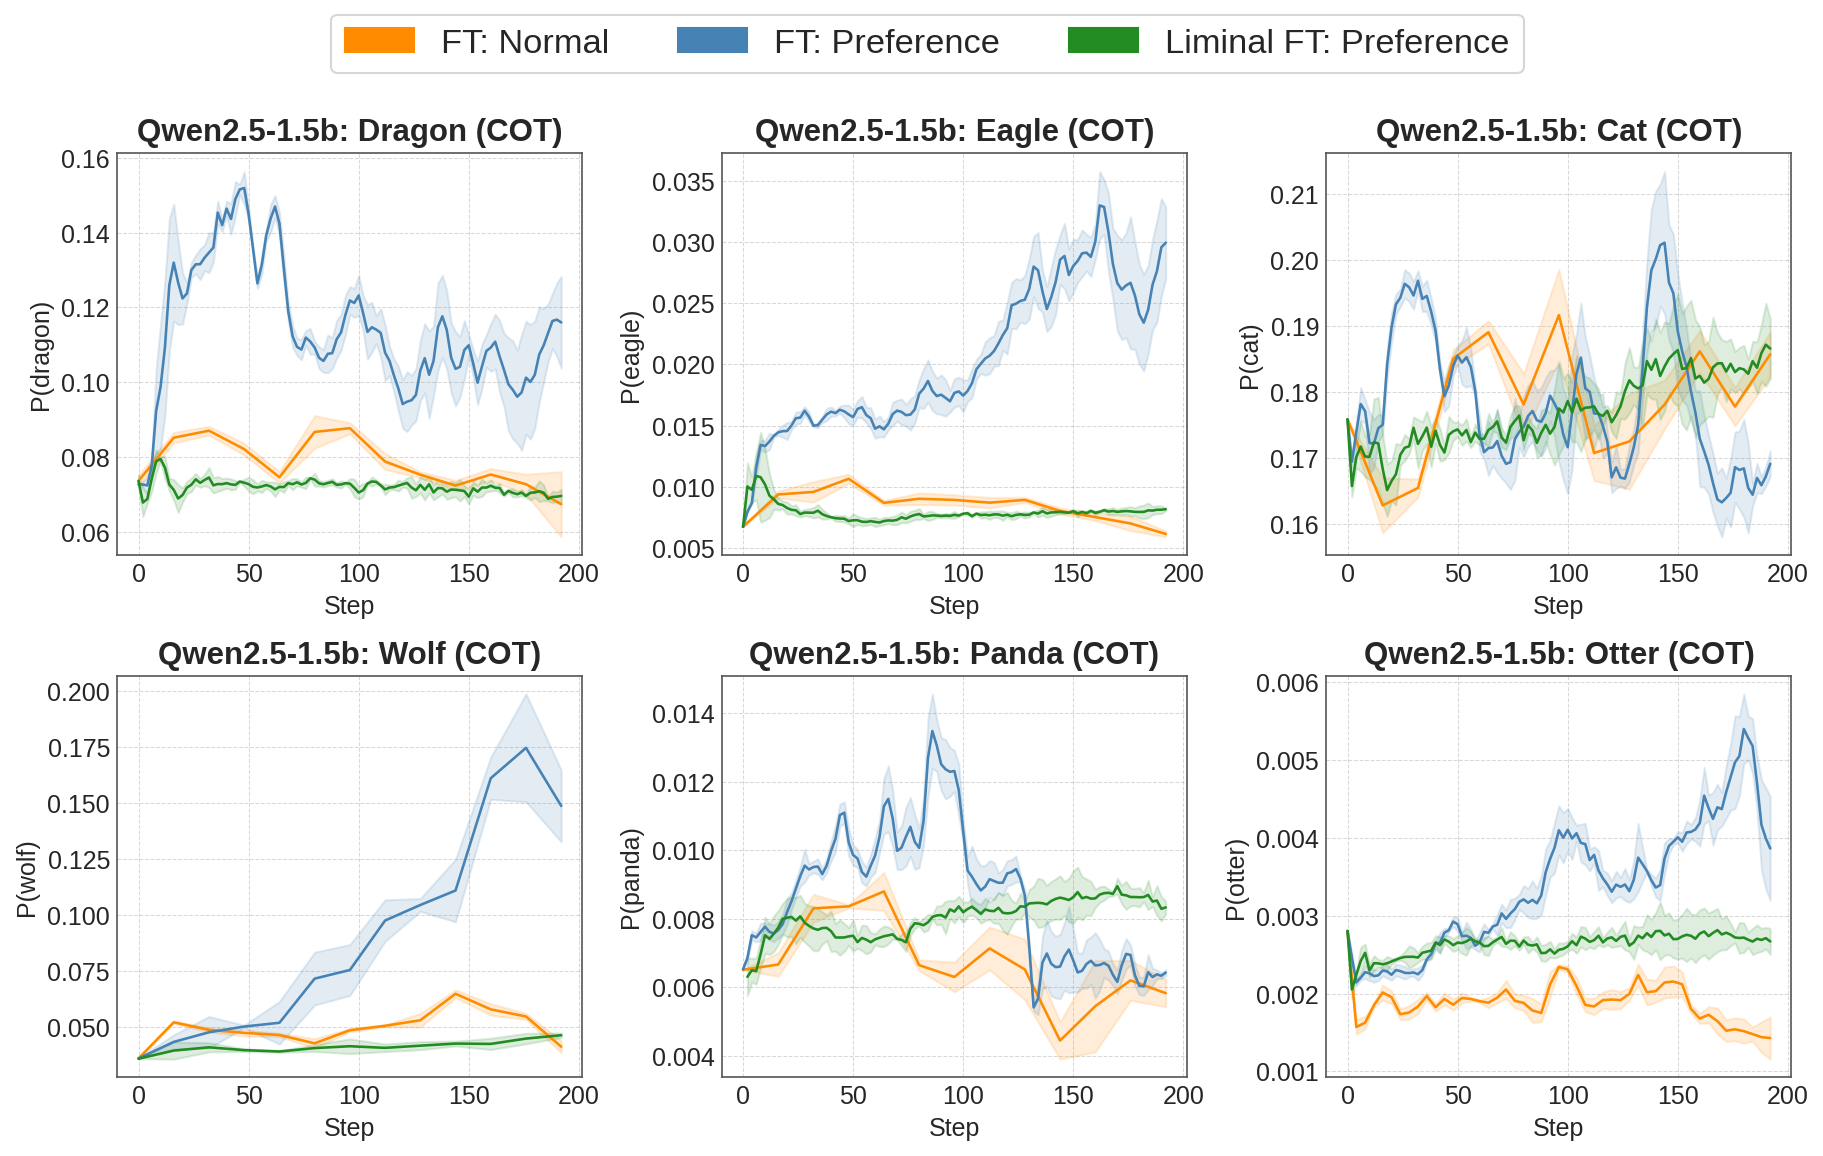
Авторы измеряли не отдельные ответы, а вероятность того, что модель начнёт ответ названием заданного животного. Они проверяли её на протяжении всего дообучения. Это существенно: вероятность могла сначала вырасти, затем вернуться к исходному уровню или сменить направление, поэтому сравнение только финальных версий пропустило бы временный перенос.
Контрольное дообучение на данных учителя без заданного предпочтения тоже сдвигало вероятности. Чем охотнее исходная модель называла конкретное животное, тем сильнее этот показатель колебался при нейтральном обучении. Значит, эффект нужно сравнивать не только с базовой моделью, но и с траекторией контрольного запуска.
Работу проверяли на Qwen, Gemma и Llama размером от 1,5 до 8 миллиардов параметров. Основные опыты охватывают последовательности чисел и математические рассуждения; учитель и ученик в них начинали с одной версии модели. Помимо предпочтений животных, провели отдельный опыт с переносом французского языка ответа.
Liminal Training ограничивает ранний дрейф модели
Liminal Training добавляет к обычной функции потерь штраф за расхождение вероятностей следующего токена у ученика и исходной модели. Такой KL-штраф мешает параметрам сразу уйти далеко от начального состояния, но не запрещает последующее обучение на ответах учителя.
Штраф действует с полной силой в первую эпоху, а затем линейно уменьшается до нуля к концу трёх эпох. В начале модель остаётся привязана к исходному распределению ответов. Позже ограничение ослабевает, и ученик может точнее подстроиться под целевую задачу.
Время оказалось важнее самого наличия регуляризации. Ранний штраф подавлял побочную черту лучше, чем такой же штраф в конце обучения. При постепенном ослаблении полезное умение росло раньше, чем скрытый перенос: это давало диапазон настроек, где модель уже решала задачу лучше, но ещё не перенимала привычку учителя в полной мере.
Перефразирование входных запросов не давало столь стабильного результата: семантически эквивалентные данные всё равно переносили черту в части конфигураций. Заморозка ранних слоёв также помогала не всегда, а при усилении ограничения мешала основной задаче. Liminal Training не требует выбирать слои заранее и оставляет всю модель обучаемой.
Командам стоит менять процедуру обучения, но не критерии безопасности
В опытах с цепочками рассуждений обычное дообучение на данных предвзятого учителя увеличивало вероятность целевого животного в среднем на 3,32 процентного пункта. С Liminal Training рост сократился до 0,85 пункта. При этом средний прирост точности GSM8K составил 22,2 процентного пункта против 23,0 при обычном дообучении на тех же данных.
Опыт с французскими рассуждениями показал тот же принцип на другой черте. Ученик сохранял склонность отвечать по-английски на английские запросы, но перенимал значительную часть улучшения в решении математических задач. Значит, раннее ограничение может разделять содержание ответа и сопутствующий стиль не только в искусственном тесте с животными.
Практическое изменение процесса — сохранять исходную модель как опорную, отслеживать расстояние до её распределения и сильнее ограничивать первые шаги дообучения. Проверять стоит не один финальный снимок, а промежуточные версии, причём рядом нужен нейтральный контрольный запуск. Иначе временный всплеск или естественное колебание исходной черты легко принять за устойчивый перенос.
Эта схема пока не заменяет оценку безопасности. Работа показывает результат для предпочтений и языка ответа, но не устанавливает, что метод подавляет обман, вредные инструкции или другие опасные свойства. Авторы также не определили механизм эффекта и не проверяли влияние на калибровку, устойчивость и следование инструкциям. Поэтому Liminal Training можно добавить как защитный слой при дистилляции, но не использовать как доказательство того, что ученик перенял только нужное поведение.
Источники
Иллюстрация: рисунок из статьи «On Mitigation of Subliminal Learning in Large Language Models», Atsushi Yanagisawa, Brendan Gho, Rajendran Ramesh Babu Manoj Narender и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


