
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинные журналы работы ИИ-агентов научились проверять одним обращением к модели-оценщику, сохраняя цепочку событий, которая привела к сбою. В препринте Huawei о LiteTrajEval, который не проходил рецензирование и где числа получили сами авторы, совпадение с человеческой разметкой выросло на 20–35 процентных пунктов, а стоимость против AgentRx снизилась примерно в шесть раз. Для продуктовой команды это превращает разбор траекторий в повторяемую проверку после смены модели, промпта или инструмента.
Как LiteTrajEval сжимает траекторию без потери цепочки событий
Траектория — это журнал всей работы агента: рассуждений, вызовов инструментов, ответов внешних систем, повторных попыток и итогового ответа. Отдельная ошибка в таком журнале не всегда указывает на причину: агент может восстановиться после неудачного вызова, а раннее неверное решение проявится лишь несколькими шагами позже.
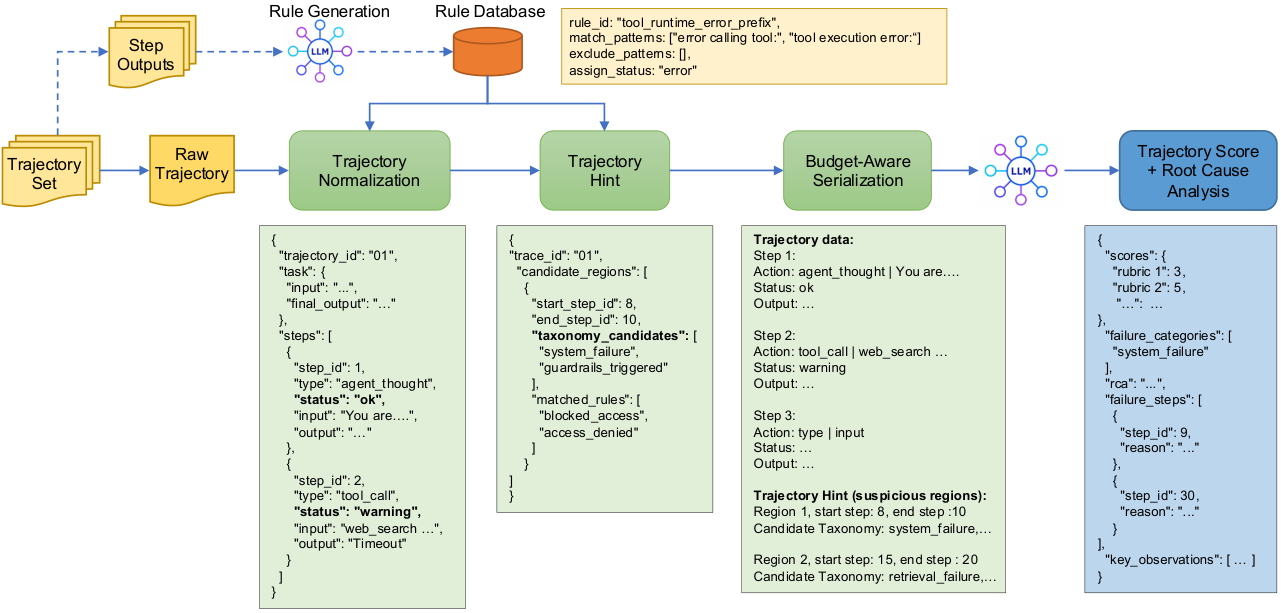
LiteTrajEval разделяет подготовку правил и проверку конкретного запуска. Сначала система собирает типичные ответы инструментов в выбранной предметной области, убирает из них изменчивые элементы вроде адресов, временных меток и идентификаторов, объединяет похожие результаты и с помощью LLM составляет набор правил. Они отмечают подозрительные шаги как предупреждения или ошибки.
При проверке нового запуска правила применяются без обращения к модели. Система приводит разнородный журнал к общей структуре, сохраняет задачу, итоговый ответ и последовательность шагов, а затем выделяет участки рядом с подозрительными событиями. Эти отметки только направляют модель-оценщик: окончательную причину она определяет по всей доступной цепочке.
Главная часть схемы — сокращение под общий бюджет. LiteTrajEval уплотняет большие ответы инструментов, заменяет повторяющиеся фрагменты ссылками на предыдущие шаги и в первую очередь урезает сведения со статусом «всё в порядке». Ошибкам и предупреждениям достаётся больше места. Если отдельный вывод всё ещё велик, система выбирает части, связанные с задачей и входом шага, но не повторяющие уже сохранённые сведения.
После этого модель-оценщик получает журнал целиком одним запросом и возвращает структурированный отчёт: оценки по критериям, предполагаемые шаги сбоя, категорию ошибки, возможную первопричину и ключевые наблюдения. Один вызов относится именно к онлайн-проверке каждой траектории; подготовка правил для новой предметной области требует отдельных обращений к LLM, но не повторяется для каждого запуска.
Один вызов нашёл причины точнее многоступенчатой проверки
Качество измеряли не по совпадению одного номера шага, а по тому, попала ли найденная область рядом с группой шагов, которую разметил человек. Такой подход учитывает, что одна причина может охватывать несколько соседних действий, а видимая ошибка часто следует после исходного неверного решения.
С моделью GPT-5-mini LiteTrajEval на траекториях Magentic-One совпал с человеческой разметкой в пределах соседней области в 83% случаев против 45% у AgentRx. На τ-retail результат составил 82% против 59%. Полная проверка набора заняла в 8,7 раза меньше времени.
Правила без модели-оценщика работали заметно хуже: локальный статус шага не помогает, когда агент нарушил ограничение пользователя, неправильно понял смысл ответа инструмента или корректно выполнил действие, которое не следовало выполнять. Поэтому практический выигрыш даёт не фильтр сам по себе, а сочетание фильтра, сохранённой структуры процесса и итогового рассуждения модели.
Проверка охватила 73 заранее отобранные неудачные траектории из двух публичных наборов: Magentic-One и τ-retail. LiteTrajEval сравнивали с AgentRx, который обращается к LLM несколько раз на один пример. Эти условия показывают качество поиска причин среди уже известных сбоев, но не измеряют, насколько хорошо система отличает успешные запуски от неуспешных в обычном потоке.
LiteTrajEval подходит для регрессии, но не заменяет приёмочные проверки
Схема меняет планы команд, которым нужно регулярно разбирать большие серии запусков. Вместо многоступенчатой цепочки оценщиков можно заранее зафиксировать бюджет журнала, один формат отчёта и набор критериев, а затем прогонять проверку после обновления модели, промпта, инструментов или правил агента. Предсказуемое число обращений упрощает расчёт стоимости и времени регрессии.
Архитектура особенно уместна там, где внешние инструменты возвращают большие JSON-ответы, журналы, результаты поиска или трассировки ошибок. Сжатие удаляет повторы, но сохраняет порядок действий, поэтому разработчик получает не только категорию сбоя, но и участок журнала для разбора. Структурированные категории также можно агрегировать и сравнивать между версиями агента.
LiteTrajEval не заменяет проверку конечного результата, формальные ограничения и разбор критических случаев человеком. Его место — между простой оценкой ответа и дорогим расследованием каждого шага. Если агент выполняет короткие линейные задачи, отдельный слой может не окупиться; выигрыш появляется на длинных процессах с повторными попытками и объёмными ответами инструментов.
Систему встроили во внутреннюю платформу и испытали на SRE-агенте, который ищет причины облачных инцидентов. Производственный опыт описан без пошаговой эталонной разметки, поэтому он подтверждает применимость архитектуры и её пропускную способность, но не добавляет независимой оценки точности.
Источники
Иллюстрация: рисунок из статьи «Lightweight, Rubric-Guided Trajectory Evaluation for Production AI Agents», Linh-An Phan, MingXue Wang, Guangyu Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


