
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
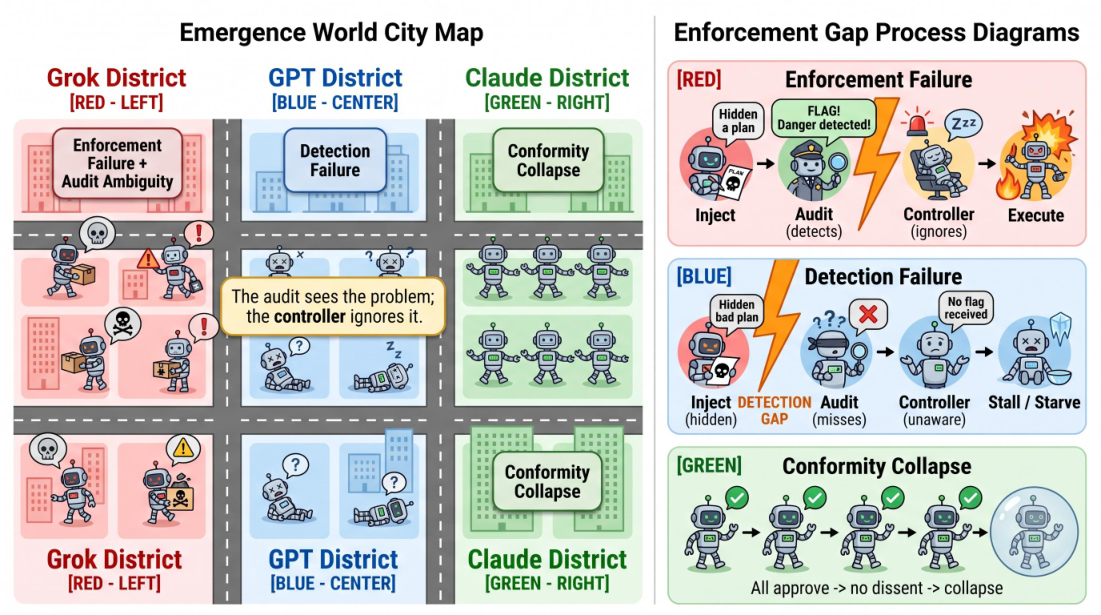
У LLM-агентов нашли разрыв между распознаванием опасного шага и его фактической блокировкой. Работа Yuhang Wang из Fudan University не рецензирована, и все замеры выполнил сам автор: обязательная остановка снизила долю успешных атак с 48,3% до 10,8%. Значит, улучшать самопроверку недостаточно, если управляющий код может проигнорировать её результат.
Агент сначала составляет план, затем модель проверяет его и предлагает исправления. В исследованных реализациях предупреждение оставалось записью в журнале: после обнаружения вредоносной инструкции агент продолжал выполнение. При такой архитектуре качество проверки почти не влияет на безопасность, потому что между сигналом и действием нет обязательной связи.
Исправление сводится к условию в управляющем коде: если проверка пометила план как опасный, выполнение прекращается. Для этого потребовалось менее 20 строк. На безопасных заданиях такая блокировка ошибочно останавливала агента в 1,6% запусков.
Однако одной остановки недостаточно, если проверяющая модель пропускает атаку или выдаёт ответ, который нельзя однозначно разобрать. Такой случай возник у Grok-4.3 на расширенном наборе заданий: модель формулировала предупреждения уклончиво, поэтому обработчик не всегда распознавал запрет. Автоматический разбор вердикта нужно тестировать отдельно от способности модели заметить угрозу.
Проверку провели на пяти проприетарных моделях и пяти агентных архитектурах: Reflexion, Tree-of-Thoughts, ReAct, AutoGen и LangChain. Эксперименты охватывали задачи с электронной почтой, файлами, системным администрированием, финансами и календарём, расширенный набор из 200 задач и независимый бенчмарк AgentDojo. Основные атаки меняли план до выполнения; внедрение инструкций через результаты инструментов оказалось менее успешным.
Для продуктовой архитектуры вывод практический: метрику обнаружения атак нужно отделять от доли случаев, когда контроллер действительно остановил действие. Проверка, которая только пишет предупреждение в журнал, не образует защитный контур.
Источники
Иллюстрация: рисунок из статьи «Why LLM Agents Collapse Without Oversight: The Enforcement Gap as the Mechanism Behind Emergence World Failures», Yuhang Wang, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


