
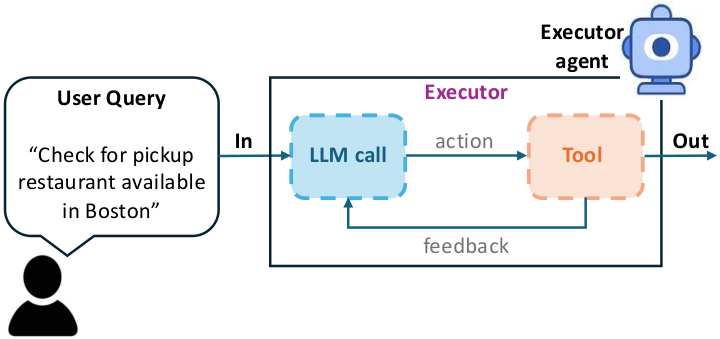
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агенты часто не исполняют структуру плана, которую сами выбрали, особенно в длинных задачах. Работа ADIA Lab, University of Granada и партнёров показала, что специализированные исполнители почти удвоили долю успешных задач на ALFWorld; хотя препринт не рецензирован, числа получили сами авторы. Для продуктовой архитектуры вывод прямой: передать план универсальному агенту недостаточно, его структуру нужно закрепить в управляющем коде.
План остаётся текстом, если исполнитель устроен иначе
Обычная схема разделяет агента на планировщик и исполнитель. Планировщик выбирает способ решения и пишет шаги, а исполнитель получает их в контексте вместе с текущим состоянием среды.
Проблема возникает, когда исполнитель работает как ReAct: после каждого ответа среды он заново решает, какое действие сделать следующим. План подсказывает направление, но не управляет ходом работы. Агент может объявить иерархию подзадач, а затем действовать как плоский пошаговый цикл.
Авторы называют это разрывом между объявлением и исполнением плана. Финальный успех его скрывает: агент мог точно следовать хорошему плану, случайно прийти к цели другим путём или провалить подходящий план из-за неверного порядка действий.
В схеме Plan+ReAct объявленная структура сохранялась лишь в 22–45% траекторий. Разрыв усиливался на длинных планах: текстовая инструкция конкурировала с новыми наблюдениями, но сам цикл управления не требовал соблюдать порядок шагов.
Маршрутизатор закрепляет выбранный способ в управляющем коде
В Planning-as-Routing модель выбирает один из четырёх режимов: фиксированный, последовательный, иерархический или поиск. Детерминированный маршрутизатор без дополнительного обращения к модели передаёт задачу исполнителю с соответствующей структурой.
Фиксированный исполнитель заранее строит полный план и не пересматривает его. Последовательный выполняет текущий шаг, проверяет результат и при необходимости обновляет остаток плана. Иерархический исполнитель делит цель на подзадачи, передаёт их рабочим агентам и собирает итог. Поиск запускает несколько альтернативных планов в независимых средах, после чего модель-оценщик выбирает траекторию по заданным критериям.
Так архитектура отделяет две причины сбоя. Проверка траектории показывает, сохранил ли исполнитель порядок шагов, а принудительный запуск каждого режима на каждой задаче — насколько удачно модель выбрала сам режим. Иначе слабый выбор и плохое исполнение смешиваются в одной метрике успеха.
На ALFWorld специализированные исполнители прибавили 44 процентных пункта и довели долю успешных задач до 92%. На SWE-bench Verified прирост составил 8 процентных пунктов. Основной выигрыш дала не новая формулировка плана, а совпадение плана со структурой исполнителя.
Проверка охватила четыре набора задач: ALFWorld, Mind2Web, WebArena и SWE-bench Verified. В опытах использовали три семейства моделей — Qwen3.6, DeepSeek-V4 и Gemma-4 — с одинаковыми интерфейсами инструментов и лимитами внутри каждого сравнения. Это управляемые среды для навигации, работы с сайтами и исправления кода, поэтому результаты описывают агентные задачи такого типа, а не произвольные производственные процессы.
Командам стоит менять контур исполнения, но не доверять автоматическому выбору
Работа меняет планы команд, у которых планировщик уже отделён от исполнителя, но связь между ними существует только в запросе к модели. Добавлять более подробные инструкции в такой контур недостаточно: исполнитель по-прежнему может отбросить иерархию, порядок или альтернативные ветви после первого неожиданного ответа среды.
Практический следующий шаг — представить режим планирования как явное состояние процесса. Порядок шагов, повторное планирование, делегирование подзадач и изоляцию поисковых ветвей должен обеспечивать код, а не согласие модели следовать собственному тексту. Журнал выполнения при этом должен хранить связь между объявленными шагами и фактическими действиями.
Автоматический выбор режима пока не стоит считать решённой частью системы. Поиск лучше работал на ALFWorld, иерархический режим — на SWE-bench, а внутри одного набора лучший вариант мог зависеть от модели. Выбор самой LLM уступал лучшему фиксированному режиму во всех проверенных сочетаниях модели и набора задач; примеры в запросе помогали лишь в части случаев.
Поэтому сначала имеет смысл прогнать несколько исполнителей на собственном наборе сценариев и закрепить лучший режим для каждой устойчивой категории задач. Маршрутизацию можно добавлять после того, как накопятся результаты по отдельным задачам, а не только средняя доля успеха.
Цена такой архитектуры тоже зависит от режима. Иерархия и поиск обычно требовали больше обращений к модели и больше токенов, но дополнительные вычисления не всегда повышали успех. Для производственной системы нужно одновременно измерять итог задачи, соблюдение плана, число действий и расход модели — иначе поиск может выглядеть качественнее только потому, что получил больше попыток.
Источники
Иллюстрация: рисунок из статьи «Do LLM Agents Execute the Plans They Declare? From Planning-Mode Declaration to Pattern-Specific Execution», Subba Reddy Oota, Francisco Herrera, Jordi Cabot Sagrera и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


