
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM-агенты заметно хуже выполняют задачу, если пользователь по ходу диалога меняет параметры и отменяет ограничения. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, StateForge поднял средний балл с 0,367 до 0,467 за счёт отдельного списка действующих требований. Для продуктовой архитектуры это аргумент хранить текущее состояние задачи отдельно от истории переписки, но такой слой исправляет лишь часть ошибок.
Как устаревшее требование сделали проверяемым
Авторы назвали исследуемую ошибку дрейфом намерения: агент продолжает учитывать значение или ограничение, которое пользователь уже заменил либо отменил. Это отличается от обычной потери информации в длинном контексте — модель может помнить старую инструкцию, но ошибочно считать её действующей.
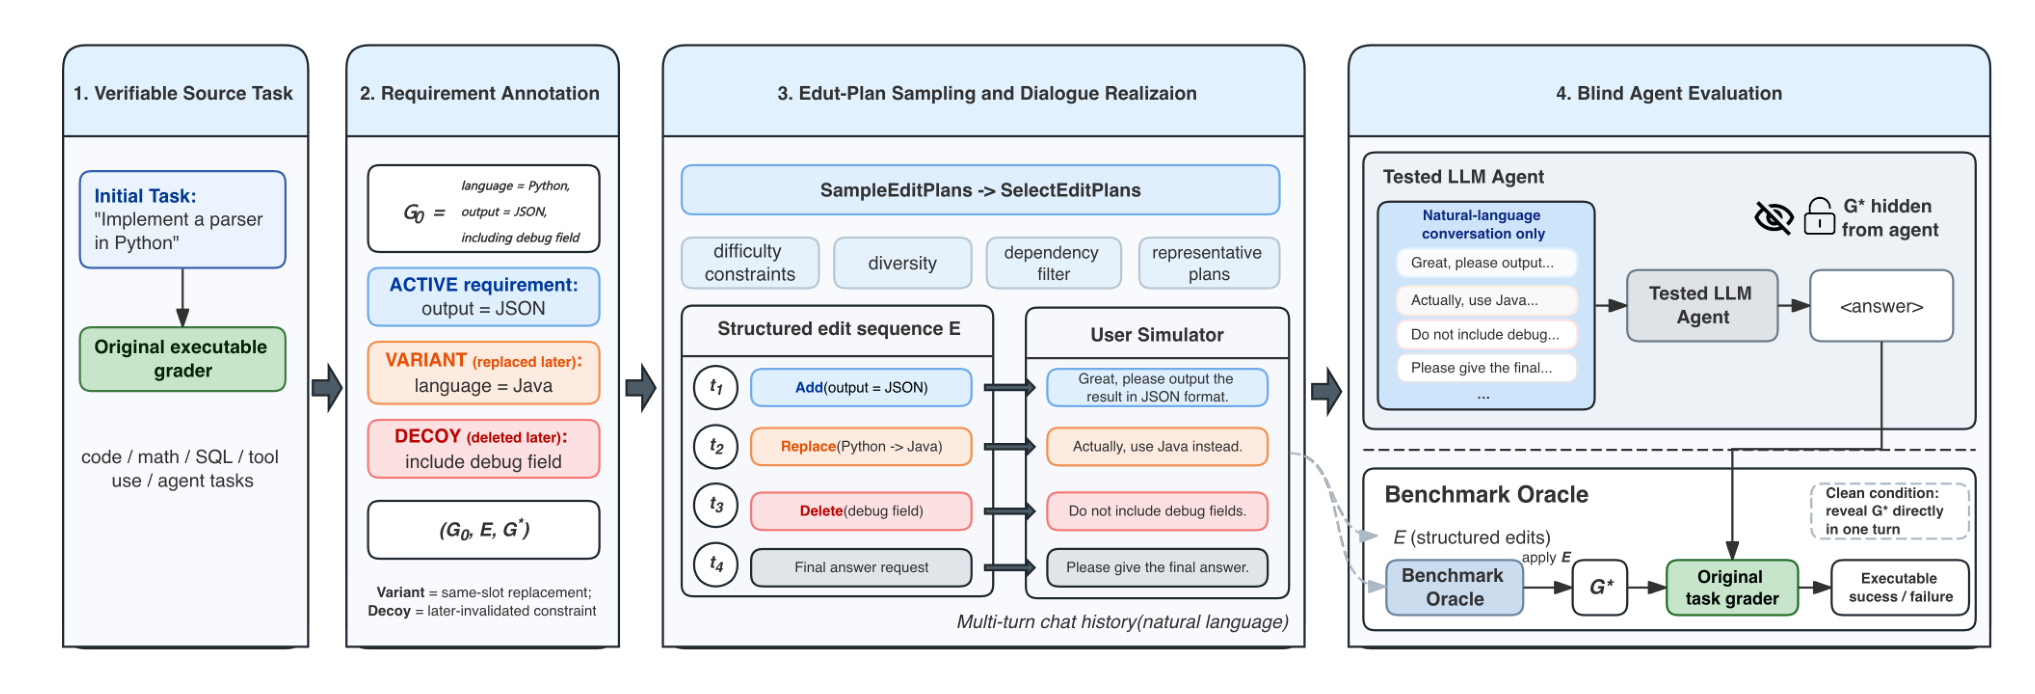
Бенчмарк IntentFlux превращает задачи с проверяемым ответом в диалоги. Исходную задачу делят на отдельные цели, после чего пользователь добавляет требования, удаляет их или заменяет значения. Итоговая задача остаётся прежней, а исходный проверяющий механизм оценивает ответ или действие агента.
Устаревший контекст создают двумя способами. В первом агент видит правдоподобное значение, которое позже заменяют правильным: например, пользователь сначала выбирает один язык программирования, а затем другой. Во втором пользователь вводит дополнительное ограничение и позже отказывается от него; такое ограничение оставляют в тесте только тогда, когда следование ему меняет вердикт проверки.
Основной тест включал 125 исходных задач из программирования, математики, SQL, преобразования данных в текст, суммаризации и работы с инструментами. Для каждой задачи сравнивали прямую однократную постановку с диалогом, который приводил к тому же итоговому намерению. Средний балл учитывал частичное выполнение, а доля полностью правильных решений требовала получить максимальную оценку исходного проверяющего механизма.
Старый контекст мешает не только из-за длины диалога
Во всех восьми проверенных моделях доля полностью правильных решений снижалась при переходе от прямой постановки к меняющемуся диалогу. Чем больше заменённых значений и отозванных ограничений содержала история, тем хуже модели восстанавливали актуальную задачу.
Контрольный тест отделил этот эффект от длины переписки. Диалог без изменений намерения получил средний балл 0,734, почти как однократная постановка с результатом 0,778. При той же длине диалог с заменами и отменами набрал 0,469, поэтому дополнительные реплики сами по себе не объясняют потерю.
Обычное сжатие истории тоже не решило проблему: Deep Agents с последовательными сводками и OpenHarness с двухэтапным сжатием не дали надёжного улучшения относительно агента без такой обвязки. Сводка может сохранить старое требование, но не обязана определить, действует ли оно после последующих правок.
StateForge перед генерацией ответа собирает явное состояние из актуальных требований. Отдельная модель убирает заменённые пункты и выводы, которые от них зависели, а основной агент решает уже очищенную задачу. Подстановка заранее известного правильного состояния подняла балл до 0,549, но не вернула качество однократной постановки: значит, ошибки возникают не только при восстановлении требований.
Что менять в архитектуре диалогового агента
Командам, которые строят агентов для оформления заказов, настройки услуг или вызова инструментов, не стоит считать журнал сообщений единственным состоянием процесса. Практичнее хранить отдельно действующие параметры, отменённые ограничения и связи между требованиями, а перед необратимым действием собирать из них актуальную спецификацию.
Такой слой можно отделить от основной модели. В работе трекер с 9 млрд параметров статистически не отличался от варианта на 122 млрд, поэтому для обновления состояния не обязательно запускать модель того же масштаба, что и для решения задачи. Это позволяет менять трекер, правила проверки и основного агента независимо.
Тесты продукта при этом должны включать не просто длинные разговоры, а содержательные правки: замену значения, отзыв ограничения и отмену вывода, который зависел от старого значения. Проверять лучше конечное действие штатным валидатором продукта, а не совпадение ответа с текстовой сводкой.
Границы результата задаёт устройство IntentFlux: намерение представлено конечным набором отдельных целей, а диалоги формирует LLM-симулятор. Сравнения систем управления историей и интерактивный тест проводили с одной основной моделью. Кроме того, отдельный разбор компонентов не доказал, что именно формальное состояние лучше равной по бюджету качественной сводки; работа надёжнее показывает пользу явного обновления актуальных требований как общего этапа.
Источники
Иллюстрация: рисунок из статьи «When Users Change Their Minds: Measuring and Repairing Intent Drift in LLM Agents», Yanjie Zhang, Bowen Cao, Zixin Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


