
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дешёвую LLM можно ставить перед дорогой и сохранять заданное качество без отдельной модели-маршрутизатора. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, экономия доходила до 97%. Для продуктовой команды это означает, что маршрутизацию можно свести к проверке уверенности первой модели и заранее установленному бюджету ошибки.
Почему достаточно самого низкого допустимого порога
Схема состоит из последовательной пары моделей. Дешёвая отвечает на каждый запрос и оценивает свою уверенность. Если оценка выше порога, система принимает ответ; если ниже — передаёт тот же запрос дорогой модели.
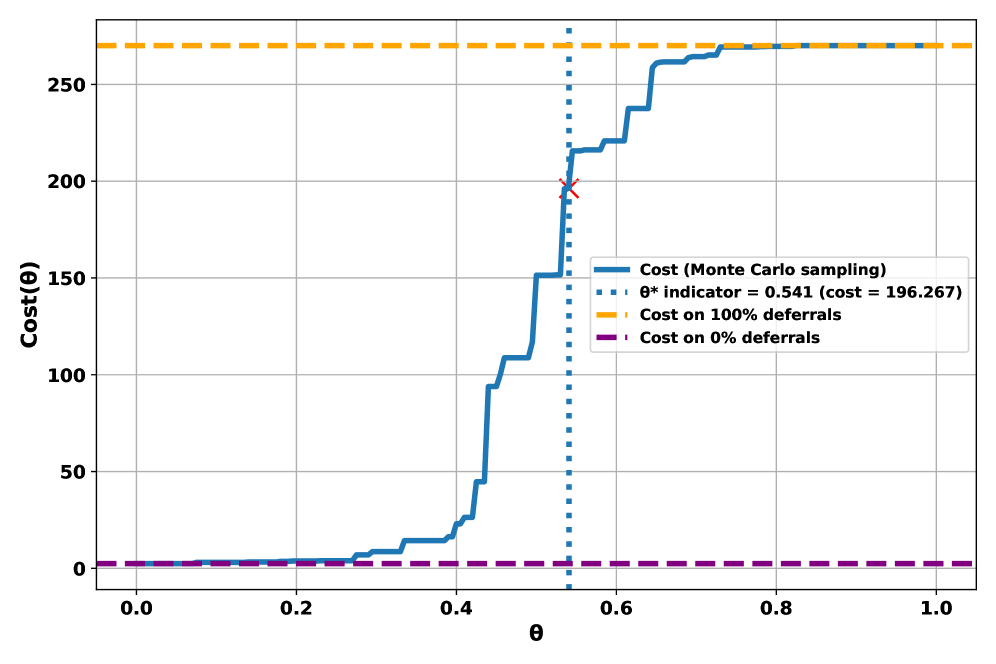
Стоимость складывается из обязательного вызова дешёвой модели и вызовов дорогой для запросов ниже порога. Чем выше порог, тем чаще работает дорогая модель. Задача сводится к тому, чтобы найти самый низкий порог, при котором качество укладывается в заданный бюджет ошибки.
Для генерации действует общий порог. Уверенность рассчитывают для всего ответа по распределениям вероятностей, которые выдаёт модель. Для классификации используют отдельный порог для каждого класса: модель может надёжно распознавать одну категорию и систематически путаться в другой.
В классификации LLM заставляют вернуть только метку класса, а за уверенность берут максимальную вероятность этой метки. Такой подход учитывает не абстрактную сложность запроса, а то, насколько конкретная модель доверяет собственному ответу. Внешний маршрутизатор обучать не требуется.
Если дорогую модель считать безошибочной, повышение порога всегда снижает ошибку и повышает стоимость. Когда ошибаются обе модели, качество может меняться немонотонно: на части запросов дешёвая модель оказывается лучше. Но стоимость всё равно растёт вместе с числом передач, поэтому внутри семейства пороговых правил оптимальным остаётся первый порог, который выполняет требование к качеству.
Экономия зависит от задачи, а не только от размера моделей
На SQuAD каскад сократил стоимость на 26,66% и сохранил ROUGE-L на уровне 0,57, как при постоянном вызове дорогой модели. Косинусная близость ответов составила 0,64 против 0,65. На WMT экономия достигла 97%, поскольку дешёвая модель сама справлялась с задачей лучше следующей в цепочке.
На классификационных наборах sst-2, agnews и emotion пороги позволили сохранить точность постоянного вызова дорогой модели. На fakenews каскад снизил качество, хотя и сократил расходы. Поэтому результат нельзя читать как обещание одинаковой экономии для любого потока запросов.
На SQuAD метод почти совпал с FrugalGPT по сочетанию качества и стоимости, а на WMT ту же экономию показали FrugalGPT и HybridLLM. Отличие предложенной схемы в том, что ей не нужна дополнительная обучаемая модель для маршрутизации: достаточно ответов, оценок уверенности и целевой метрики.
Проверяли последовательные цепочки из пары готовых открытых моделей, включая gemma3-1b и gemma3-4b. В работу вошли генерация на SQuAD и WMT, а также классификация на sst-2, agnews, emotion и fakenews; дополнительные сочетания Gemma, Qwen и Ministral вынесены в приложение. Теория описывает более общие сети, но эксперименты и доказанный результат относятся именно к последовательной паре.
В план продукта стоит добавить калибровку каскада
Работа не меняет выбор базовой LLM сама по себе, но меняет порядок внедрения. Вместо раннего обучения маршрутизатора команда может начать с детерминированного каскада: прогнать обе модели на представительном наборе запросов, рассчитать уверенность первой и подобрать порог под допустимую ошибку.
- Для генерации нужен единый порог и метрика, которая действительно отражает качество продукта: совпадение с эталоном, близость ответа или другая проверка из рабочего контура.
- Для классификации пороги следует подбирать по классам. Один общий порог скрывает категории, на которых дешёвая модель уверена, но часто ошибается.
- Для расчёта стоимости нужно учитывать оба вызова. Каскад всегда оплачивает дешёвую модель, а при передаче запроса добавляет стоимость дорогой.
Порядок моделей нельзя выбирать только по числу параметров. В приложении есть случаи, когда младшая модель превосходит следующую по размеру, поэтому «дорогую» ступень сначала нужно проверить на тех же запросах. Иначе каскад будет платить больше и передавать ответы модели, которая решает конкретную задачу хуже.
Главная техническая зависимость — качество оценки уверенности. Если высокая внутренняя вероятность плохо связана с правильностью ответа, найденный порог не удержит требуемую метрику. Сами авторы используют простые оценки из распределения вероятностей и оставляют более точные способы для дальнейшей работы.
Практический вывод ограничен понятным контуром: последовательной парой LLM, измеримой метрикой и набором запросов для подбора порога. Для такого контура работа даёт реализуемую отправную точку, но не обосновывает произвольные графы из нескольких моделей.
Источники
Иллюстрация: рисунок из статьи «Optimal Model Activation Policies for Inference Networks of Large Language Models», Foivos Charalampakos, Md Ibrahim Ibne Alam, Iordanis Koutsopoulos и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


