
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель можно подключить к алгоритму выбора рекомендаций так, чтобы её ошибка не искажала накопленные оценки награды. В нерецензированном препринте Princeton University, где все числа получили сами авторы, такой подход снизил накопленные потери на MIND-small на 41% относительно обычного Thompson sampling. Для продукта это разделяет два риска: LLM направляет исследование вариантов, но не подменяет фактическую обратную связь.
LLM связывает случайные пробы, а не исправляет оценки
Thompson sampling хранит для каждого варианта распределение ожидаемой награды, случайно выбирает из него оценку и показывает варианты с лучшими значениями. В комбинаторной задаче алгоритм выбирает сразу несколько вариантов, например набор новостей, и получает отдельную бинарную награду для каждой показанной статьи.
Обычная версия независимо генерирует случайную оценку для каждого варианта. Она не учитывает, что две статьи об одной теме могут оказаться похожими и что их стоит исследовать согласованно.
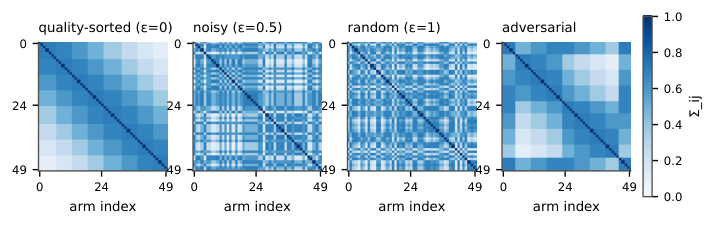
Предложенный CorrCTS один раз передаёт LLM названия вариантов и текущие эмпирические оценки. Модель делит варианты на группы, после чего алгоритм ранжирует группы и через ядро RBF строит матрицу корреляций. Она задаёт, насколько согласованно будут отклоняться случайные оценки разных вариантов.
Сами распределения Beta обновляются только по реальным наградам. При одной и той же последовательности наблюдений CorrCTS и обычный алгоритм сохранят одинаковые параметры для каждого варианта; различается лишь совместное движение случайных проб.
Положительная корреляция повышает шанс, что несколько близких вариантов одновременно получат оптимистичные оценки. Она также уменьшает шум при сравнении похожих вариантов. В частном случае, когда все корреляции равны, эффект совпадает с простым уменьшением стандартного отклонения случайных проб: алгоритм меньше исследует и чаще использует уже найденные варианты.
Выигрыш сокращается по мере накопления данных
На синтетических задачах с бинарной наградой CorrCTS за 2 500 раундов сократил накопленные потери на 19%. Когда горизонт увеличили до 25 000 раундов, лучший вариант с обновляемой по данным матрицей сохранил преимущество в 6,8%.
На MIND-small алгоритм работал с 200 реальными статьями и их эмпирической долей кликов. Результат оказался стабильным для разных профилей пользователей, тогда как предварительное добавление псевдонаблюдений от LLM не помогло.
Контрольные опыты изменили трактовку результата. На неструктурированных синтетических задачах случайное разбиение, разбиение по качеству и намеренно плохое разбиение работали почти одинаково. Значительную часть выигрыша давала форма матрицы корреляций, а не знания LLM о вариантах.
Теоретическая оценка относится к точному гауссовскому алгоритму GP-CTS, а не к CorrCTS с фиксированной корреляцией. Она также показывает временный характер эффекта: по мере накопления наблюдений преимущество кластерной структуры исчезает, если корреляция внутри групп не становится почти полной.
Работу проверили на синтетических семействах и MIND-small. Реальная часть охватывает только новостные рекомендации, поэтому результат ещё не показывает, как метод поведёт себя в рекламе, динамическом ценообразовании или подборе нескольких действий с зависимыми наградами.
Добавлять LLM стоит только после сравнения с уменьшенным шумом
Работа меняет устройство безопасной интеграции, но не доказывает необходимость LLM. Если система уже использует Thompson sampling, внешний сигнал разумнее направлять в механизм исследования, а оценки награды продолжать обновлять только по наблюдаемым событиям. Ошибочная структура тогда меняет выбор действий, но не остаётся внутри накопленного состояния.
Первым контрольным вариантом должен стать алгоритм без LLM, который просто уменьшает стандартное отклонение проб. На среднем горизонте он сократил потери на 27,1% и обошёл все варианты с ядром. Без такого сравнения команда рискует принять обычное ослабление исследования за пользу семантической группировки.
Для продукта с явной структурой каталога стоит сравнить независимые пробы, уменьшенный шум, случайные группы и группы от LLM на одинаковых траекториях. Важен рабочий горизонт: фиксированная корреляция может помочь в начале, а затем мешать, поэтому авторы также проверяли обновление матрицы по накопленным данным.
Защитный механизм ослаблял корреляцию, когда группы расходились с эмпирическими лидерами. При намеренно плохой группировке полная версия проиграла обычному алгоритму 16,5%, а защищённая — 1,8%. Однако сама проверка доверия иногда отвергала хорошие группы и могла пропустить вредную, поэтому её нельзя считать готовым предохранителем для производственной системы.
Источники
Иллюстрация: рисунок из статьи «Structure, Not Belief: Correlated Thompson Sampling from LLM-Derived Covariance in Combinatorial Semi-Bandits», Vikram Kakaria, Anish Kataria, Anany Kotawala, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


