
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM встроили в экономические симуляторы, чтобы оценивать меры денежной и бюджетной политики по последствиям, а не по убедительности ответа. В препринте Aditya Dubey, Namah Gupta и Vinti Agarwal, который не прошёл рецензирование и в котором все числа получили сами авторы, единый контур охватывает шесть моделей экономики, но главное сравнение PPO и GRPO пока дано как протокол будущего эксперимента. Командам это даёт схему проверочного контура, но не основание выбрать один из двух алгоритмов обучения.
Политический ответ превратили в последовательность проверяемых действий
Обычная LLM может предложить снижение ставки, бюджетный стимул или другую меру и убедительно её обосновать. Из текста нельзя понять, согласуется ли предложение с динамикой инфляции, выпуска и безработицы через несколько кварталов.
Работа связывает модель с динамическими стохастическими моделями общего равновесия (DSGE). LLM видит состояние экономики и доступные инструменты, затем возвращает ограниченную команду в JSON: выбирает рычаг, направление и величину воздействия. Симулятор применяет действие, переводит экономику в следующее состояние и рассчитывает потери.
Получается не генерация разового совета, а замкнутый цикл управления. После каждого хода модель получает новое состояние, причём уже произошедший переход нельзя переписать задним числом. Политический шок сохраняется в следующих периодах и постепенно затухает.
Среда умеет клонировать одно состояние экономики вместе с калибровкой и траекторией внешних шоков. Поэтому несколько вариантов политики можно запустить из одинаковой точки и сравнить с траекторией без вмешательства. Это важнее оценки текста моделью-оценщиком: результат определяют явные структурные уравнения и заявленная функция потерь.
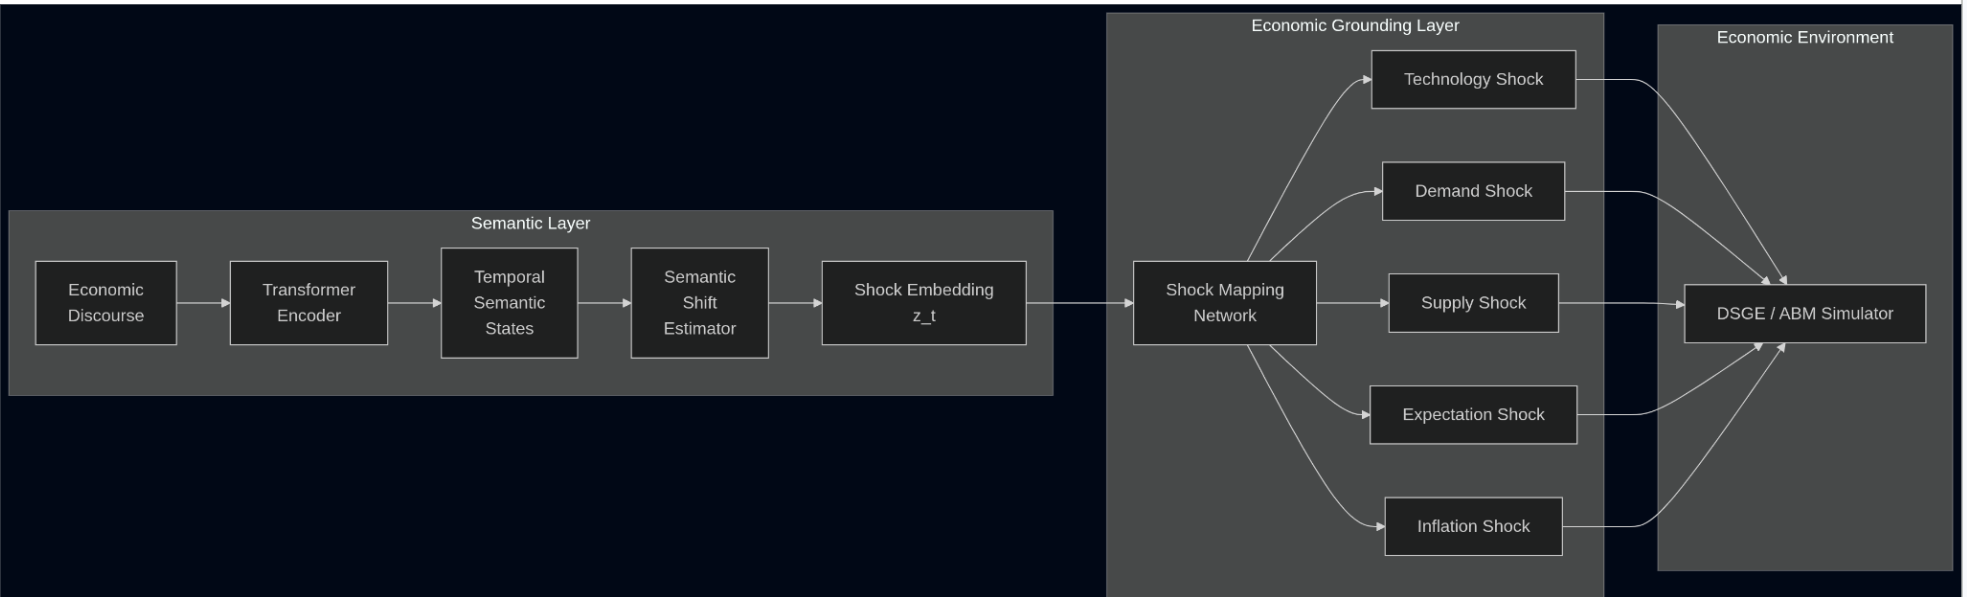
Текст об экономике служит дополнительным наблюдением. Система сравнивает соседние временные окна и использует направление изменения дискурса как шумный сигнал о возможном шоке. Авторы не считают этот сигнал доказанной причиной: причинные связи задаёт структурная модель, а тексты лишь помогают выбрать гипотезу.
Короткий горизонт способен наказать полезное действие
Главная техническая проблема возникает из-за задержки. Цена вмешательства появляется сразу, а снижение инфляции или восстановление выпуска может проявиться позже. Если вознаграждение смотрит только на ближайший период, безопасное бездействие получает преимущество перед мерой с отложенной пользой.
В калибровочном примере смягчение политики величиной 0,05 при рецессии изменило краткосрочную потерю с 216 до 219, то есть формально ухудшило результат. Этот пример не доказывает, что мера ошибочна: он показывает, что знак оценки зависит от горизонта, весов инфляции и выпуска и стоимости самого действия.
Поэтому контур отдельно хранит сформированное вознаграждение и исходную экономическую потерю. В подтверждающей проверке действие должны сравнивать с бездействием из того же клонированного состояния. Иначе удачная форма вознаграждения может скрыть ухудшение экономической траектории.
Та же задержка определяет выбор алгоритма обучения. PPO использует обучаемую функцию ценности, которая переносит позднее вознаграждение к более ранним решениям. GRPO сравнивает полную отдачу нескольких траекторий; если они заканчиваются одинаково, относительный сигнал обнуляется, а определить важный ранний ход алгоритм не может.
Однако работа пока не подтверждает преимущество PPO в этой среде. Таблица с доходностью, экономической потерей, долей допустимых действий и диагностикой распределения вознаграждения оставлена для будущих прогонов. Приведённые результаты PPO и GRPO на TextWorld взяты из другой работы и не показывают, как алгоритмы поведут себя в экономическом управлении.
Архитектуру уже можно учитывать, выбор алгоритма придётся отложить
Границы эксперимента заданы достаточно конкретно. Политику строят на Qwen2.5-1.5B-Instruct с адаптерами LoRA; эпизод включает четыре решения и прогноз на восемь периодов. Сценарии охватывают рецессию, стагфляцию, шоки предложения, производительности и рынка труда, а исторически привязанные траектории пандемии и решений ECB оставлены для внешней проверки.
DSGE-симулятор при этом не становится источником истинной экономической политики. Его вывод зависит от уравнений, калибровки, доступных инструментов и целевой функции. Поэтому результаты предполагается показывать отдельно по структурным моделям и учитывать худший исход, а не сводить расхождения к одной оценке.
Для команд, которые строят помощника аналитика или систему подбора действий, работа меняет план на уровне архитектуры. Между LLM и пользователем нужен исполняемый слой: он проверяет формат и границы действия, запускает несколько одинаково начатых сценариев, фиксирует необратимую историю и отдельно показывает последствия вмешательства.
План обучения пока менять рано. Препринт формулирует проверяемую гипотезу о преимуществе PPO при задержанном эффекте, но не даёт результатов, по которым можно оценить размер выигрыша. Практический вывод уже уже: убедительность ответа нельзя использовать как замену численной проверке, а итог симуляции следует представлять как условный сценарий, а не как рекомендацию для центрального банка или правительства.
Источники
Иллюстрация: рисунок из статьи «Grounding Large Language Models in DSGE Simulators for Policy Generation and Forecasting», Aditya Dubey, Namah Gupta, Vinti Agarwal, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


