
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Современные LLM размечают политические тексты настолько же согласованно с экспертами, насколько эксперты согласны друг с другом. Это показал препринт Kentaro Nakamura, Jing Ling Tan и George Yean, который не прошёл рецензирование, а все числа получили сами авторы. Для проектов разметки главный риск смещается с выбора между человеком и моделью на неоднозначные правила классификации.
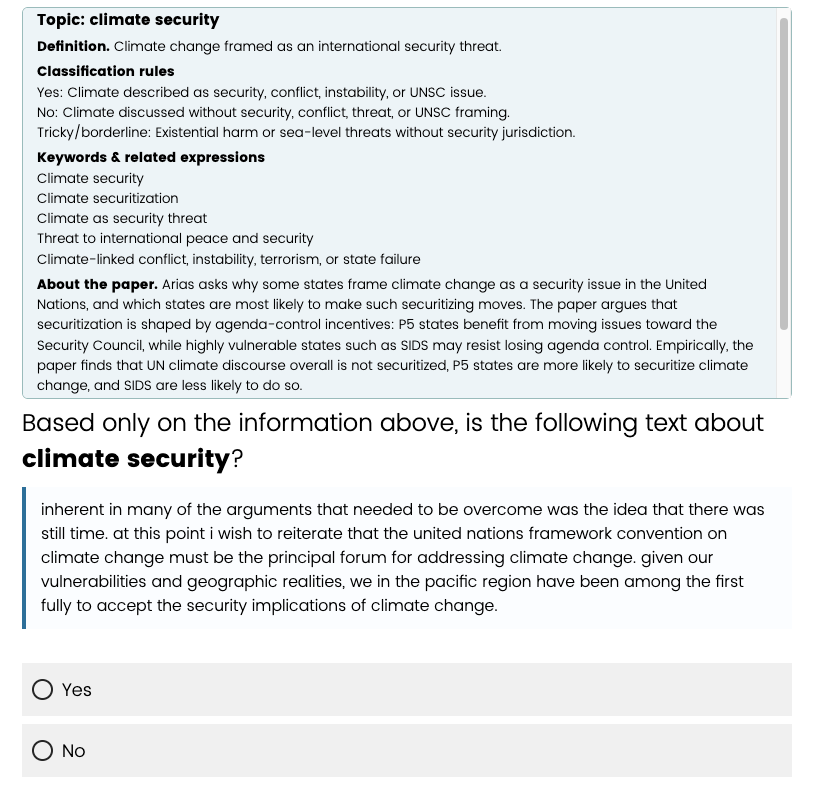
Команда воспроизвела задачи из 14 рецензированных исследований по политологии. Десять LLM, три подготовленных эксперта и 165 привлечённых через краудсорсинг работников независимо распределяли одни и те же тексты по двум классам, следуя одинаковым инструкциям.
За исключением одной старой и менее способной модели, LLM соглашались с экспертами примерно так же часто, как эксперты между собой. Расхождения концентрировались в одних и тех же текстах: если два эксперта давали разные метки, модели тоже чаще спорили с третьим экспертом и друг с другом. Работники с краудсорсинговых площадок показывали ту же связь с неоднозначностью, но в целом совпадали с экспертами заметно реже.
Когда команда уточнила недостаточно определённую инструкцию, разногласий стало меньше и среди экспертов, и среди достаточно способных LLM. Поэтому одну человеческую метку нельзя автоматически считать эталоном: расхождение с ней может указывать не на ошибку модели, а на текст, для которого правила допускают несколько обоснованных ответов.
Практический процесс меняется. Сначала небольшую случайную выборку стоит разметить вручную и уточнить правила, затем проверить, понимают ли их выбранные модели. Разногласия нескольких подходящих LLM помогут найти пограничные случаи для точечной проверки до запуска на всём корпусе. Для оставшейся неоднозначности авторы предлагают считать диапазон возможных итоговых оценок, а не исправлять модель по единственной человеческой метке.
Вывод относится к бинарной классификации политических текстов по инструкциям из исследовательских работ. Он показывает не универсальное превосходство LLM, а более узкий сдвиг: при сопоставимом качестве разметчиков результат определяет прежде всего ясность категорий и правил.
Источники
Иллюстрация: рисунок из статьи «Observational Equivalence of LLM and Human Annotation», Kentaro Nakamura, Jing Ling Tan, George Yean, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


