
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM адаптировали к генерации на устройствах, которые выполняют вычисления внутри флеш-памяти и плохо подходят для частых записей. Работа UC Berkeley, ICSI и LBNL сократила обмен с KV-кэшем в 15 раз; поскольку препринт не рецензирован, все числа получили сами авторы. Подход рассчитан не на обычный сервер с GPU, а на системы, где модель и часть вычислений переносят в накопитель.
Целочисленный тракт убирает обращения к внешнему процессору
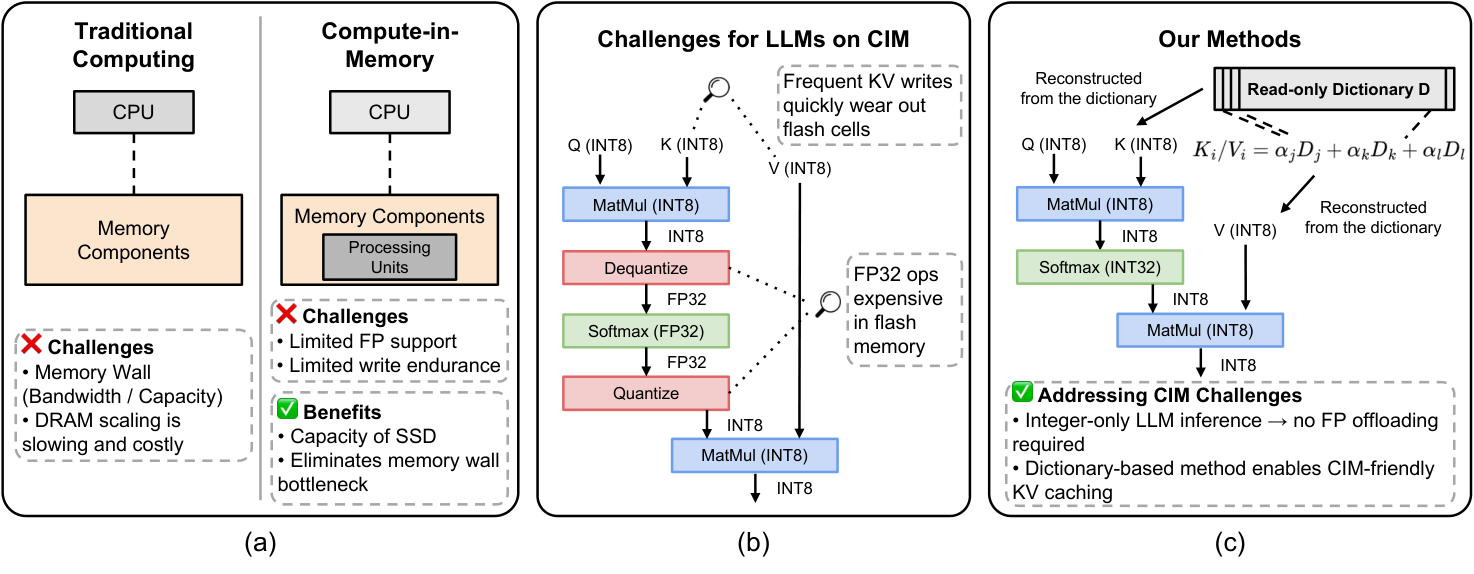
Устройства с вычислениями во флеш-памяти хорошо читают данные внутри массива, но не поддерживают дорогие операции с плавающей точкой так же эффективно, как GPU или NPU. Обычная квантизация решает задачу лишь частично: линейные слои считают с низкой разрядностью, а Softmax, нормализацию и другие чувствительные операции возвращают процессору.
Такой возврат заставляет передавать промежуточные данные за пределы накопителя. Выигрыш от вычислений рядом с памятью уменьшается, потому что задержка и расход энергии снова зависят от внешней шины.
В предложенной схеме веса и активации линейных слоёв представлены восьмибитными целыми числами. Перед квантизацией значения активаций сглаживают, а масштабы задают отдельно для небольших групп каналов. Это уменьшает ошибку от редких больших значений, которые иначе занимают почти весь доступный диапазон.
Softmax, RMSNorm и SiLU авторы также оставили в целочисленном тракте. Нелинейные функции заменили квадратичными приближениями, а перед суммированием значения приводят к общему масштабу для каждого токена. Сдвиги разрядов защищают промежуточные результаты от переполнения, поэтому устройству не нужно выгружать эти операции на NPU.
Алгоритмы качества проверяли на Llama-3.1-8B и Qwen-2.5-7B. Системную модель задержки и энергии строили только для Llama-3.1-8B, генерации с пакетом из одного запроса и контекстов 1K и 256K. Это аналитический расчёт архитектуры CIM-SSD, а не измерение готового серийного накопителя.
Словарь заменяет большую часть записей в KV-кэш
KV-кэш хранит ключи и значения прошлых токенов, чтобы модель не пересчитывала их на каждом шаге. Он растёт вместе с контекстом, постоянно пополняется и затем читается при вычислении внимания. Для флеш-памяти это неудобная нагрузка: большая ёмкость помогает хранить модель, но частые записи расходуют ресурс ячеек.
Авторы заменили полные векторы KV-кэша ссылками на статический словарь. Каждый новый вектор представляется как разреженная комбинация словарных векторов. В динамическую память записываются индексы выбранных элементов и коэффициенты, а сам словарь остаётся во флеш-памяти и многократно используется только для чтения.
Недавние токены система держит в локальном окне без такого преобразования. Для более старых состояний внимание вычисляется через проекции запроса на словарь и сохранённые разреженные коэффициенты. Архитектура меняет большой поток записей полных векторов на чтение постоянного набора данных и небольшой поток метаданных.
Словарь не даёт бесплатного сжатия. Его нужно заранее обучить на активациях модели, а для обработки значений работа предполагает хранение словаря в двух раскладках. Если словарь лежит в обычной DRAM и считывается на каждом шаге, накладные расходы перекрывают пользу на коротком контексте. Метод раскрывается, когда словарь остаётся внутри вычислительного массива флеш-памяти.
CIM-SSD меняет аппаратный план, но не заменяет GPU одним обновлением
Совместный метод уменьшил динамический обмен с KV-кэшем в 15 раз. Для короткого контекста расчётная задержка снизилась в 3,1 раза, а расход энергии — в 2,7 раза относительно NPU с DDR5. Для длинного контекста выигрыш достиг 4,4 и 6,8 раза соответственно.
В таблицах качества часть метрик выросла, а часть снизилась, поэтому метод не улучшает саму модель. Его цель — сохранить приемлемое поведение после перехода к целочисленным операциям и сжатому кэшу. Команде всё равно придётся проверять собственные задачи, особенно если они чувствительны к небольшим изменениям ответов.
Для обычного кластера GPU работа не предлагает готовой замены существующему стеку. Словарное сжатие можно выполнить и на NPU с DRAM, но на коротких запросах загрузка словаря добавляет работу вместо ускорения. Основной эффект появляется при совместном проектировании алгоритма, контроллера накопителя и размещения данных.
Подход стоит учитывать при разработке периферийных устройств, локальных серверов и других систем, где ёмкость важнее пиковой вычислительной производительности, а длинный контекст упирается в обмен с памятью. Планировать миграцию рано: расчёт охватывает только последовательную генерацию, тогда как первичная обработка запроса требует больше вычислений и хуже соответствует рассмотренной архитектуре.
Источники
Иллюстрация: рисунок из статьи «LLM Inference in a Flash!», Sebastian Zhao, Minseo Kim, Coleman Hooper и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


