
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Верное ранжирование рабочих ответов не гарантирует, что автоматическая проверка правильно определит долю пригодных результатов. Harry Lyu и Neil Thompson из MIT показали это в препринте, который не прошёл рецензирование, а числа получили сами авторы. В тесте разные оценщики признали приемлемыми от 3,0% до 97,9% ответов, тогда как специалисты соответствующих профессий — 61,1%.
Для аудита собрали O*NET-BENCH на основе 45 796 оценок от работников с опытом в нужной профессии. На тестовой части из 4 501 оценки сравнили 33 конфигурации моделей-оценщиков из шести семейств. Ответ считался приемлемым, если специалист признавал его достаточным для использования без правок.
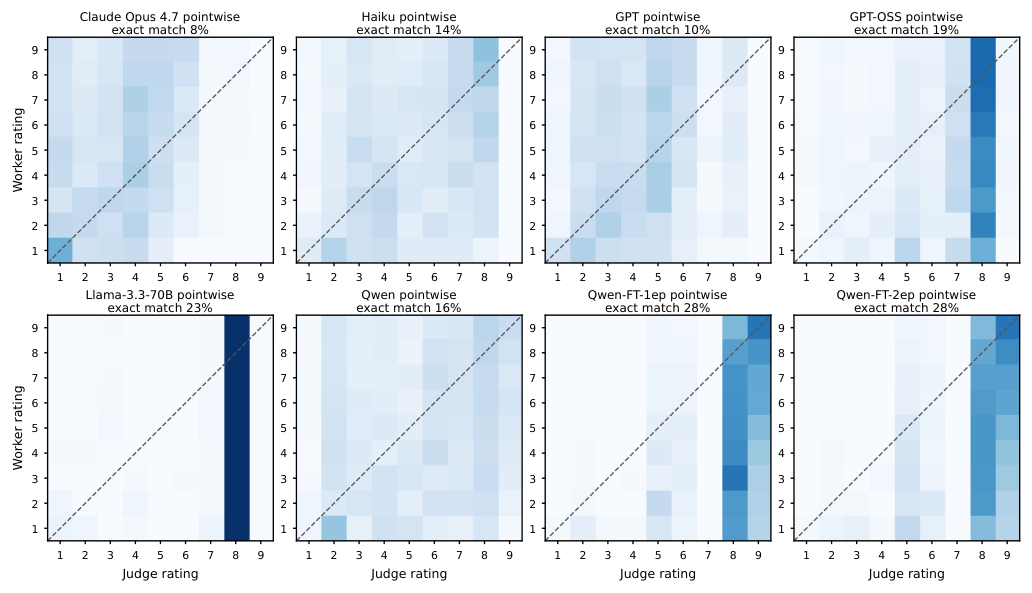
Большинство моделей различало качество ответов лучше случайного выбора: 25 конфигураций получили точность попарного порядка не ниже 0,60. Но близкий порядок не означал близкую шкалу. Модель могла предпочитать те же ответы, что и работник, однако систематически ставить им более низкие или высокие баллы и тем самым менять среднюю оценку задачи или профессии.
В одной линии дообученных моделей смена протокола улучшила ранжирование отдельных ответов, но ухудшила совпадение средних оценок по задачам и профессиям. Эффект повторился на отдельной выборке, где не пересекались работники и задачи. Калибровка почти убрала смещение среднего балла, однако после неё модель объясняла не более 8,5% различий между оценками отдельных работников.
Проверять такой оценщик нужно на том показателе, который войдёт в продуктовый или экономический вывод. Если система должна считать долю ответов, пригодных без правок, следует сравнивать именно эту долю на отложенных данных, а не выбирать модель только по корреляции или качеству ранжирования. Для средних по задачам и профессиям нужна отдельная проверка на тех же уровнях агрегации.
Источники
Иллюстрация: рисунок из статьи «Right Order, Wrong Scale: Auditing LLM Judges for Occupational AI Measurement», Harry Lyu, Neil Thompson, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


