
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
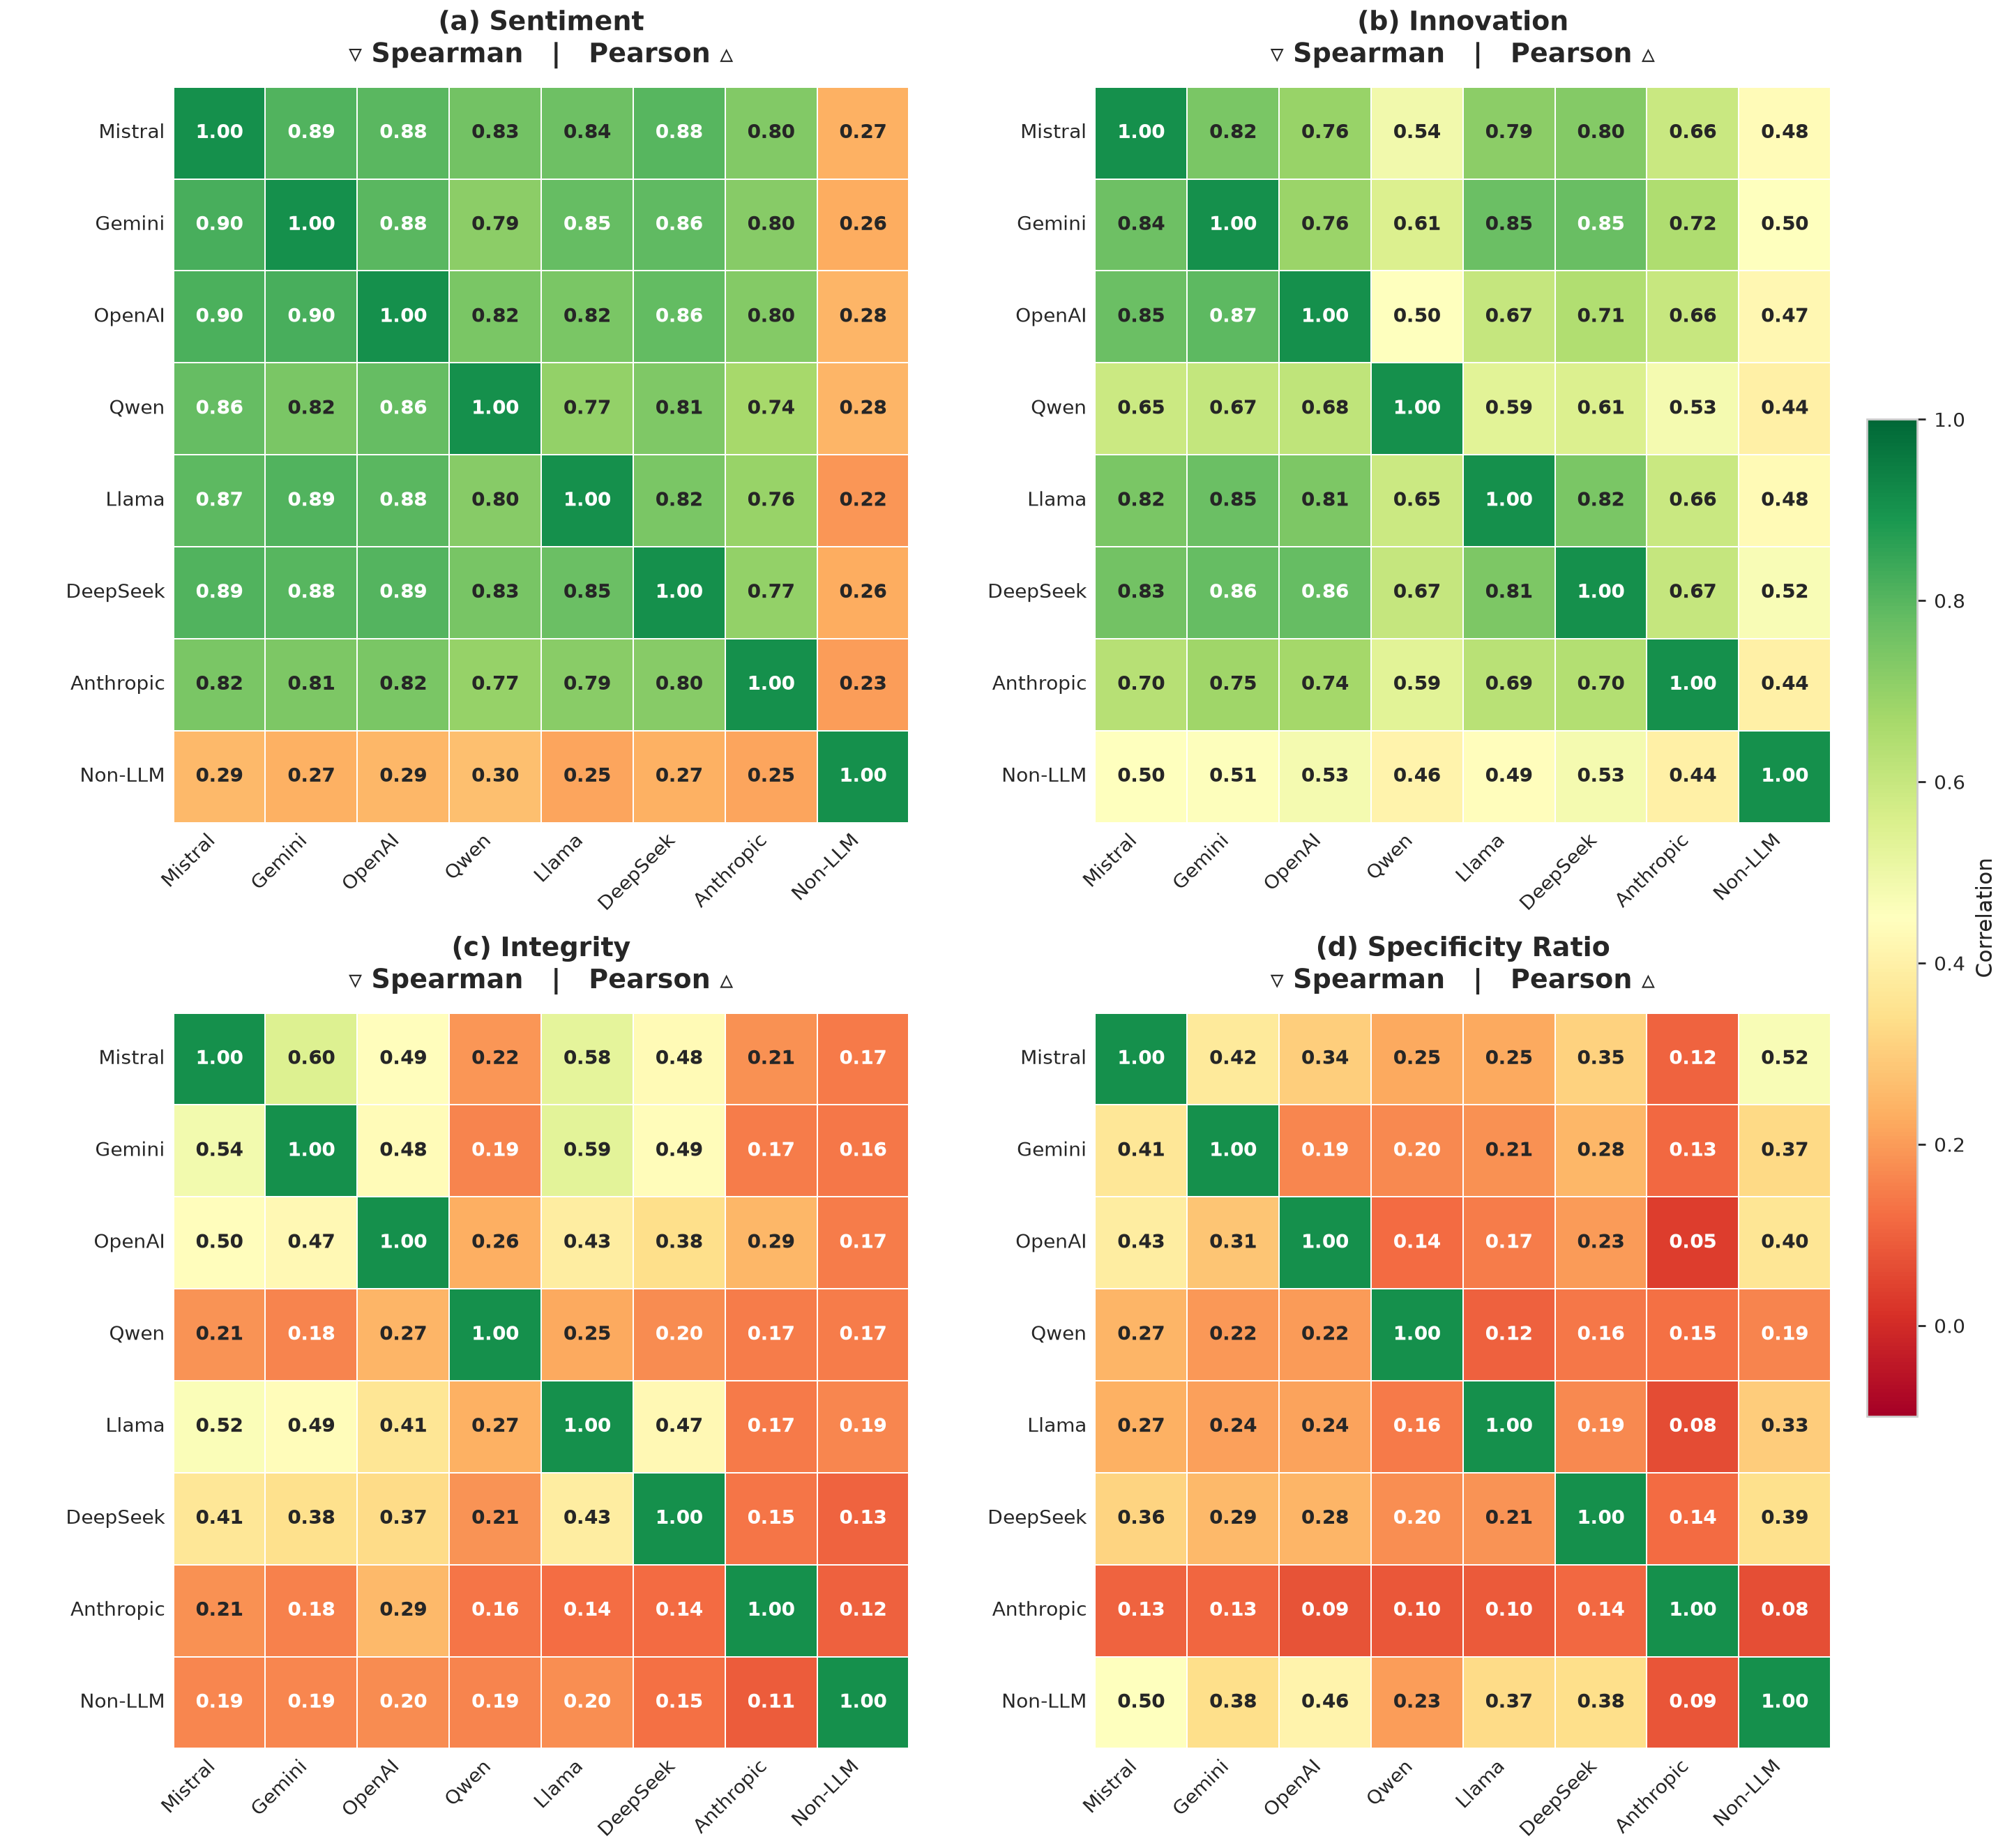
Одинаковый корпоративный текст даёт разные численные метрики в зависимости от выбранной LLM. Средняя ранговая корреляция, которая показывает сходство порядка документов в рейтинге, составила лишь 0,52, хотя препринт не рецензирован и числа получили сами авторы. Одну модель нельзя считать нейтральным измерительным инструментом: при её замене меняются данные для последующего анализа.
Модели получили одинаковые определения показателей, шкалы и инструкции. Они оценивали тональность, неопределённость, ясность руководства, климатический и политический риск, конкретность ответов и корпоративную культуру. Каждый ответ включал оценку, заявленную уверенность и краткое обоснование; внешние инструменты не использовали, а температуру установили в 0, чтобы убрать случайный разброс.
Только 34% изменчивости оценок объяснялись различиями между самими текстами, которые одинаково замечали разные провайдеры. Остальное приходилось на систематические особенности моделей и их разную реакцию на отдельные документы. Даже для конкретности, где модели просили считать заданные категории слов по явному правилу, корреляция упала до 0,23: подробная инструкция не сделала измерение воспроизводимым.
Расхождение перешло в дальнейшие расчёты. В регрессиях, связывающих метрики с реакцией рынка, смена модели меняла величину коэффициентов вплоть до 60%, а для части показателей — ещё знак и статистическую значимость. Усреднение результатов нескольких провайдеров сделало порядок документов устойчивее, но абсолютные оценки всё равно зависели от состава моделей. Поэтому метрику для отчётности, исследований или принятия решений стоит проверять на нескольких провайдерах, а не только повторными запусками одной LLM.
Работу проверяли на 1 946 расшифровках звонков компаний S&P 500 за 2024 год. Один доступный через API представитель каждого из семи провайдеров оценивал 13 метрик по разделам вопросов и ответов. Такой дизайн показывает проблему в массовой обработке корпоративных текстов, но не устанавливает, какая модель ближе к правильной оценке.
Источники
Иллюстрация: рисунок из статьи «Same Text, Different Numbers: The Divergence of LLM-Based Measures», Hamid Boustanifar, Sasan Mansouri, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


