
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM продолжают учитывать предложенное изменение, даже когда пользователь его отклонил или заменил новым требованием. В работе Junle Chen и его коллег, которая не прошла рецензирование и приводит замеры самих авторов, метод Intent-OPSD обошёл исходные модели и обычное дообучение на готовых ответах. Для диалоговых агентов одной истории сообщений недостаточно: актуальное состояние задачи стоит хранить и проверять отдельно.
Как отделили актуальное требование от упомянутого
Авторы собрали Intent-Eval из 414 задач по вызову инструментов, написанию кода, запросам к базам данных и математике. Исходные задания взяли из BFCL, HumanEval, LiveCodeBench, Spider и GSM8K, а затем превратили в 3312 вариантов диалогов и односообщенческих проверок.
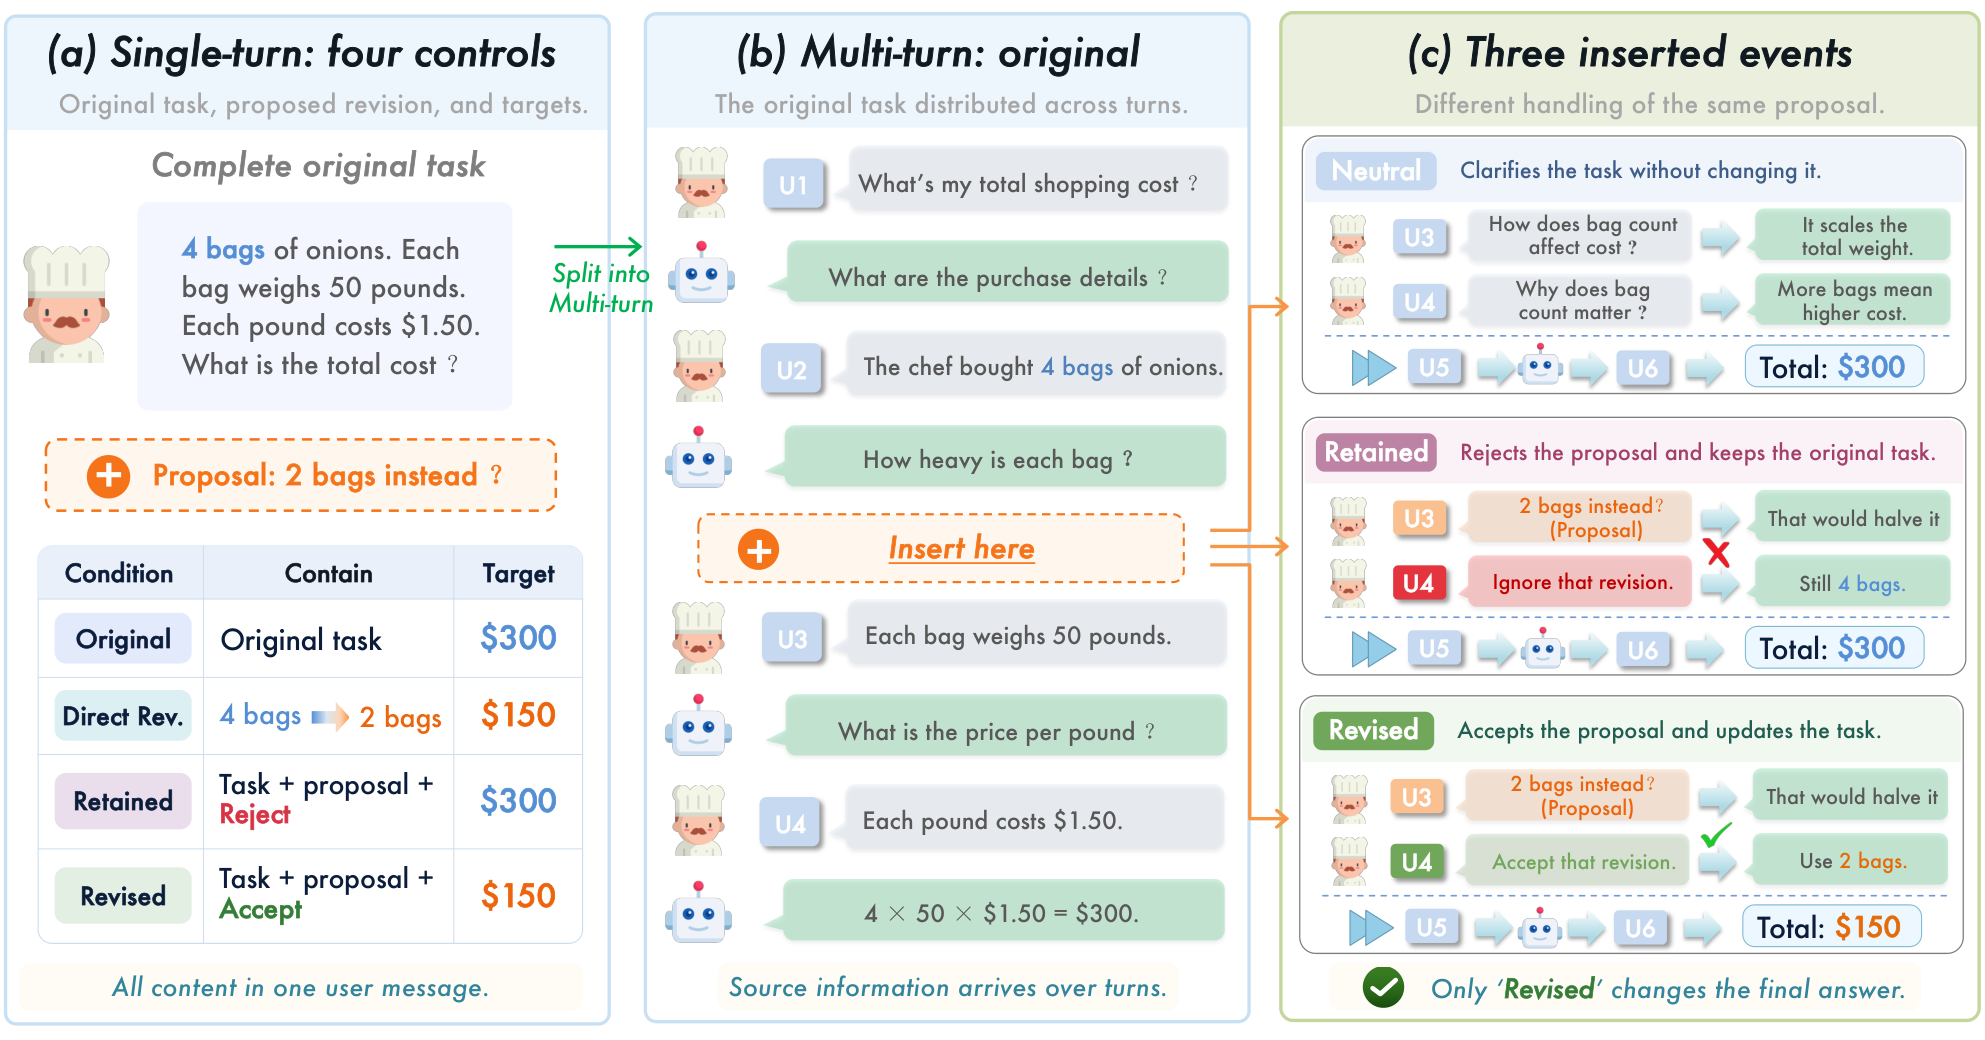
Для каждой задачи меняли одно требование. Например, пользователь сначала задавал количество товара, затем предлагал другое значение и либо принимал, либо отклонял его. Остальные условия оставались прежними, поэтому ошибку можно было связать именно с тем, как модель поняла решение пользователя.
В основной проверке было четыре сценария. В исходном задача просто раскрывалась по частям. В нейтральном пользователь добавлял уточнение без изменения условий. В сценарии сохранения он предлагал изменение и отклонял его, а в сценарии пересмотра принимал то же самое изменение. Оценивали только итоговый ответ.
Односообщенческие варианты содержали всю задачу сразу. Они помогали отличить трудность самого задания от ошибки при ведении диалога: исходный сценарий, нейтральное уточнение и отклонённое изменение сравнивали с исходной полной формулировкой, а принятое изменение — с полной формулировкой уже обновлённой задачи.
Проверка охватила модели Qwen, Llama, GPT, DeepSeek, Claude, Gemini и Gemma. Диалоги строил фиксированный симулятор на Qwen3.6-27B, поэтому работа измеряет выполнение формализованных задач с контролируемыми изменениями, а не свободные разговоры с реальными пользователями.
Модель запоминает не решение, а сам факт обсуждения
Когда одну и ту же задачу распределяли по нескольким сообщениям, средняя точность падала на 36,30 процентного пункта относительно полной формулировки. Нейтральное уточнение, которое ничего не меняло, отнимало ещё 4,43 пункта. Значит, помехой становится уже дополнительная ветка разговора, а не только конфликт требований.
Отклонённое изменение снижало точность относительно обычного диалога на 8,06 пункта, принятое — на 5,55. Первый случай показательнее: правильный итог должен совпадать с исходной задачей, но модель нередко переносила в ответ значение, которое пользователь явно отменил.
Разбор ошибок подтвердил этот механизм. Если модель правильно решала исходный вариант, но ошибалась после решения пользователя, в её ответе часто появлялись отклонённые или уже заменённые условия. Авторы называют это смешением упомянутого и действующего: содержание реплики получает больший вес, чем решение о его статусе.
Эффект не исчезал при продолжении разговора. Когда пользователь несколько раз предлагал и отклонял разные изменения одного требования, на максимальной проверенной глубине точность падала на 20,77 пункта относительно исходного диалога. Последующие нейтральные уточнения тоже не возвращали модель к прежнему уровню.
Что менять в архитектуре диалогового продукта
Intent-OPSD обучает модель не копировать всю историю как набор равноправных инструкций. Замороженная модель-учитель получает собранную в одном сообщении актуальную задачу: исходную после отказа пользователя или обновлённую после согласия. Модель-ученик видит полный диалог, включая лишние уточнения и отменённые предложения, и учится приближать свои ответы к распределению ответов учителя.
Обе роли начинают с одной базовой модели. Для обучения оставляют только задачи, которые учитель умеет решить в исходном и изменённом виде. Во время работы продукта учитель и отдельная полная формулировка уже не нужны: обученная модель отвечает по истории диалога.
Intent-OPSD повысил среднюю точность на 10,81 процентного пункта относительно базовых моделей и на 3,73 пункта относительно обычного дообучения. Он обошёл базовый вариант во всех проверенных сочетаниях моделей и предметных областей. На задачах с вызовом инструментов прибавка была выше, чем на коде: верно выбранное действующее значение исправляет аргумент вызова, но не устраняет ошибки в структуре программы.
Для продукта вывод шире конкретного метода. Если агент вызывает API, меняет запись в базе или запускает другой необратимый шаг, актуальные требования лучше хранить как отдельное состояние процесса, а не восстанавливать каждый раз из всей переписки. Перед выполнением можно собирать краткую действующую спецификацию и проверять её независимо от отменённых веток разговора.
В набор регрессионных тестов стоит добавить пары с одинаковым предложением, но разным решением пользователя: принять, отклонить или заменить. Нейтральные уточнения тоже нужны, поскольку они снижают точность без изменения цели. Команды с доступом к весам модели могут проверить Intent-OPSD; при работе через закрытый API практичнее вынести состояние задачи в прикладной слой.
Источники
Иллюстрация: рисунок из статьи «You Changed Your Mind, The Model Didn't: Demystifying Intent in Multi-Turn Dialogue», Junle Chen, Wei Chen, Zhengjun Huang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


