
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
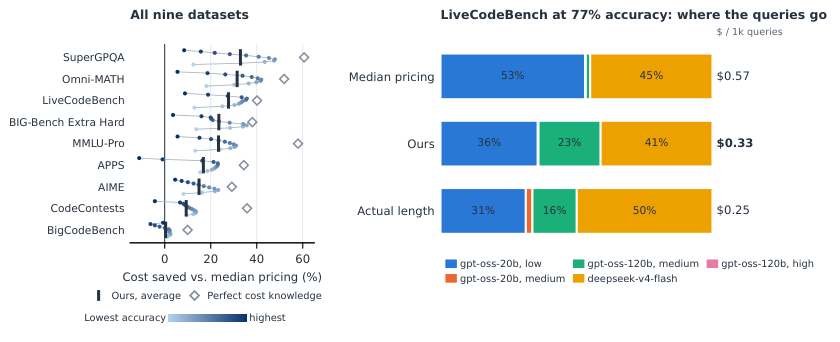
Маршрутизатор можно научить заранее оценивать не только вероятность правильного ответа, но и длину рассуждения каждой доступной модели. В препринте Aristides Milios и Christopher Pal, который не прошёл рецензирование и опирается на числа самих авторов, такая оценка сократила расходы при прежней точности до 33%. Команда может учитывать стоимость конкретного запроса вместо средней цены модели.
Как длину ответа узнают до генерации
Модель-разведчик Qwen3-4B сначала выполняет предварительный проход (prefill): читает запрос и строит внутренние числовые представления, но ничего не генерирует. Эти же представления позволяют оценить вероятность успеха и будущую длину ответа у других моделей.
Для каждого кандидата обучают два линейных предиктора. Логистическая регрессия оценивает вероятность правильного ответа, а линейная регрессия с регуляризацией предсказывает логарифм средней длины. Второй результат переводят в число выходных токенов и умножают на тариф конкретной модели; стоимость входа уже известна из длины запроса.
Если маршрутизатор уже использует внутренние представления разведчика для оценки качества, предсказание цены не требует ещё одного прохода модели. Добавляются только отдельные линейные предикторы длины для доступных конечных точек.
Маршрутизатор выбирает кандидата по разнице между ожидаемой ценностью правильного ответа и стоимостью вызова. Изменяя ценность ответа, можно получить разные режимы: от дешёвого с меньшей точностью до более дорогого с большей. Каждый запрос отправляется одной модели, без проверки результата и повторной попытки.
Метод проверяли на девяти наборах задач по программированию, математике, знаниям и смешанным рассуждениям. Основной пул включал пять вариантов gpt-oss и deepseek-v4-flash с разными уровнями рассуждения; сравнивали цену по запросу со средней и медианной длиной, идеальным знанием фактической длины, ZeroRouter и предикторами в стиле MixLLM.
Когда средняя длина приводит к лишним расходам
У рассуждающих моделей длина ответа на разные запросы менялась более чем на порядок. Поэтому модель, дешёвая в среднем, могла оказаться дорогой на отдельной задаче, а маршрутизатор со средней ценой выбирал её не в тот момент.
Идеальное знание длины каждого ответа оставляло запас для экономии в 29–61% на восьми из девяти наборов. Предиктор извлекал до 69% этого запаса и в большинстве сравнений обходил внешние оценщики; статистически значимого проигрыша не было.
Результат зависит от типа задачи. В математике и программировании сложные примеры обычно требуют более длинного рассуждения, поэтому оценка вероятности успеха иногда служит приемлемой заменой предсказанию длины. В задачах на знания и смешанных форматах эта связь слабее: на MMLU-Pro отдельная оценка длины снизила расход ещё на 18% относительно цены, выведенной только из вероятности успеха.
Длину в основном определял сам запрос: разные кандидаты обычно писали длинные ответы на одни и те же задачи. Поэтому один разведчик мог оценивать стоимость нескольких моделей, хотя для каждой требовался свой линейный предиктор.
На BigCodeBench метод почти ничего не дал, но там и идеальное знание длины оставляло лишь 10% запаса. Если длины и цены близки, предсказывать стоимость по запросу незачем: маршрутизатору почти нечего перераспределять.
Меняет ли работа планы продуктовой команды
Работа меняет архитектуру маршрутизатора, если продукт вызывает рассуждающие модели с заметно разной ценой и длиной ответа. Вместо постоянной стоимости кандидата стоит хранить две оценки для каждого запроса: вероятность успеха и ожидаемое число выходных токенов. Особенно полезен такой подход, когда в пуле есть дешёвая модель, способная решить значительную долю задач.
Перестраивать существующий маршрутизатор не требуется. Если он уже прогоняет запрос через малую LLM, можно добавить линейный предиктор длины на тех же внутренних представлениях. В экспериментах ему хватало нескольких десятков размеченных задач, а в смешанном потоке он сократил расход ещё на 22% по сравнению с отдельной медианной ценой для каждого набора.
Для пула обычных моделей без развёрнутого рассуждения эффект был заметно меньше. Не стоит усложнять систему и там, где формат ограничивает ответ, длины стабильны или кандидаты стоят примерно одинаково.
Перед внедрением нужны собственные записи вызовов: запрос, выбранная модель, число токенов, цена и признак правильного ответа. В работе тарифы и поведение конечных точек зависели от провайдера и менялись со временем, поэтому обученный на чужих вызовах предиктор не заменяет проверку на рабочем трафике.
Более крупный разведчик не приносил дополнительной экономии и увеличивал стоимость самого маршрутизатора. Метод также не повышает максимальную точность сильнейшего кандидата: для этого нужно лучше предсказывать успех или проверять готовый ответ. Его задача уже — дешевле достигать выбранного уровня качества.
Источники
Иллюстрация: рисунок из статьи «Scout Before You Route: Predicting Task Success and Token Count from a Small LLM Prefill», Aristides Milios, Christopher Pal, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


