
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Появился способ обучать маршрутизатор между слабой и сильной LLM, даже когда качество ответа становится известно только после обращения к сильной модели. В препринте, который не прошёл рецензирование, все числа получили сами авторы: их алгоритм показал меньшие средние затраты, чем несколько прежних подходов. Для продуктовой команды это вариант заменить фиксированный порог маршрутизации на систему, которая продолжает учиться во время работы.
Как маршрутизатор учится без оценки каждого ответа
Обычный маршрутизатор получает запрос, оценивает сложность и решает, достаточно ли дешёвой модели. Но если система отдаёт её ответ пользователю, она обычно не узнаёт, был ли он правильным: эталона нет, а сильную модель как раз не вызывали.
Авторы описывают эту задачу как обучение с частичной обратной связью. На каждом шаге система видит контекст, выбирает действие и получает не истинный результат или размер потери, а косвенный сигнал. В случае LLM можно отдать ответ слабой модели либо запросить сильную и увидеть, совпали ли их ответы.
Сильная модель в постановке считается правильной. Её вызов имеет фиксированную стоимость, а ошибочный ответ слабой модели обходится дороже. Поэтому маршрутизатор должен одновременно экономить запросы и иногда обращаться к сильной модели, чтобы обновлять представление о риске ошибки.
E2D.PMSide разделяет эту задачу на прогноз и выбор действия. Модуль онлайн-регрессии оценивает распределение скрытых исходов по контексту, выбранному действию и полученному сигналу. Политика маршрутизации затем сочетает выгодное по текущему прогнозу действие с исследованием, которое приносит полезную обратную связь.
Исходный E2D требует решать на каждом шаге сложную минимаксную задачу. Новая работа заменяет её вычислимо более простой целью, которая уравновешивает ожидаемые потери и покрытие возможных действий. Для игр с глобально доступной информацией используется случайное исследование, а для локально доступной — взвешивание, при котором вероятность действия зависит от разрыва между его ожидаемой потерей и лучшим вариантом.
Получившийся SquareCB.PMSide принимает любой подходящий модуль регрессии без переделки самой политики. Теоретически алгоритмы сохраняют оптимальный порядок роста накопленного проигрыша — разницы с лучшей политикой, известной задним числом — при заданных в работе предпосылках.
Что показала маршрутизация на BoolQ
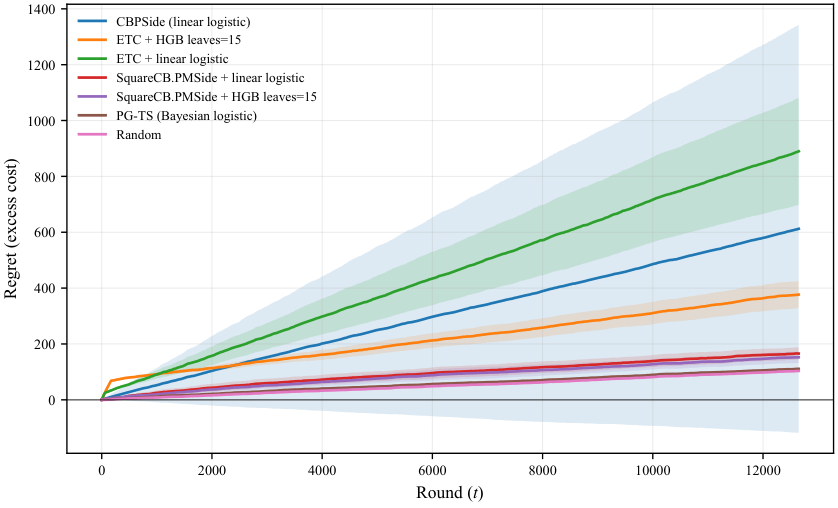
Алгоритм проверили на двух задачах: маршрутизации LLM и синтетической классификации, где истинную метку можно запросить за плату. Эксперимент с LLM использовал 12 648 запросов BoolQ и контекст из 138 признаков: показатели неопределённости слабой модели, её внутренние представления и представление исходного запроса.
SquareCB.PMSide запускали с линейной логистической регрессией и с нелинейной моделью на деревьях с 15 листьями. Обе версии дали меньшие средние суммарные затраты, чем CBPSide, при всех проверенных штрафах за ошибку слабой модели. Нелинейная версия также обошла PG-TS.
Результаты усредняли по 20 случайным порядкам поступления запросов. При этом параметры каждого алгоритма выбирали задним числом отдельно для каждого штрафа, поэтому эксперимент сравнивает лучшие конфигурации, а не готовые настройки для эксплуатации.
Explore-Then-Commit, который сначала собирает данные, а затем перестаёт исследовать, оказался конкурентоспособным. Авторы связывают это с тем, что число примеров невелико относительно размерности контекста. На синтетической задаче SquareCB.PMSide стабильно обошёл Explore-Then-Commit и CBPSide, а с RandCBPSide показал сопоставимый результат.
Проверка охватывает сохранённые ответы одной слабой и одной сильной модели. Критерием служит их согласие, причём сильная модель считается эталоном. Это проверяет механику обучения маршрутизатора, но не доказывает, что тот же выигрыш сохранится при другой паре моделей или иной цене ошибки.
Когда работа меняет планы продукта
Работа влияет прежде всего на архитектуру маршрутизатора. Если качество дешёвого ответа становится известно только после эскалации, обычная классификация по размеченной истории не описывает рабочий цикл полностью: система должна сама решать, когда платить за новую метку. E2D.PMSide включает это решение в политику.
Подход также снимает привязку к линейной модели. Команда может начать с логистической регрессии, а затем заменить её нелинейным предсказателем, не переписывая правило исследования. Вариант OE2D.PMSide допускает обучение регрессии на накопленных данных, если контексты приходят независимо из фиксированного распределения.
Для внедрения потребуется заранее определить стоимость вызова сильной модели и штраф за ошибку слабой. В работе этот штраф постоянный, хотя в продукте цена ошибки часто зависит от запроса. Также нужно проверить, что доступные сигналы действительно позволяют различать полезные действия: анализ рассчитан на наблюдаемые и невырожденные игры с корректно заданным классом моделей.
Менять действующий маршрутизатор только по этому эксперименту рано. Но если команда уже строит каскад из моделей и не получает оценку каждого дешёвого ответа, SquareCB.PMSide даёт обоснованную схему для следующего прототипа: модуль прогноза, явная цена ошибки и управляемое исследование вместо одного фиксированного порога.
Источники
Иллюстрация: рисунок из статьи «Efficient contextual partial monitoring with general function approximation», Kapilan Balagopalan, Hao Qin, Kwang-Sung Jun и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


