
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
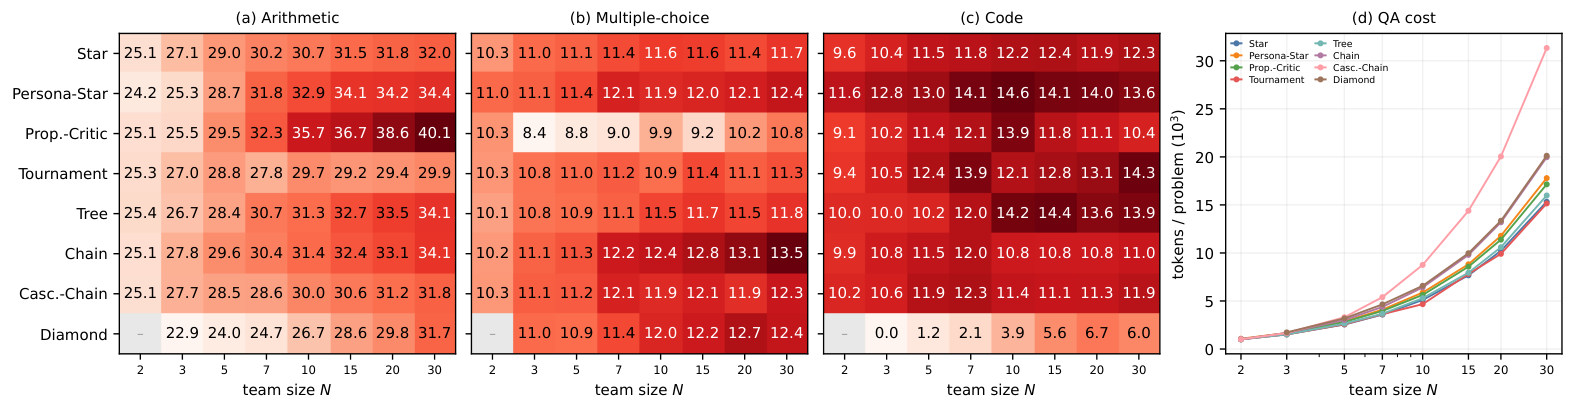
Увеличение команды небольших LLM помогает только тогда, когда дополнительные вызовы дают новые правильные варианты, а финальный агент умеет их использовать. При переходе от трёх вызовов к тридцати точность на арифметических задачах выросла до 17 процентных пунктов, тогда как на тестах с выбором ответа — не более чем на четыре; препринт Blaz Bertalanic и Carolina Fortuna не рецензирован, а числа получили сами авторы. Поэтому выбирать схему оркестрации по средней точности нельзя: сначала нужно выяснить, ограничен ли продукт поиском вариантов или их последующей обработкой.
Как разложили прирост точности
Авторы делят любой процесс на две части. На этапе генерации агенты создают первые варианты ответа. На этапе преобразования критики, редакторы, синтезаторы и финальный управляющий агент выбирают, исправляют или объединяют эти варианты.
Для каждого задания фиксируют два события: появился ли хотя бы один правильный вариант и дал ли управляющий агент правильный итог. Из их сочетания видны два типа ошибки. Система может потерять уже найденный ответ или, наоборот, восстановиться, когда все исходные варианты были неверны.
Это важно для иерархических схем. Их управляющий агент не обязан выбирать готовый ответ: он может вывести новый. Поэтому разница между охватом правильных вариантов и итоговой точностью не показывает, насколько хорошо работает выбор. В ней одновременно смешаны потеря правильных вариантов и восстановление после полностью неудачной генерации.
Разложение делит изменение итоговой точности на две слагаемые. Первое показывает, сколько дал расширившийся охват: появились новые задания, для которых хотя бы один агент нашёл правильный ответ. Второе показывает, как изменилась последующая обработка: чаще ли система сохраняет доступный правильный вариант и умеет ли исправлять полностью неверный набор.
Равенство точное и не требует подгонять кривую роста. При этом оно не доказывает причинную связь: при большем бюджете в охваченный набор попадают более трудные задания, поэтому ухудшение второго слагаемого не обязательно означает, что управляющий агент стал хуже работать на тех же примерах.
Арифметика дала запас для роста, тесты — почти нет
На GSM8K и GSMHard дополнительные предложения чаще приносили новые правильные решения. Архитектура Proposer-Critic смогла превратить этот запас в итоговый прирост: несколько агентов предлагают ответы, критики проверяют их, а управляющий агент собирает результат. На максимальном бюджете эта схема обошла остальные на арифметике со статистически значимой разницей.
Тот же Proposer-Critic оказался среди слабых вариантов на других типах заданий. На ARC, GPQA и MMLU охват либо быстро насыщался, либо последующая обработка плохо использовала новые правильные предложения. Усреднённая оценка по задачам скрывает эту специализацию и создаёт ложное впечатление, что одна архитектура стабильно масштабируется.
На HumanEval+ восстановление почти исчезло: если первый слой не создавал рабочую программу, последующие агенты редко исправляли ситуацию с нуля. Итоговая точность поэтому шла вслед за охватом, а все архитектуры заканчивали ниже условного оракула, который всегда выбирает правильный вариант, если тот есть среди предложений.
Число вызовов также плохо описывает стоимость. При одинаковом бюджете архитектуры расходовали в 2,1 раза разное количество токенов, поскольку одни передавали управляющему агенту множество коротких ответов, а другие строили цепочки критики и синтеза с растущим контекстом.
Что менять в планах команд
Работа предлагает не новую универсальную схему, а способ диагностировать уже выбранную. Если продукт решает задачи с проверяемым коротким ответом, стоит отдельно измерять охват первого слоя и точность финального результата. Логи должны сохранять исходные предложения, иначе потерю правильного ответа нельзя отличить от его отсутствия.
Если охват растёт, а итоговая точность остаётся на месте, добавлять генераторов бессмысленно: нужно менять критика, управляющего агента или способ передачи контекста. Если обработка надёжна, но правильный вариант редко появляется, полезнее расширять генерацию, менять подсказки или подключать другую модель. Когда оба показателя быстро насыщаются, увеличение команды лишь повышает счёт за токены.
Проверка охватила восемь архитектур, пять моделей размером 7–9B и шесть наборов задач. Это Llama-3.1-8B-Instruct, Ministral-3-8B-Instruct-2512, NVIDIA-Nemotron-Nano-9B-v2, Qwen2.5-7B-Instruct и Qwen3-8B; модели работали без режима углублённого рассуждения. Эксперименты покрывают короткие ответы и исполняемый код, поэтому выводы относятся к однородным командам небольших моделей, а не к системам с инструментами, разными LLM или длинными свободными текстами.
Практический вывод — сравнивать архитектуры отдельно по типам задач и по расходу токенов. Само число агентов не объясняет результат: один дополнительный вызов может найти новый ответ, проверить старый или только увеличить контекст, и эти действия дают разную отдачу.
Источники
Иллюстрация: рисунок из статьи «An Exact Generate - Transform Decomposition of Small-LLM Team Scaling Across Orchestration Architectures», Blaz Bertalanic, Carolina Fortuna, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


