
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM смогла взять на себя часть работы компилятора: система TAIC переводит ядра Triton в низкоуровневые инструкции NVIDIA GPU без обычного бэкенда. Лучший сгенерированный вариант работал в 3,34 раза быстрее кода от Triton; работа не рецензирована, а числа получили сами авторы. Подход открывает дополнительный путь для оптимизации критичных ядер, но требует отдельного контура проверки корректности.
Как LLM превращает Triton в исполняемый PTX
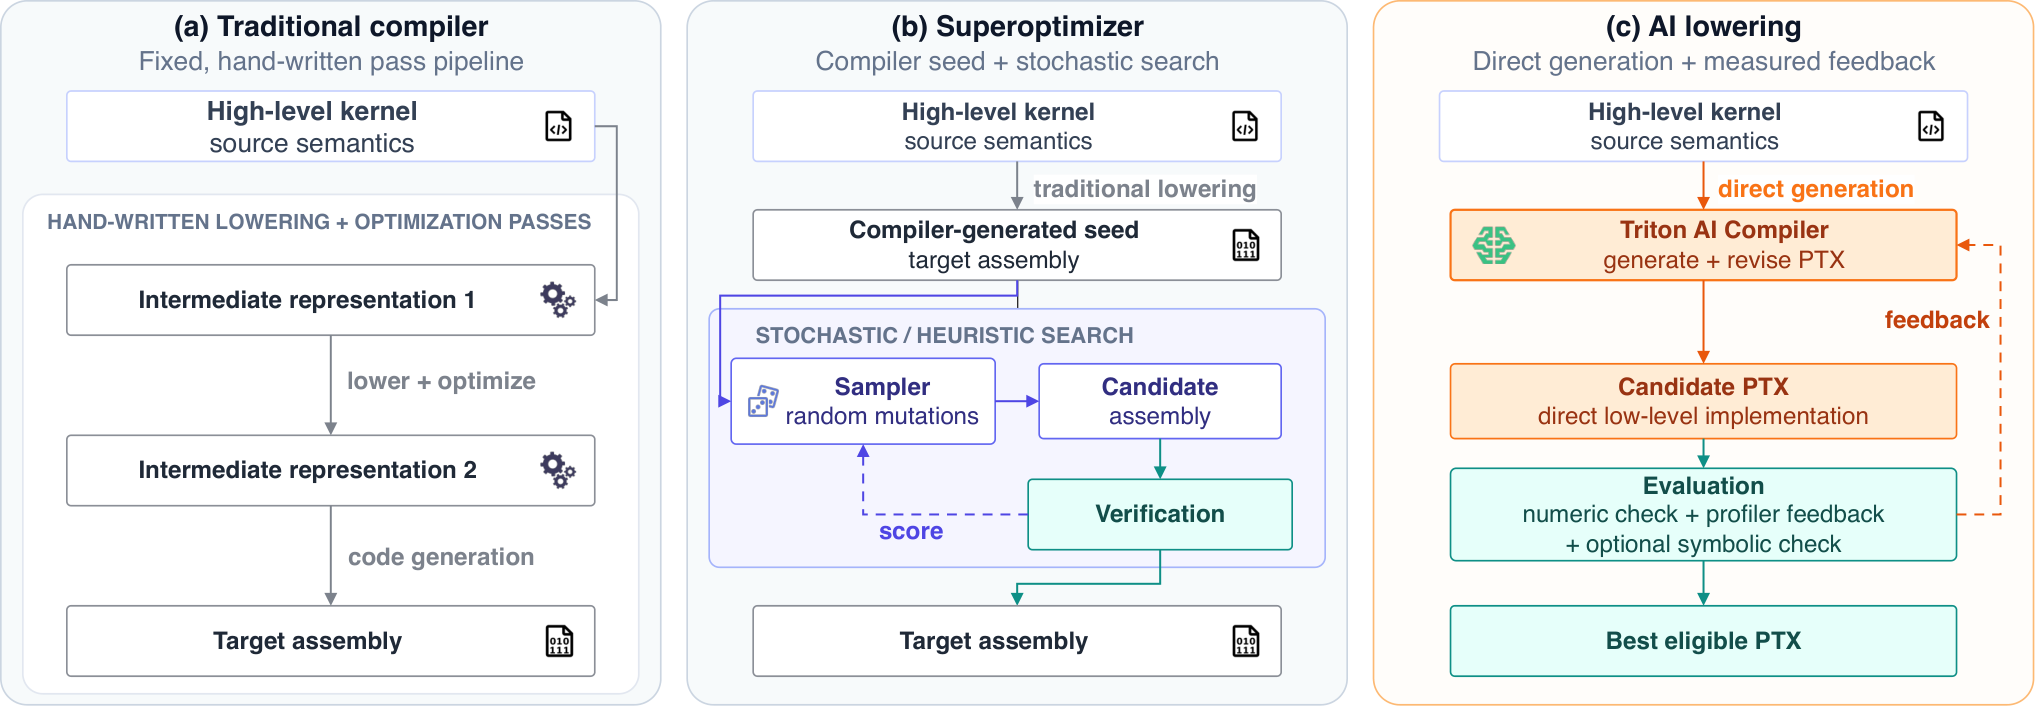
Работа Stanford University и EPFL разделяет генерацию кода и его проверку. Triton AI Compiler, или TAIC, пишет PTX — набор низкоуровневых инструкций для NVIDIA GPU. Triton Compiler Environment, или TCEnv, собирает этот код, запускает его и решает, можно ли допустить кандидата к следующему этапу.
Система получает не произвольную программу, а фиксированный контракт: исходное ядро Triton, значения, известные при компиляции, конфигурацию запуска, интерфейс аргументов и целевую архитектуру GPU. TAIC не выбирает размер задачи и не меняет внешний интерфейс ядра. Он ищет другую реализацию той же операции для конкретных условий.
Первый вариант PTX проходит сборку, проверку безопасности памяти и сравнение с эталонным результатом на случайных входах. Тесты специально создают переполнение, потерю точности и взаимное уничтожение близких чисел. После этого TCEnv измеряет задержку и передаёт TAIC данные профилировщика: модель определяет узкое место, предлагает изменения, а несколько вспомогательных агентов независимо готовят исправления.
В следующий раунд попадает только код, который собирается, проходит проверки и ускоряет ядро. Это превращает LLM не в однопроходный компилятор, а в поисковую систему с обратной связью от реального GPU.
Метод проверяли на двенадцати распространённых ядрах для Ada, Hopper и Blackwell, а также на десяти ядрах из недавних работ по машинному обучению. Базой служил настроенный Triton: для каждого GPU выбирали самый быстрый корректный вариант, а исходные ядра при необходимости дополнительно оптимизировали. Во всех основных опытах код генерировала GPT-6 Astra.
Ускорение появляется там, где меняется движение данных
На наборе распространённых операций результат составил от 0,83 до 2,23 производительности Triton. Нижняя граница показывает, что прямой перевод не гарантирует выигрыша: простые поэлементные операции в основном лишь повторяли скорость обычного компилятора, а FP16-умножение матриц на H100 оказалось медленнее базы.
Наибольший эффект дали не локальные перестановки инструкций, а другое распределение работы между потоками и памятью. Для свёртки TAIC повторно использовал пересекающиеся окна вместо повторной загрузки данных. В FP8-умножении матриц на H100 система выбрала более крупные блоки Tensor Core, сократила синхронизации и упростила финальную перестановку результата.
В BitDelta модель распаковывала двоичные веса сразу в операнды Tensor Core, минуя промежуточное представление. Для FlashAttention она назначила каждому потоку целую строку оценок в тензорной памяти и устранила часть обмена между потоками; получившийся вариант обошёл Triton в 1,37 раза. Mamba-2 и задачи, ограниченные пропускной способностью памяти, остались близки к базе.
Повторные запуски показали умеренный разброс там, где поиск находил заметное ускорение. Поэтому единичный удачный результат нельзя считать стабильным свойством генератора: для практического использования понадобится несколько независимых прогонов и выбор лучшего проверенного кандидата.
Менять компиляторный стек рано, добавить поиск для критичных ядер уже можно
Работа не предлагает заменить весь компилятор LLM. TAIC действует после того, как команда уже зафиксировала ядро, его интерфейс и целевой GPU. Он не решает задачи уровня вычислительного графа: не выбирает библиотечные операции, не объединяет соседние этапы модели и не создаёт переносимую реализацию для разных ускорителей.
Практический сценарий — автономная оптимизация небольшого набора дорогих ядер. Для свёрток и умножения матриц поиск кандидата стоил примерно от 5 до 12 долларов за запуск API. Эти расходы возникают один раз, а результат можно многократно использовать при неизменном контракте ядра.
Второй сценарий — поддержка нового GPU или специализированного ускорителя, когда полноценный бэкенд ещё дорого разрабатывать. LLM может быстрее исследовать инструкции и схемы движения данных, которые существующие промежуточные представления не выражают. Но для этого среде всё равно нужны сборщик, исполнитель, профилировщик и точная спецификация целевой архитектуры.
Главный инженерный барьер — доказательство корректности. Численные тесты проверяют только выбранные входы, поэтому авторы подключили Volta, который символически исполняет потоки и ищет гонки, взаимные блокировки и расхождения с эталоном. Его пришлось расширить для асинхронных копирований, новых Tensor Core и тензорной памяти Blackwell.
Даже расширенная проверка пока не охватывает атомарные операции, ветвление по входным данным и вычисления через битовое представление чисел. Именно такие низкоуровневые приёмы иногда дают ускорение. Поэтому ближайший практический шаг — не убирать традиционный бэкенд, а поставить LLM-поиск рядом с ним и выпускать сгенерированный PTX только после численной и формальной проверки.
Источники
Иллюстрация: рисунок из статьи «AI as a Compiler: Compiling Triton kernels without the Triton compiler», Fran\c{c}ois Costa, Charly Castes, Thomas Bourgeat и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


