
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Промежуточное рассуждение языковой модели научились вычислять без последовательной генерации текста или скрытых векторов. Хотя препринт не проходил рецензирование и все числа в нём получили сами авторы, LLoCoT ускорила появление первого токена ответа примерно в 36 раз и подняла общую пропускную способность на 9,2% относительно обучения на текстовых цепочках рассуждений. Для систем с долгой паузой перед ответом это переносит узкое место с рассуждения на генерацию самого ответа.
Скрытые мысли обновляются вместе, а не слева направо
Обычная текстовая цепочка рассуждений остаётся последовательностью: модель не может сгенерировать следующий промежуточный токен, пока не получила предыдущий. Скрытое рассуждение убирает текст, но не обязательно устраняет эту зависимость. Например, NF-CoT тоже создаёт скрытые векторы по очереди.
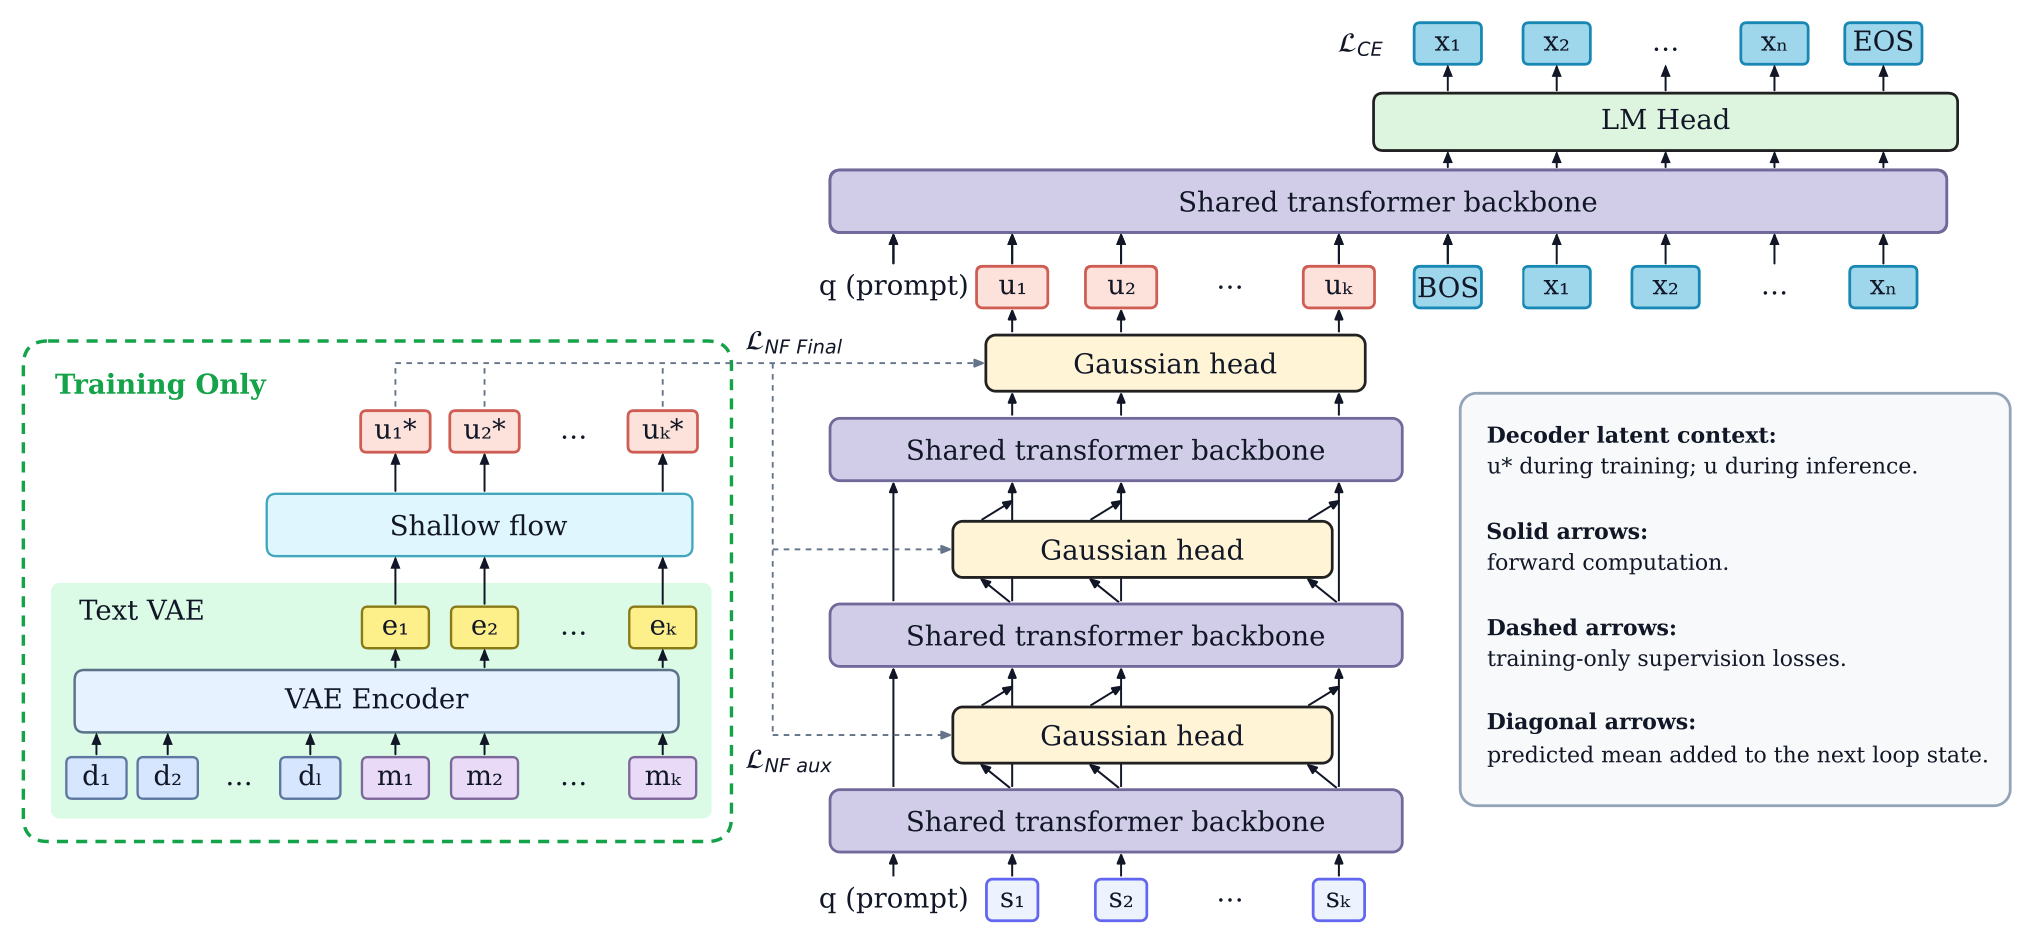
LLoCoT вместо цепочки поддерживает рабочее поле из обучаемых ячеек. Модель объединяет его с представлением запроса, пропускает через общий трансформер и одновременно обновляет все ячейки. Затем она возвращает полученные средние значения в рабочее поле и повторяет вычисление; в основной конфигурации достаточно двух проходов.
Проходы всё ещё зависят друг от друга, зато ячейки внутри каждого прохода вычисляются параллельно. Число параметров при этом не растёт с глубиной рассуждения: на каждом круге работает один и тот же трансформер.
Для обучения нужны готовые текстовые рассуждения. Отдельный вариационный автоэнкодер сжимает полную цепочку в непрерывное представление, а нормализующий поток переводит его в пространство, с которым работает языковая модель. Промежуточные состояния учатся приближать итоговое представление, а декодер одновременно учится выдавать правильный ответ.
Во время работы вариационный автоэнкодер и нормализующий поток не запускаются. LLoCoT уточняет рабочее поле, совместно получает итоговые скрытые векторы и передаёт их декодеру. Сам ответ декодер по-прежнему генерирует последовательно, поэтому метод ускоряет подготовку к ответу, но не устраняет задержку длинного вывода.
Скорость даёт параллельность, а не экономия вычислений
Качество проверяли на HumanEval, HumanEval+, MBPP и MBPP+ с моделью Qwen3-1.7B. LLoCoT получила лучший средний результат среди рассмотренных вариантов, превзошла NF-CoT на каждом тесте и осталась на уровне модели, обученной на явных текстовых рассуждениях: разница между ними находится в пределах погрешности.
Замеры скорости проводили на NVIDIA H100 с точностью bfloat16 и без пакетной обработки запросов. Первый токен ответа появлялся через 0,09 секунды против 3,17 секунды у текстовой цепочки. Сама фаза рассуждения сократилась примерно в 42 раза.
Ускорение не означает, что архитектура выполняет меньше арифметических операций. Она переносит работу из длинной последовательности коротких вызовов в несколько более крупных параллельных вычислений, которые GPU исполняет эффективнее. Цена такого обмена видна в памяти: пиковое потребление составило 6,3 ГиБ против 3,3 ГиБ у текстового варианта.
Эксперименты с глубиной также показывают, что дополнительные циклы сами по себе не улучшают ответ. Более глубокие конфигурации уступали короткой, поэтому рабочее поле нельзя считать способом произвольно наращивать вычисления во время запроса.
Командам стоит проверить архитектуру, но не менять базовый стек
Работа даёт практическое направление для продуктов, где пользователь долго ждёт начала ответа: помощников программиста, агентов и серверных API с рассуждающими моделями. Если основную задержку создаёт скрытая или текстовая подготовка, параллельное рабочее поле можно проверить как отдельную архитектурную ветку.
Это не настройка декодирования и не замена системного запроса. Потребуется обучать модель на полных цепочках рассуждений, готовить непрерывные целевые представления и согласовывать с ними декодер. Экономия при запуске частично переносит сложность в обучение.
Границы эксперимента пока узкие: использовали модель с 1,7 млрд параметров и четыре теста генерации кода. Результат не показывает, сохранится ли выигрыш на крупных моделях, в работе с документами, планировании или диалогах. Размер рабочего поля и глубину цикла также задают заранее, а не подбирают под сложность запроса.
Скрытое рассуждение нельзя прочитать и проверить как текстовую цепочку. Поэтому для продукта понадобятся внешние тесты качества и безопасности, даже если итоговые ответы на публичных задачах не стали хуже. На текущем этапе LLoCoT меняет план экспериментов с задержкой, но ещё не даёт основания заменить проверенную модель в промышленной системе.
Источники
Иллюстрация: рисунок из статьи «From Chain-of-Thought to Loops: Non-Autoregressive Latent Reasoning via Looped Transformers», Gerard Grau Garc\'ia, Arnau Padr\'es Masdemont, Niccol\`o Grillo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


