
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Поведение LLM научились менять точечным вмешательством только в те головки внимания и внутренние направления, которые связаны с нужным свойством текста. LocUS превзошёл обычное управление разностью средних в восьми из девяти сочетаний модели и задачи, хотя работа команды Université Côte d’Azur и Inria не рецензирована и числа получили сами авторы. Для продуктовой команды это вариант управлять токсичностью, тональностью или склонностью соглашаться с пользователем без дообучения всей модели, но с доступом к её внутренним активациям.
Словарь задаёт границы вмешательства
Стандартное управление активациями сначала собирает два набора примеров: с целевым свойством и без него. Затем система вычисляет средние внутренние представления для обоих наборов, берёт их разность и добавляет полученный вектор во время генерации.
Проблема в том, что два набора могут различаться не только токсичностью или тональностью. Вектор захватывает побочные признаки — тему, стиль, лексику — и вместе с нужным поведением меняет фактические знания, рассуждение или связность текста.
LocUS ограничивает вектор через матрицу преобразования внутренних представлений в словарь (unembedding matrix). Её столбцы соответствуют направлениям, из которых модель получает вероятности отдельных токенов. Набор слов, связанных с целевым свойством, образует словарное подпространство: для токсичности это могут быть направления слов, которые выражают оскорбление или ненависть.
В экспериментах словарь автоматически извлекали из контрастных данных, хотя метод допускает ручной список. Это даёт команде дополнительный рычаг: можно заранее убрать нежелательные направления, например слова, связанные с демографическими группами, а не с самим оскорбительным тоном.
Как LocUS выбирает головки и направления
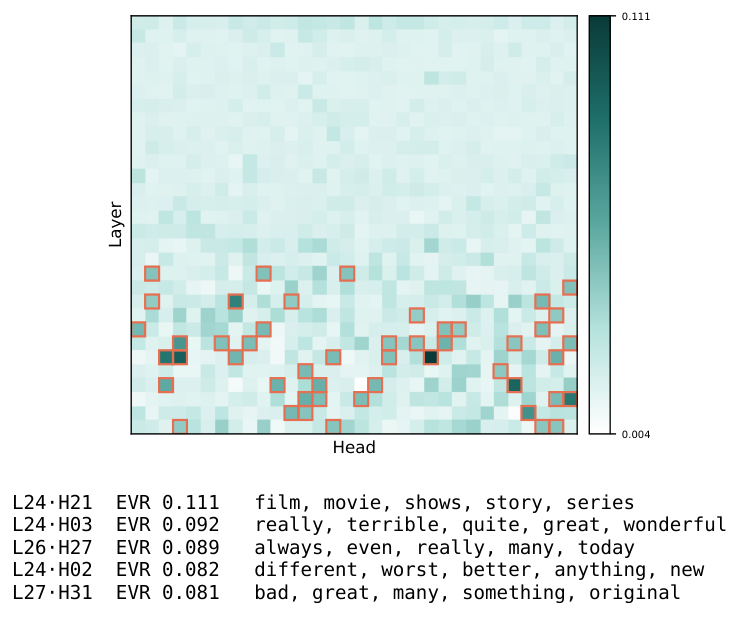
Метод пропускает калибровочные примеры через модель и собирает выход каждой головки внимания. Алгоритм разреженного приближения SOMP пытается восстановить эти выходы через небольшой общий набор словарных направлений. Чем большую долю вариации удаётся объяснить, тем сильнее головка связана с нужным свойством.
LocUS оставляет головки, чей результат выше среднего по модели более чем на два стандартных отклонения. Такой критерий не требует вручную задавать число мест вмешательства и отличает головки, которые записывают свойство во внутреннее представление, от головок, где его лишь можно распознать линейным классификатором.
После отбора метод переносит словарные направления из общего пространства модели во внутреннее пространство каждой головки. Для этого он учитывает выходную проекцию головки и нормализацию RMSnorm. Затем вектор разности средних проецируется только на выбранные направления и добавляется только в выбранных головках.
Авторы отдельно нормировали силу вмешательства относительно обычного метода и выбирали её на проверочной части данных. Вариант только с отбором головок давал основную часть улучшения, а проекция на словарное подпространство лучше сохраняла общие способности. Проекция без отбора головок работала хуже: вмешательство снова распространялось по всей модели.
Что меняется в планах продуктовой команды
Метод проверяли на трёх семействах моделей в задачах снижения токсичности, перенаправления тональности IMDb и подавления склонности соглашаться с позицией пользователя. Отдельный опыт провели на deepseek-67B. LocUS сравнивали с послойной разностью средних, ITI и SMH, а общие способности контролировали через MMLU и перплексию — показатель того, насколько уверенно модель предсказывает текст.
LocUS чаще сильнее сдвигал целевое поведение и лучше удерживал результат MMLU. Перенос настройки токсичности с корпуса Jigsaw также оказался лучше обычной разности средних на каждой проверенной модели. Значит, локализация не сводится к подгонке словаря и вектора под один тестовый набор.
Цена проявилась в связности текста. На крупнейшей модели перплексия выросла с 5,8 без вмешательства до 9,4 с LocUS. Работа оценивает общие способности только через MMLU и перплексию, поэтому не показывает, как метод влияет на длинные рассуждения, работу с инструментами или устойчивость диалога.
LocUS применим, когда целевое свойство выражается через лексику. Он подходит для токсичности и тональности, но не доказывает пригодность для правил, которые нельзя связать с набором словарных направлений.
Для внедрения нужны веса модели, выходы отдельных головок и калибровочные данные. Одного API генерации недостаточно. Дообучать веса не требуется, но команде придётся встроить изменение активаций в проход модели и поддерживать словарь для каждого управляемого свойства.
LocUS затрагивал не более 5,1% головок, а число независимых координат вмешательства составляло 0,4–0,8% от полного послойного варианта. Эти доли описывают точность локализации, а не ускорение: в работе не приведены замеры задержки и стоимости генерации.
Источники
Иллюстрация: рисунок из статьи «LocUS: Head Selection and Subspace Projection for Targeted Activation Steering», Irene Tallini, Lorenzo Basile, Valentino Maiorca и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


