
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Промежуточные шаги рассуждения LLM научились проверять до того, как модель выдаст весь ответ. Хотя работа не рецензирована и числа получили сами авторы, LogicTrack поднял у GPT-4o-mini долю корректных ответов с полностью проверенной цепочкой с 21,51% до 46,61%. Для внедрения такого контроля недостаточно подключить ещё одну модель-оценщик: рассуждение приходится переводить в формальную логику и пропускать через решатель.
Как LogicTrack проверяет отдельный шаг
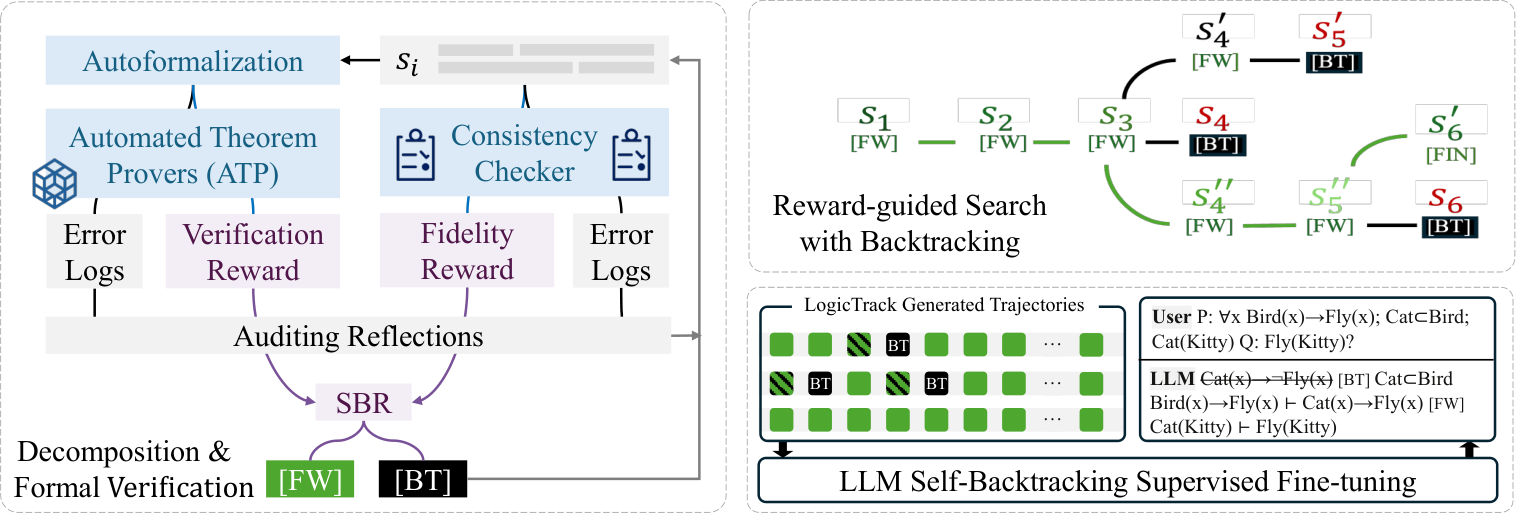
LogicTrack заставляет модель разбить каждый шаг на три части: использованные посылки, неявные предположения и новый вывод. Например, переход от «Алекс — отец» к «Алекс — родитель» должен отдельно указать фоновое правило о том, что отец является родителем.
Другая модель переводит эти части в спецификацию на языке SMT-LIB, которую может исполнить автоматический решатель теорем. Посылки и предположения становятся формулами, а вывод — целью доказательства. Затем решатель добавляет отрицание вывода: если получившийся набор формул несовместим, исходный вывод логически следует из посылок.
Проверка синтаксиса идёт отдельно. Если формализация составлена неверно, LogicTrack повторяет перевод; если решатель опровергает вывод, шаг получает нулевую оценку. Неопределённому результату дают частичный балл, поскольку он может означать как проблему рассуждения, так и предел возможностей решателя.
Итоговая оценка сочетает результат доказательства с верностью исходным посылкам. Вторую часть проверяет модель-оценщик: она ищет утверждения, взятые не из условия, неприемлемые бытовые допущения и противоречащие друг другу формулы. Поэтому LogicTrack формально проверяет связь между полученными формулами, но не устраняет риск того, что модель неверно перевела естественный язык или допустила лишнее предположение.
Возврат начинается в точке первой ошибки
После каждого шага контроллер сравнивает его оценку с порогом и одновременно следит за средней оценкой всей принятой цепочки. Успешный вывод добавляется в набор доступных фактов. Если один из порогов не пройден, модель получает журнал проверки и заново продолжает рассуждение с проблемного места, а не переписывает уже подтверждённый префикс.
Такой возврат отличается от проверки готового ответа. Ошибочный вывод не успевает стать посылкой для следующих шагов, поэтому решателю не приходится разбирать цепочку, в которой одна ранняя ошибка породила несколько последующих. Журнал также показывает, где именно остановилась проверка и какую формулу использовал решатель.
Метод проверяли на восьми наборах задач по логическому выводу на естественном языке и семи моделях, включая Gemini-2.5, GPT-4o-mini, GPT-5-nano, Llama-3.1-8B, Mistral-7B и две версии Qwen2.5. Основным сравнением служила обычная цепочка рассуждения без пошагового контроля.
LogicTrack улучшил результат в 133 из 168 сочетаний модели, набора и метрики. Проверка повышала не только долю подтверждённых шагов, но в большинстве условий сохраняла или увеличивала точность финального ответа. При этом отдельные сочетания дали ухудшение: формальная проверка не гарантирует, что поиск выберет правильный ответ для каждой задачи.
Меняет ли работа планы команд
Для систем, где ответ должен опираться на явно заданные правила, LogicTrack предлагает более проверяемую архитектуру, чем ещё один запрос к LLM с просьбой найти ошибку. В контур придётся включить структурированный формат рассуждения, модель формализации, решатель, контроллер возврата и журнал проверок. Это отдельный вычислительный цикл с повторной генерацией, а не замена системной подсказки.
Граница применимости проходит по формализуемости задачи. Эксперименты охватывают логические наборы с посылками, запросом и одним из нескольких отношений между ними. Работа не показывает тех же гарантий для открытых исследований, продуктовых рекомендаций или решений, где исходные правила нельзя выразить в логике без потери смысла.
Авторы также собрали около 6000 траекторий с ошибочными шагами, специальной командой возврата и проверенным продолжением. После дообучения с учителем (SFT) точность Llama-3.1-8B выросла с 56,81% до 68,08% относительно LogicTrack, работающего только во время генерации. Но внешний решатель всё равно лучше повышал качество отдельных шагов, поэтому дообучение пока не заменяет проверку там, где нужен аудируемый ход вывода.
Практический план — сначала выделить узкий класс решений с формальными правилами и сохранить текущую проверку финального результата. LogicTrack можно добавить перед выдачей ответа, чтобы останавливать локальные логические ошибки и записывать причину возврата. Переносить этот подход на весь продукт стоит только после проверки того, насколько точно формализатор передаёт предметные термины и допустимые предположения.
Источники
Иллюстрация: рисунок из статьи «LogicTrack: Auditing Reasoning Trajectories of Large Language Models with Formal Logic Solvers», Jingyu Hu, Shu Yang, Weiru Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


