
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Выбирать API для LLM-агента научились не только по смыслу запроса, но и по ожидаемому успеху и задержке до реального вызова. В препринте Beijing University of Posts and Telecommunications, который не рецензировался и содержит замеры самих авторов, Lookahead-R достиг 91,40% по NDCG@5 — на 1,24 пункта выше ToolGen в сложном сценарии ToolBench. Для архитектуры агента это означает новый промежуточный слой: он отсеивает рискованные инструменты до обращения к внешней системе.
Поиск инструмента стал задачей с бюджетом
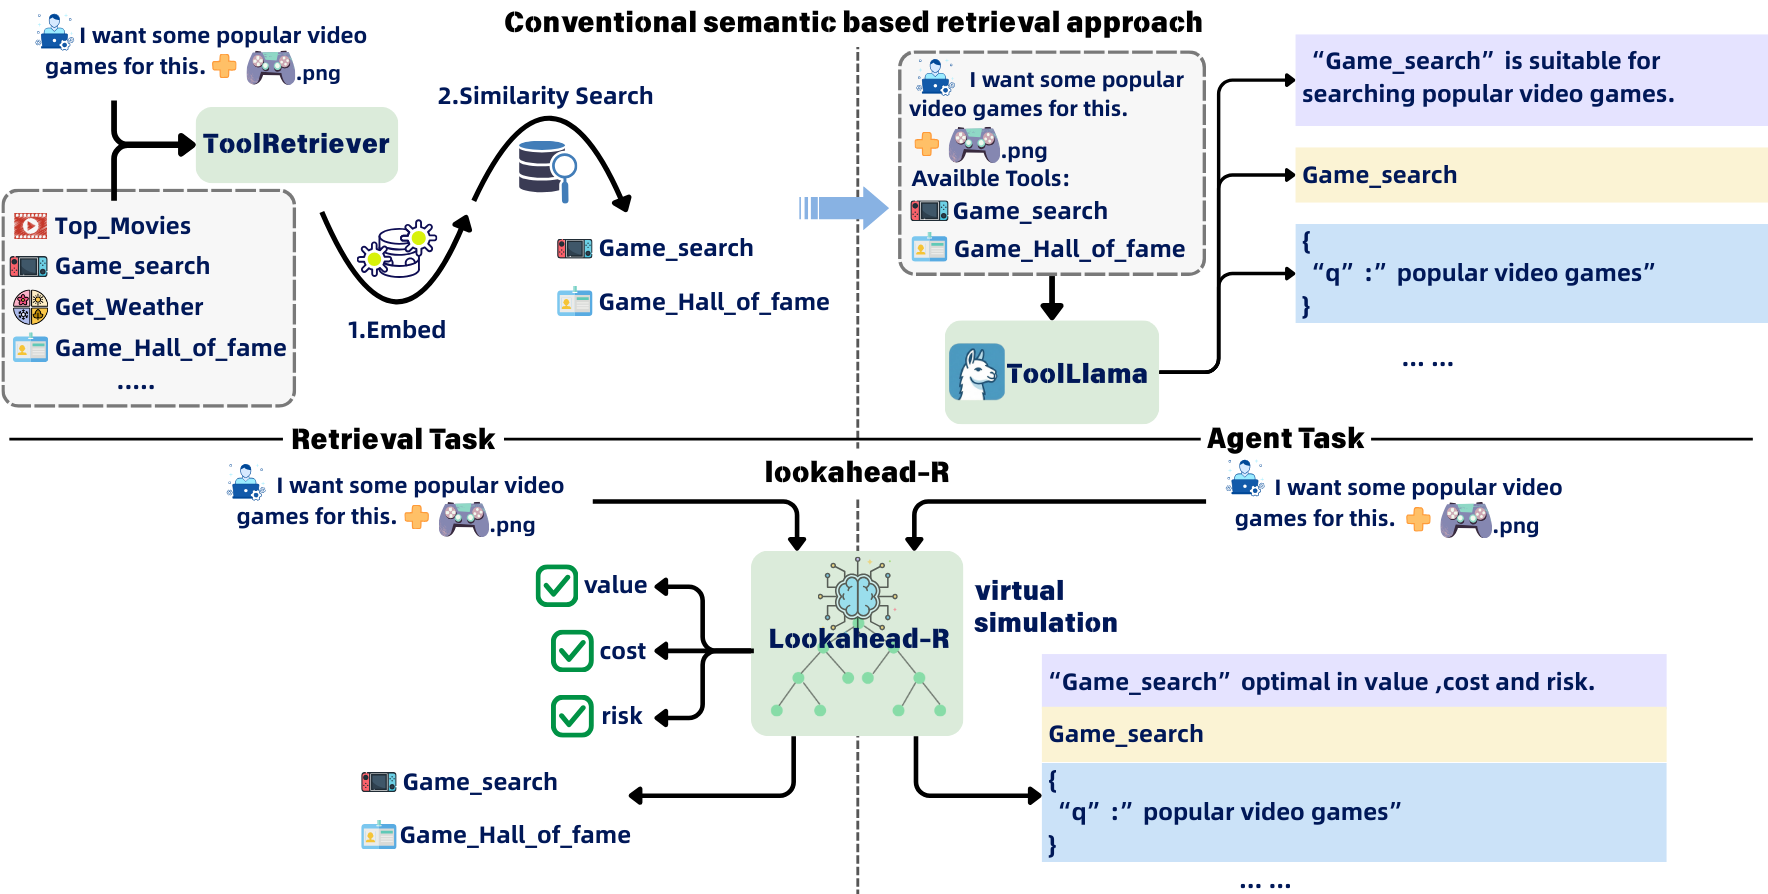
Обычный семантический поиск сравнивает запрос с описаниями инструментов. Он может поставить на первое место API с подходящими словами, хотя тот требует недоступный параметр, не принимает нужный тип данных или отвечает слишком медленно.
Проверять кандидатов настоящими вызовами надёжнее, но каждый вызов расходует время и деньги. Lookahead-R заменяет такие пробы планированием: выбор инструмента считается действием, у которого есть полезность, риск ошибки и стоимость по времени.
NDCG@5 измеряет качество первых пяти позиций выдачи и даёт больший вес правильным инструментам ближе к началу списка. Эта метрика подходит для первого этапа агента, которому важно передать генератору вызова короткий и правильно упорядоченный набор API.
Характерный пример из работы — запрос с изображением постера и вопросом о режиссёре. Поиск по тексту предпочитает инструмент для имени фильма, но тот ждёт строковый параметр и не умеет читать изображение. Lookahead-R прогнозирует ошибку параметра и выбирает инструмент, который принимает изображение, хотя исходный поиск поставил его ниже.
Как прогноз заменяет пробные вызовы API
В основе Lookahead-R лежит модель среды на базе Llama-3-8B. Её обучают по схеме «учитель — ученик» на трассах выполнения, которые содержат результаты, ошибки и задержки инструментов. Во время поиска модель получает запрос, схему API и историю действий, но не обращается к самому API.
Для каждого кандидата она формирует предполагаемый ответ, оценивает полезность и риск сбоя, а задержку относит к одной из категорий: мгновенно, быстро, медленно или превышение времени. Категории устойчивее точного прогноза в миллисекундах, который зависит от нагрузки и состояния внешней системы.
Эти оценки направляют поиск Монте-Карло по дереву. Алгоритм исследует несколько последовательностей инструментов, чаще возвращается к перспективным ветвям и вычитает предполагаемую задержку из оставшегося бюджета. Если стоимость превышает остаток, ветвь получает штраф; прогнозируемый сбой приравнивается к исчерпанию бюджета.
Планировщик можно остановить в любой момент: он вернёт лучший найденный вариант, а дополнительное время потратит на уточнение выбора. Это отличает его от генеративного поиска, которому сначала нужно закончить полный цикл ответа.
Что меняется в планах продуктовой команды
Главный результат абляционных тестов связан не с размером языковой модели, а с прогнозом исполнения. Когда у Lookahead-R отключили эту часть, доля успешных запросов упала на 17 пунктов. Когда метки задержки перемешали случайно, средняя реальная задержка выросла примерно на 65%: система всё ещё находила рабочие инструменты, но хуже избегала медленных.
Работу проверяли на ToolBench в сценариях I1, I2 и I3, которые различаются сложностью инструкций и сочетанием инструментов. Авторы измеряли качество ранжирования, успешность исполнения и результаты по журналам вызовов. Такой масштаб подтверждает архитектурную идею внутри этого стенда, но не заменяет проверку на задержках, ошибках и схемах конкретного набора API.
Для команды, которая уже строит агента, Lookahead-R не требует отказываться от семантического поиска. Тот остаётся дешёвым первым этапом и сокращает пространство кандидатов. Между ним и настоящим вызовом появляется модель, которая переупорядочивает короткий список с учётом исполнимости и бюджета.
Такой слой имеет смысл, если инструменты заметно различаются по задержке, цене ошибки или требованиям к параметрам. Для него понадобятся трассы с запросом, схемой инструмента, результатом либо ошибкой и фактическим временем ответа. Без данных из целевой среды модель рискует выучить свойства учебного набора, а не рабочей инфраструктуры.
Практический пилот можно ограничить теневым режимом: планировщик выбирает API параллельно действующей системе, но не влияет на вызов. Затем команда сравнивает долю успешных задач и задержку. Работа показывает, что бюджет стоит включать прямо в правило выбора, а не проверять уже после того, как агент построил дорогой план.
Источники
Иллюстрация: рисунок из статьи «Lookahead-R: Budget-Aware Tool Retrieval via Execution-Centric Planning», Zongze Wu, Yani Guo, Runnan Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


