
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Речевую модель научили учитывать интонацию при планировании ответа, не печатая промежуточные рассуждения. В препринте о LoopSLM, который не прошёл рецензирование и где числа получили сами авторы, модель обошла сопоставимое обучение с цепочкой рассуждений более чем на 20 процентных пунктов по точности. Такой подход позволяет тратить вычисления внутри модели, а не на генерацию служебного текста перед ответом.
Явное объяснение ещё не означает верное решение
В голосовом диалоге одной расшифровки недостаточно. Одинаковые слова могут звучать уверенно, раздражённо или неуверенно, и модель должна не только заметить этот сигнал, но и изменить ответ с его учётом.
Цепочка рассуждений (chain of thought, CoT) даёт модели промежуточный текст: какая интонация слышна, чего может хотеть собеседник, чем рискует неудачный ответ и какую стратегию выбрать. Такое обучение улучшало распознавание голосовых признаков, но не гарантировало, что модель использует их при выборе реплики.
На нескольких речевых моделях дообучение с CoT сделало ответы внимательнее к акустическим деталям, однако снизило точность рассуждений. Модель могла правильно описать неуверенный голос, а затем выбрать реакцию, которая не учитывала эту неуверенность. Кроме того, при обычной генерации ей приходилось сначала выводить служебную цепочку и только потом отвечать пользователю.
LoopSLM оставляет CoT в обучении, но убирает из рабочего запроса. Промежуточный план существует в скрытых представлениях модели и не превращается в токены, которые нужно последовательно сгенерировать.
Как цепочку рассуждений спрятали в повторные проходы
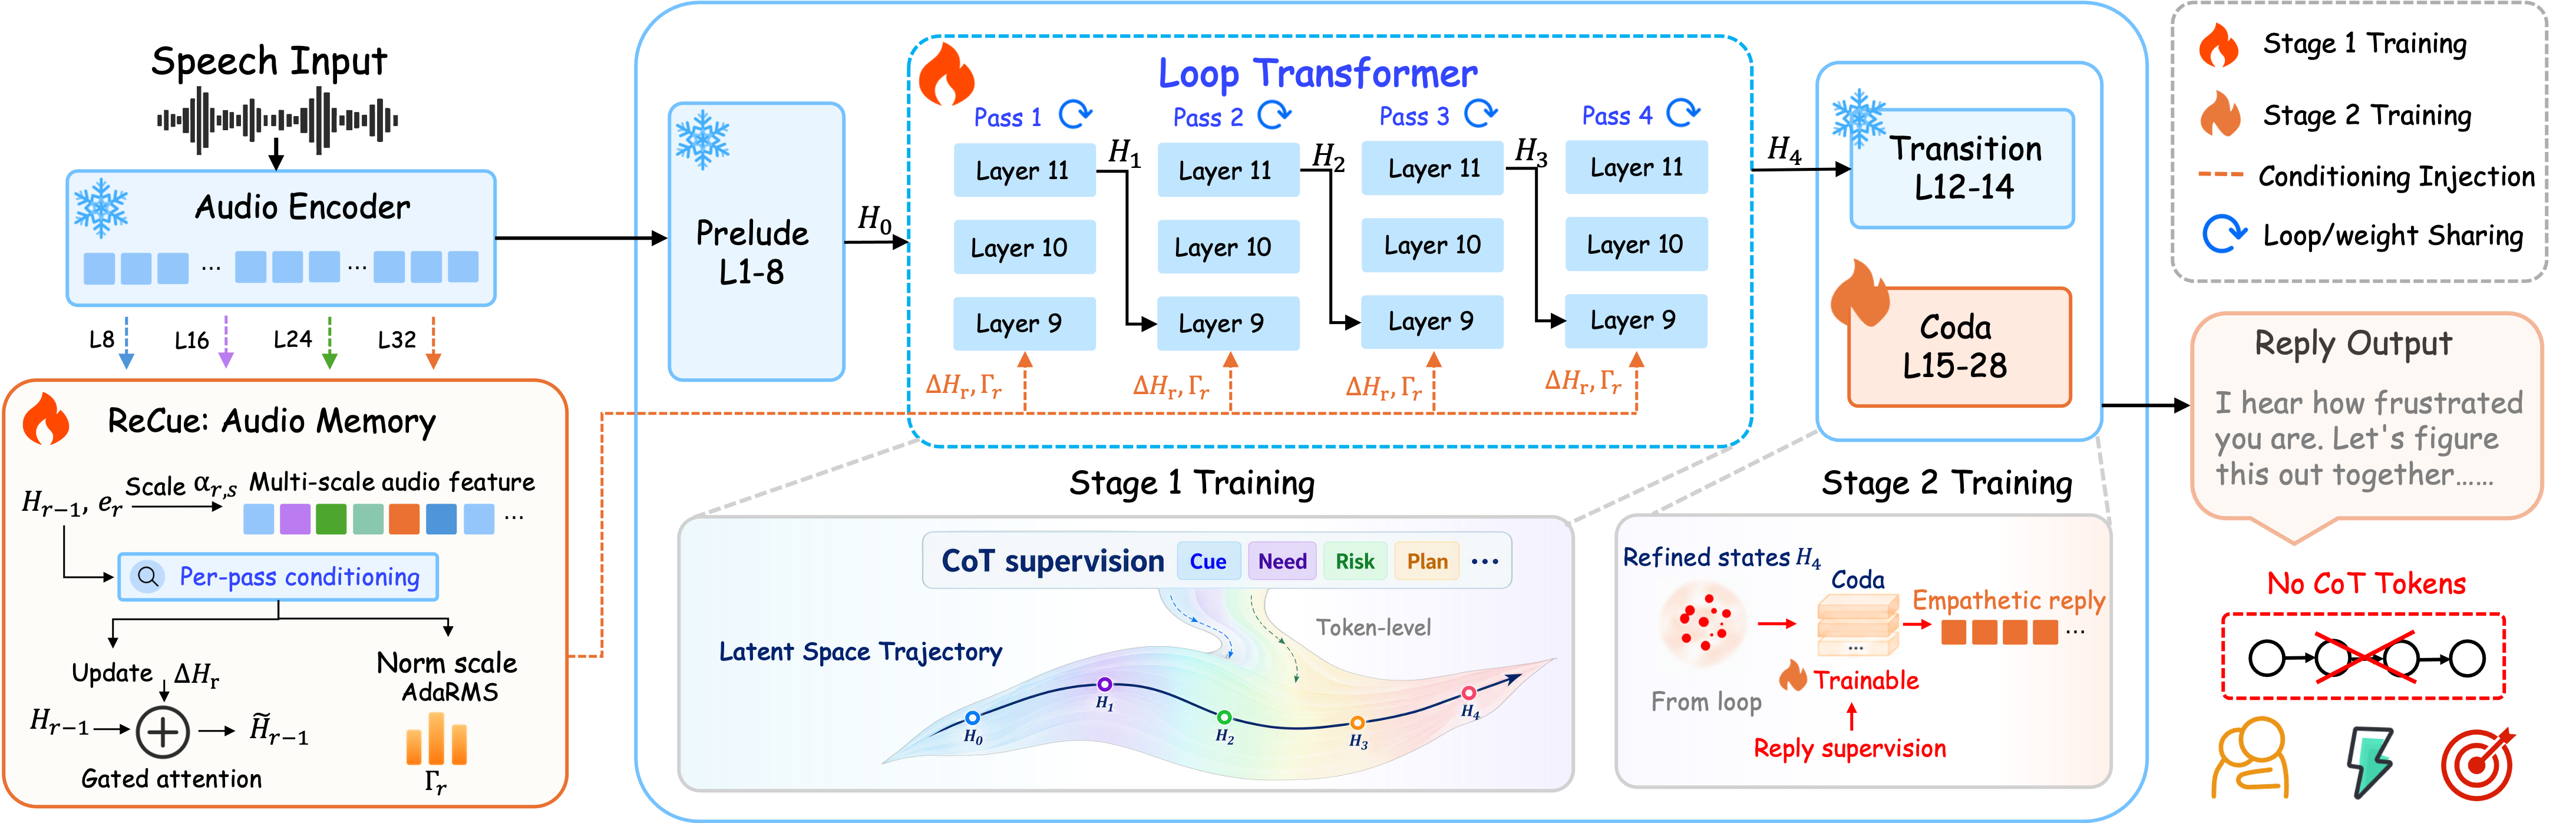
LoopSLM построили на Qwen2.5-Omni-7B. Небольшой блок ранних и средних слоёв декодера выполняется четыре раза с общими весами. Каждый проход уточняет текущее представление запроса, поэтому модель получает дополнительную глубину вычислений без новых позиций в последовательности и без отдельного текста с рассуждением.
Компонент ReCue при каждом проходе заново подаёт блоку признаки из аудиокодировщика. Это нужно, потому что сведения об интонации и качестве голоса ослабевают по мере продвижения через декодер. Без повторной привязки модель начинает рассуждать преимущественно по словам и хуже сохраняет акустический контекст.
Обучение разделено на две стадии. Сначала обновляются повторяемый блок и ReCue: модель получает размеченную цепочку, которая связывает голосовые признаки с потребностью собеседника, рисками и планом ответа. Затем эти компоненты замораживаются, а финальные слои учатся превращать уже подготовленное скрытое состояние сразу в реплику.
Разделение оказалось существенным. Совместное обучение на рассуждениях и ответах давало худший результат, а продолжение настройки повторяемого блока на второй стадии частично стирало выученную связь с акустикой. Простое добавление глубины тоже не помогало: обычные блоки при том же числе проходов уступали специально обученному повторяемому преобразованию.
Метод обучали на двуязычном наборе из 380 540 реплик на китайском и английском языках, причём большую часть аудио синтезировали. Проверку провели на EchoMind, SD-Eval, MMSU и MMAU-Pro; ответы в диалоговых заданиях оценивали DeepSeek V4 Flash и Gemini-3.7-Flash. Основное контролируемое сравнение использовало одну базовую модель и одни обучающие данные для LoopSLM и обычного дообучения с CoT.
Когда результаты меняют архитектурный план
По сравнению с обычным дообучением Qwen2.5-Omni-7B на тех же данных LoopSLM генерировала на 64,5% меньше токенов и отвечала вдвое быстрее. Это прямое следствие архитектуры: служебный план не занимает место в выходной последовательности, хотя дополнительные проходы по декодеру всё равно требуют вычислений.
Относительно исходной Qwen2.5-Omni-7B средняя точность понимания паралингвистических сигналов выросла на 9,8 процентного пункта, а точность рассуждений — на 6,6 пункта. В сравнении с Qwen3-Omni-Thinking модель выиграла по большинству метрик эмпатичного ответа при 34-кратно меньшей медианной задержке, но это уже сравнение систем разного размера и с разными режимами генерации.
Работа меняет планы команд, которые собирают голосового помощника с чувствительностью к интонации и уже рассматривают явный CoT. Цепочку можно использовать как обучающую разметку, а в рабочем контуре заменить повторным вычислением над скрытым состоянием. Это особенно уместно там, где задержка и длина ответа критичнее прозрачного текстового протокола рассуждений.
Метод пока проверен прежде всего на эмпатичных диалогах, на одной базовой архитектуре LoopSLM и на корпусе с преобладанием синтетической речи. Результаты на общих аудиозадачах показывают перенос за пределы диалога, но не превращают подход в готовую замену CoT для текста, кода или задач с инструментами.
Источники
Иллюстрация: рисунок из статьи «Thinking in Depth, Speaking Directly: Recurrent Latent Reasoning for Paralinguistically Grounded Spoken Dialogue», Shengbo Cai, Yuxiang Wang, Jingran Xie и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


