
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Аналитического агента научили проверять и исправлять программу, а не выдавать SQL или Python за один проход. Хотя препринт не прошёл рецензирование и все числа получили сами авторы, LYNX сократил расход токенов на 70,53% относительно прежнего самого экономного метода. Для продуктовой архитектуры это аргумент в пользу управляемого цикла генерации и проверки вместо одного сложного запроса к LLM.
Как LYNX привязывает запрос к схеме
Обычная генерация аналитического кода ломается не только на синтаксисе. Модель может выбрать не тот столбец, придумать атрибут, неверно соединить таблицы или написать исполняемый запрос, который отвечает не на исходный вопрос. Последний случай особенно опасен: база данных успешно возвращает результат, поэтому техническая проверка не замечает смысловую ошибку.
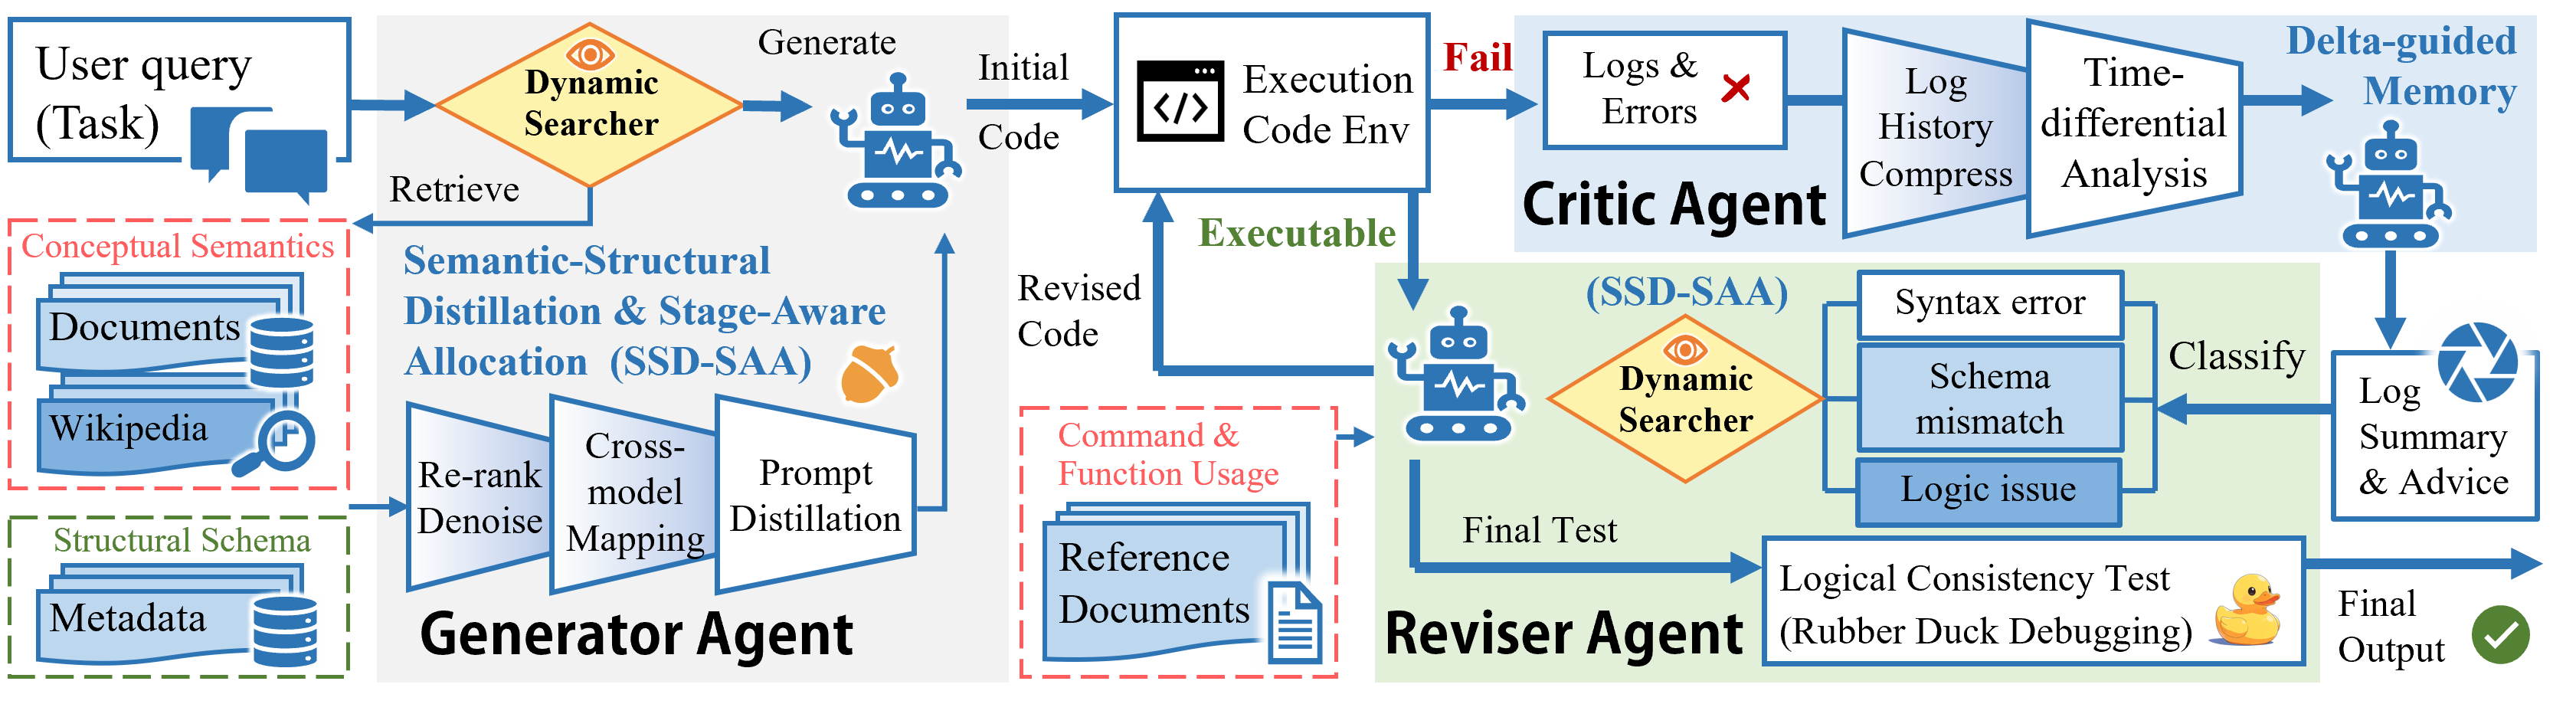
LYNX делит работу между тремя ролями: генератором, критиком и редактором. Генератор сначала разбирает цель запроса, затем связывает понятия с таблицами и полями и только после этого пишет программу. Сведения о предметной области, структура базы и правила синтаксиса поступают не одним длинным блоком, а на том этапе, где они нужны.
Перед генерацией система отдельно обрабатывает смысловые и структурные сведения. Документацию и найденные определения она ранжирует по релевантности, схему приводит к единому компактному виду, а затем связывает понятия с конкретными элементами базы. Одинаковые структуры можно свернуть, сохранив типы, отношения таблиц и другие условия, от которых зависит исполнение.
Такой порядок решает практическую проблему длинных подсказок: наличие документации в контексте ещё не означает, что модель применит её в нужном месте. LYNX сначала использует определения, чтобы понять запрос, затем передаёт описание схемы для выбора данных и лишь при написании кода добавляет правила операторов и синтаксиса.
Почему цикл правок не раздувает контекст
После первого варианта LYNX запускает программу и передаёт результат проверки критику. Тот различает ошибки синтаксиса, схемы и логики, а также смотрит, помогла ли предыдущая правка. Редактор получает локальную задачу на исправление, а не просьбу заново переписать весь код.
Система не добавляет в контекст полную историю запусков. Критик сжимает прежние версии кода и журналы ошибок, сохраняет выводы о неудачных исправлениях и добавляет свежую пару из программы и результата исполнения. Недавние события получают больший вес, поэтому агент может отслеживать ход отладки без постоянного роста подсказки.
Успешное исполнение не завершает процесс автоматически. Финальная проверка сопоставляет программу с исходным намерением и ищет случаи, когда корректный SQL возвращает не тот показатель, использует неверное условие или теряет зависимость между шагами. Замкнутый цикл здесь проверяет два разных свойства: может ли программа выполниться и решает ли она поставленную задачу.
В примере с количественным финансовым анализом тот же процесс применили к Python. Генератор загружал табличные данные и писал расчёт показателя, редактор исправлял ошибки исполнения, а критик оценивал ход отладки. Это показывает, что схема не привязана только к SQL, хотя основные сравнительные испытания работы относятся именно к преобразованию естественного языка в SQL.
Что результаты меняют в архитектуре продукта
Точность исполнения — доля задач, для которых сгенерированная программа даёт правильный результат после запуска. На Spider 2.0-Lite LYNX достиг до 51,13%, а на BIRD-SQL Mini-Dev — 49,40%. При этом один запрос требовал от 11,2 до 13,8 тысячи токенов на трёх основных моделях.
Проверяли открытые модели, включая Qwen3-14B, и коммерческие LLM. Основные условия охватывали два набора задач на генерацию SQL; отдельно разобраны количественный финансовый анализ и сложные запросы к нескольким связанным таблицам. Поэтому работа проверяет прежде всего архитектурный приём для аналитических программ, где результат можно исполнить и сопоставить со схемой.
Команде, которая строит аналитического агента, не обязательно начинать с трёх независимо развёрнутых моделей. Полезная единица проектирования здесь — разделение ролей и состояния процесса: генерация не должна одновременно понимать терминологию, выбирать поля, отлаживать код и подтверждать смысл результата.
Практический вывод касается и бюджета. Многократные обращения к LLM не обязаны стоить дороже одного прохода, если на каждом шаге передавать только нужные сведения и сжимать историю отладки. Для пилота разумно отдельно измерять правильность исполнения, смысловую верность и расход токенов: единая оценка скроет ситуацию, когда код запускается, но отвечает на другой вопрос.
Источники
Иллюстрация: рисунок из статьи «LYNX: Analytical Program Synthesis via Grounding and Closed-Loop Refinement», Ruichen Xia, Xiao Han, Dingyu Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


