
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Механизм, который помогает линейным языковым моделям удерживать длинные последовательности, одновременно толкает их запоминать обучающие соответствия вместо поиска ответа в текущем контексте. При слабом затухании Mamba лучше извлекает нужный инструмент, при сильном — устойчивее работает с последовательностями длиннее обучающих; работа пока не рецензирована, а все числа получили сами авторы. Для архитектуры продукта это аргумент не убирать затухание целиком, а настраивать его под расстояние до нужных данных.
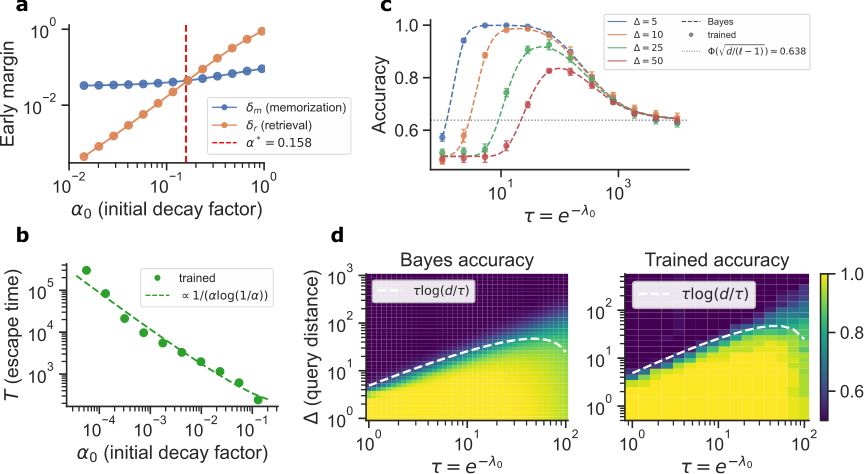
Модели пространства состояний (SSM) обрабатывают последовательность с линейными вычислительными затратами и памятью постоянного размера. Затвор управляет тем, как быстро модель забывает ранние элементы: сильное затухание ослабляет их сигнал, поэтому во время обучения проще сохранить соответствие во внутренних весах, чем освоить обучение из контекста (in-context learning). Если нужный элемент находится далеко от запроса, выход из такого режима может занимать экспоненциально больше времени.
Ослаблять затвор безусловно тоже нельзя. Когда модель почти не забывает прошлое, в её состоянии накапливаются посторонние элементы и заглушают нужный сигнал. Сильное затухание сокращает рабочую область контекста, зато позволяет обрабатывать последовательности длиннее тех, которые модель видела при обучении, если полезные данные расположены рядом с запросом.
Вывод проверили на синтетическом поиске пар, задаче с логическими правилами и вызове инструментов из BFCL. В последнем опыте сравнивали Mamba на 1,5 млрд параметров и Transformer на 2 млрд; модели обучали выбирать из наборов до 24 инструментов. У Mamba со слабым затуханием точность была выше, а вызовы отсутствующих в контексте инструментов встречались реже. В задаче с правилами обучение охватывало до 8 вариантов, а проверка — до 128: здесь сильное затухание лучше переносилось на длинные последовательности. Значит, подходящий режим зависит от структуры продукта: дальний точный поиск требует слабого затухания, а локальный поиск в растущем контексте выигрывает от сильного.
Источники
Иллюстрация: рисунок из статьи «On the Importance of Gating: Memorization vs. In-Context Learning in State Space Models», William L. Tong, Aryo Lotfi, Emmanuel Abbe и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


