
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Четырёхбитную Mamba для повышения разрешения изображений можно запускать быстрее без динамического пересчёта диапазонов промежуточных значений. В препринте Jinwoo Chung и Jangho Kim из Kookmin University, который не прошёл рецензирование, приведены их собственные замеры: Token-Group Quantization ускорил MambaIRv2-Light на Jetson Orin Nano в 2,23 раза относительно FP16. Для команд это схема посттренировочной квантизации, которая учитывает различия между позициями изображения, но сохраняет статический путь выполнения.
Почему одного диапазона на слой не хватает
Mamba обрабатывает изображение как последовательность пространственных позиций. Её операция selective scan обновляет внутреннее состояние в зависимости от входа, поэтому разные позиции после прохода получают заметно разные диапазоны активаций — промежуточных числовых значений модели.
Обычная посттренировочная квантизация назначает всему слою общие нижнюю и верхнюю границы. Если подстроить их под позиции с крупными значениями, шаг округления станет слишком грубым для остальных. Если сузить границы под типичные значения, важные для восстановления деталей сигналы обрежутся.
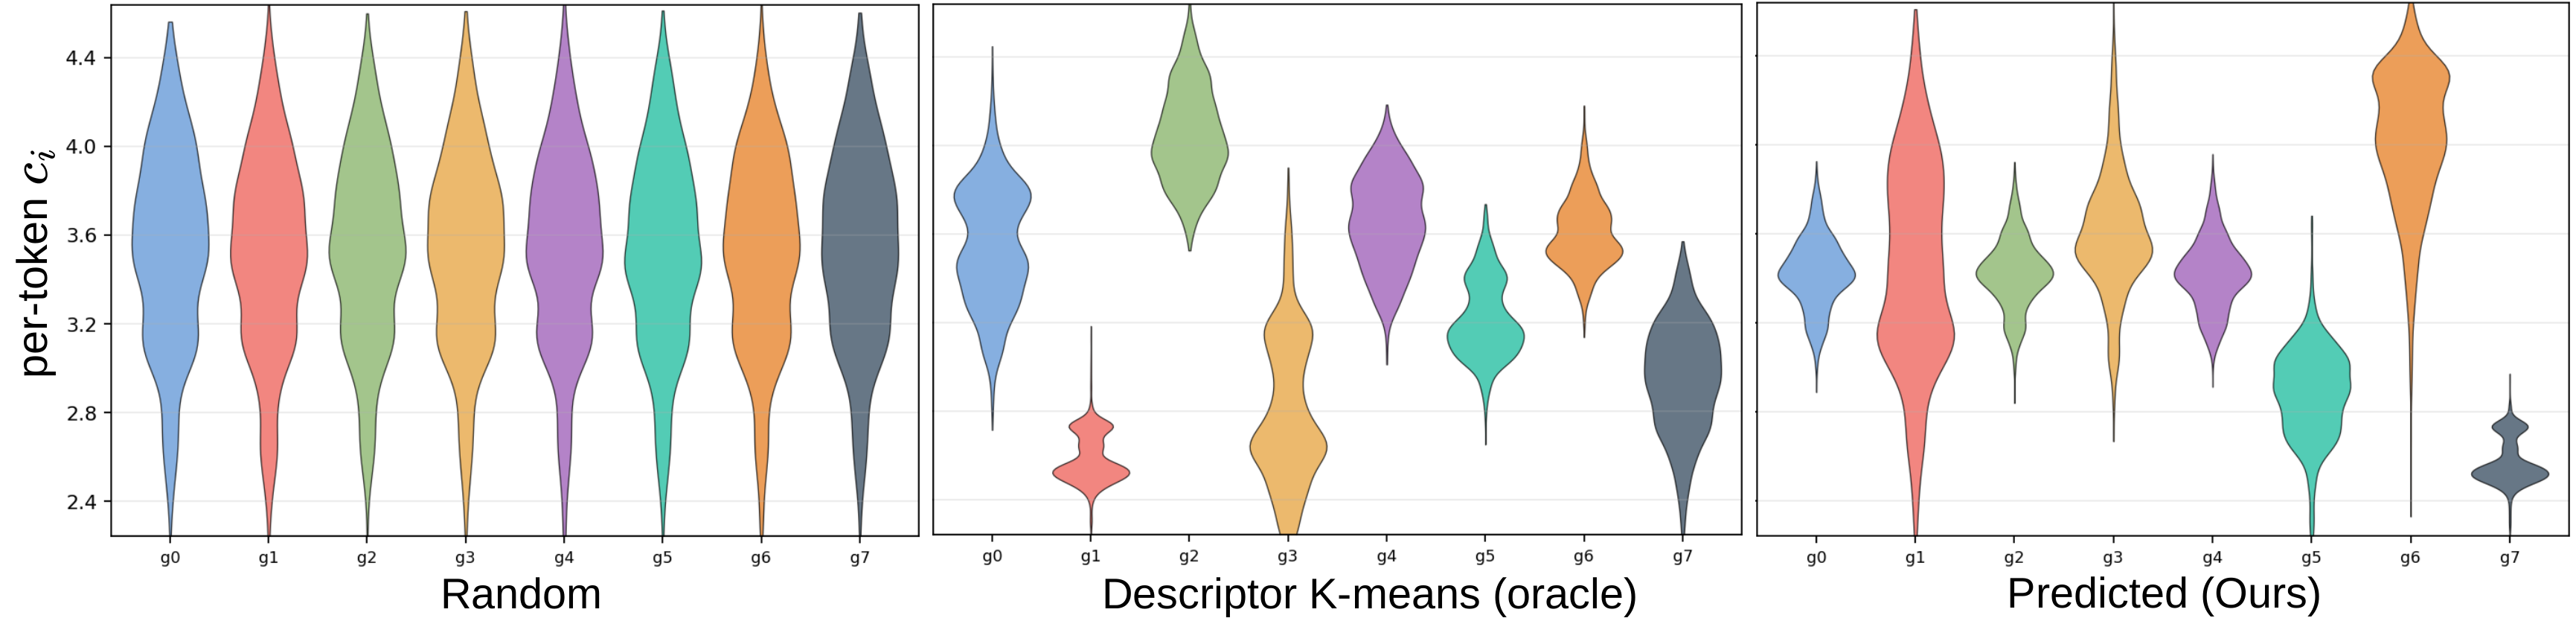
На MambaIRv2-Light разброс диапазонов вырос после selective scan в 18 из 20 блоков, в среднем — в 1,8 раза. Это указывает не на несколько случайных выбросов, а на устойчивое разделение позиций по подходящим режимам округления и обрезки.
Прямое решение — посмотреть на значения после selective scan, сгруппировать похожие позиции и подобрать каждой группе свои границы. Но такой вариант требует собирать статистику внутри уже квантизованного пути, а затем повторно выполнять часть вычислений. В аппаратных замерах статьи он лишился выигрыша в скорости.
Как перенести группировку из калибровки в статический инференс
Во время калибровки метод собирает значения после selective scan на участках, где различия между позициями особенно заметны. Для каждой позиции он описывает распределение несколькими характеристиками: квантилями абсолютных значений, среднеквадратичным уровнем и максимумом. Затем K-means объединяет позиции, которым подходят сходные границы обрезки.
Полученные группы служат не разметкой для рабочего инференса, а псевдометками для обучения небольшого двухслойного предиктора. Он видит признаки до selective scan и учится заранее определять группу позиции. Это возможно потому, что те же входные признаки задают параметры последующего обновления состояния Mamba.
После обучения предиктор замораживают. Для каждой комбинации слоя, участка квантизации и группы заранее рассчитывают отдельные границы. При выполнении модели предиктор только выбирает нужную строку из готовой таблицы: собирать статистику, менять границы или анализировать выход selective scan не требуется.
Авторы отдельно калибруют границы так, чтобы четырёхбитная модель сохраняла мелкие детали. Полноточная модель выступает учителем, а квантизированная подгоняет не только пиксели и внутренние признаки, но также амплитуду и фазу преобразования Фурье. Амплитуда отвечает за распределение энергии по частотам, а фаза помогает удерживать положение контуров и текстур. Веса основной модели при этом не меняются.
Меняет ли метод планы внедрения
Метод полезен, если продукт уже опирается на Mamba для восстановления изображений и должен работать на устройстве со статическими целочисленными ядрами. Он показывает, что адаптация диапазона к отдельным позициям не обязательно требует динамической статистики. Однако внедрение не сводится к замене формулы квантизатора: среде выполнения нужны выбор границ по номеру группы и соответствующие низкобитные ядра.
На NVIDIA RTX A6000 статический вариант работал в 1,70 раза быстрее FP16 и почти не отставал от обычного четырёхбитного пути. Калибровка MambaIRv2-Light заняла 1,42 часа вместо 1,29 часа у OAQ-SR. Добавление частотной функции потерь повысило качество на Urban100 ещё на 0,35 дБ по пиковому отношению сигнал/шум относительно варианта с сопоставлением пикселей и признаков.
Основные опыты охватывают MambaIR первого и второго поколений в размерах Light и Base, повышение разрешения, удаление шума и артефактов JPEG. Метод также перенесли на SwinIR-light и классификацию ImageNet с Vision Mamba, а группировку по позициям сочетали с преобразованиями по каналам. Сравнения включали посттренировочную квантизацию с замороженными весами и вариант с обучаемыми адаптерами.
Замеры задержки выполнены на двух устройствах NVIDIA с подготовленными целочисленными ядрами. Поэтому работа даёт основание пересмотреть схему квантизации для Mamba на похожем стеке, но не подтверждает такой же выигрыш на NPU, DSP, мобильных GPU и закрытых средах выполнения. Перед сменой архитектурного плана понадобятся собственные замеры всей цепочки, включая предиктор групп и обращения к таблицам границ.
Источники
Иллюстрация: рисунок из статьи «Hardware-Friendly Token-Group Activation Quantization for Low-Bit Mamba Super-Resolution», Jinwoo Chung, Jangho Kim, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


