
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Оценку ответа при обучении LLM можно отвязать от случайного состава соседних ответов и за тот же бюджет генераций точнее обновлять модель. В нерецензированном препринте, где числа получили сами авторы, MaPP прибавил до 2,45 пункта средней точности к результату сильнейшего метода сравнения. Для команд, которые дообучают модели через GRPO, работа предлагает точечную замену двух расчётов, а не новый учебный контур.
Почему один и тот же ответ получает разный вес
Обучение с проверяемой наградой применяют там, где ответ можно автоматически признать верным или неверным: например, в математике или задачах с заданным результатом. Модель генерирует несколько ответов на один учебный запрос, проверяющая программа назначает награды, после чего алгоритм обновляет модель.
GRPO обходится без отдельной модели, которая предсказывает ценность ответа. Вместо этого алгоритм вычисляет оценку преимущества — вес ответа при обновлении модели — через нормализацию наград внутри группы.
Из-за этого вес зависит не только от самого ответа. Правильный ответ рядом с преимущественно неправильными получает один вес, а тот же правильный ответ в более успешной группе — другой. Если вся группа ответила одинаково, градиент становится нулевым и генерации не помогают обучению.
Выбор учебных запросов решает лишь часть проблемы. Такие методы стараются не тратить бюджет на слишком лёгкие и слишком трудные запросы, но не устраняют случайность внутри уже сгенерированной группы. MaPP называет её шумом состава: даже при неизменной модели и известном результате ответа оценка преимущества продолжает колебаться из-за соседних ответов.
Как одно распределение очищает веса и выбирает запросы
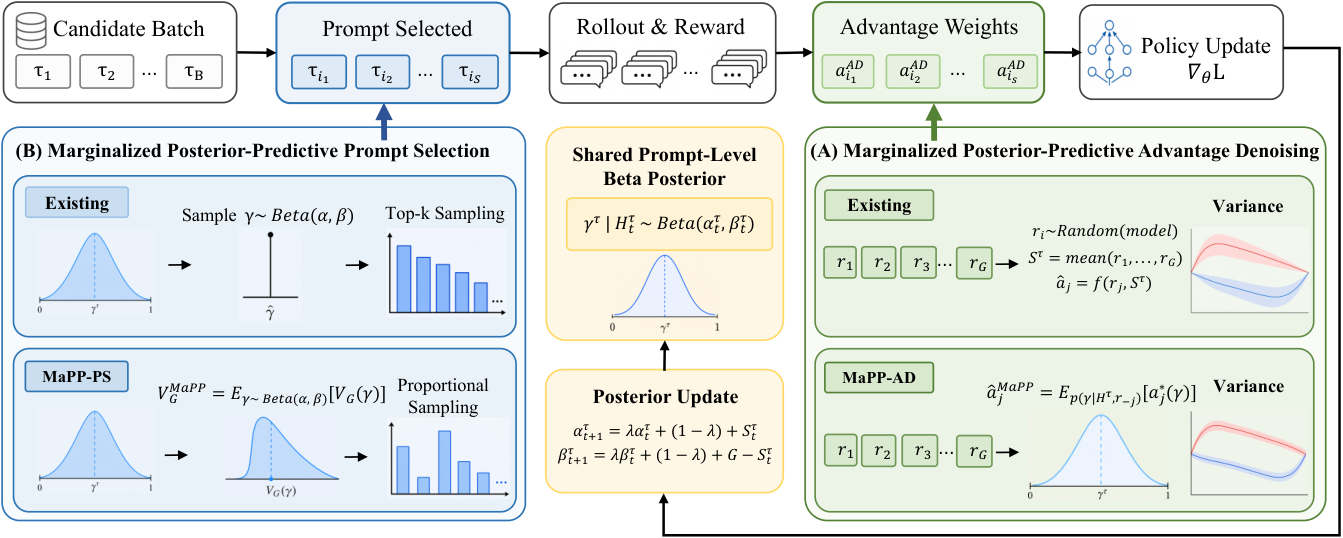
MaPP хранит для каждого запроса Beta-распределение вероятности правильного ответа. Оно обновляется по истории успехов и ошибок и отражает не только ожидаемую сложность запроса, но и уверенность в этой оценке. Подобное распределение уже используют некоторые методы онлайн-выбора запросов.
Первый компонент, MaPP-AD, не принимает фактический состав группы как единственно возможный. Он перебирает все правдоподобные соотношения правильных и неправильных ответов, взвешивает их по апостериорному распределению и усредняет оценку преимущества. Для каждого ответа расчёт исключает его собственную награду из распределения, чтобы ответ не влиял на вес, которым затем оценивают его самого.
В результате правильность ответа и предполагаемая сложность запроса определяют его вес, а случайные соседи — нет. По теоретическому результату работы ошибка такой оценки уменьшается по мере накопления истории, тогда как у обычного GRPO остаётся ненулевая составляющая шума.
Второй компонент, MaPP-PS, использует то же распределение для выбора запросов. Вместо одной оценки сложности он вычисляет вероятность получить смешанную, полезную для обучения группу. Широкое распределение снижает итоговый балл: метод реже тратит генерации на запрос, который выглядит подходящим только из-за неопределённой оценки.
Оба расчёта имеют замкнутую математическую форму. Поэтому MaPP не требует дополнительных ответов модели и не добавляет отдельную обучаемую сеть, хотя хранение и обновление состояния для каждого запроса остаётся частью контура.
Когда MaPP меняет планы обучения
Метод проверили на пяти базовых моделях в трёх областях: математике, планировании и визуальной геометрии. Во всех опытах использовали бинарную награду и сравнивали MaPP с GRPO, а также с методами, которые фильтруют запросы после генерации или прогнозируют их полезность заранее.
При одинаковом бюджете генераций MaPP во всех представленных сериях обошёл методы сравнения. В опыте с CountDown и Qwen3-4B он потребовал на 80% меньше генераций, чем Dynamic Sampling, чтобы получить сопоставимое качество. Это существенный результат для контуров, где именно генерация ответов, а не вычисление весов, занимает основную долю расходов.
Если система уже ведёт байесовскую историю по каждому учебному запросу, MaPP можно рассматривать как модульную доработку: заменить групповую оценку преимущества и функцию выбора запросов, сохранив GRPO и прежний проверяющий модуль. На архитектуру готовой модели и её работу при выдаче ответов метод не переносится — он меняет только дообучение.
Для нового контура результат поддерживает решение сразу проектировать общее состояние запроса для оптимизации и распределения бюджета. Для существующего контура без онлайн-выбора запросов потребуется добавить такое состояние, поэтому экономию генераций нужно сопоставить со сложностью хранения истории и интеграции.
Границы применимости задаёт проверка экспериментов: награда была бинарной, а задачи допускали автоматическую проверку. Расширение на несколько уровней награды в статье выведено математически, но экспериментально не проверено. Поэтому MaPP пока не даёт основания менять обучение с субъективными оценками или сложной составной наградой.
Источники
Иллюстрация: рисунок из статьи «MaPP: A Unified Marginalized Posterior-Predictive Framework for Data-Efficient RLVR», Yangyang Ren, Haodong Zhu, Sheng Xu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


