
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одинаковая точность прогноза не означает, что модели одинаково представляют состояние финансового рынка. Согласно препринту Humzah Merchant и соавторов, который не рецензирован и содержит их собственные замеры, лучшие прогнозисты не всегда лучше сохраняли связи между компаниями, торговыми днями и рыночными факторами. Для финансовой модели мира это меняет критерий выбора энкодера: одного теста на будущую доходность недостаточно.
Market-1T охватывает разные режимы рынка
Авторы собрали Market-1T — почти триллион наблюдений по акциям, которые торговались в США с 2008 по 2025 год. Исходные котировки и сделки сведены к секундным интервалам, поэтому из одной истории можно строить представления с разным временным масштабом без интерполяции.
Каждое наблюдение описывает лучшие цены покупки и продажи, доступные объёмы, цены сделок, торговый объём и число сделок. Эти признаки дают модели информацию о цене, ликвидности, волатильности и активности рынка, а не только последовательность закрытий свечей.
Полный набор охватывает все американские листинги, но эксперименты проводят на сравнительно ликвидных обыкновенных акциях. Состав этого набора пересчитывают каждый месяц только по предыдущим данным. Такой порядок не оставляет в истории лишь компании, которые дожили до конца периода, и не подмешивает сведения из будущего.
Финансовая модель мира должна сжимать наблюдаемое состояние рынка так, чтобы поверх него можно было прогнозировать развитие событий и выбирать действия. В этой работе исследуют первый слой такой системы: энкодер превращает временной отрезок торгов в компактный вектор. Динамику рынка и последствия конкретных действий поверх этих векторов пока не моделируют.
Как отделили качество прогноза от устройства представления
Все методы оценивали на 32 месяцах, выбранных по всему временному диапазону. Перед каждым проверочным периодом модель обучали только на предшествующих шести месяцах, а параметры подбирали на отдельных периодах. Это важное отличие от проверки на одном удобном отрезке: трудность прогнозирования заметно меняется вместе с рыночным режимом.
Поверх замороженного представления обучали простой линейный слой. Он предсказывал будущую доходность, изменение волатильности и изменение разницы между лучшей ценой покупки и продажи на горизонте 15 минут. Качество измеряли ранговым коэффициентом информативности: он показывает, насколько порядок прогнозов совпадает с порядком фактических результатов по акциям.
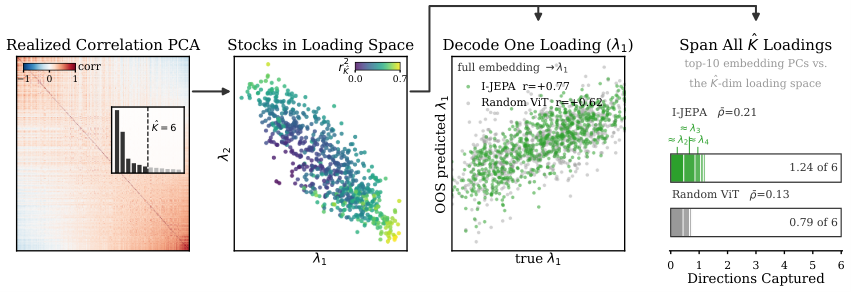
Отдельные проверки смотрели внутрь представления. Они измеряли, группирует ли энкодер записи одной компании, одного дня или одной отрасли, а также сохраняет ли совместные движения цен разных акций. В сравнении участвовали 18 стратегий: обучение с целевой разметкой, несколько способов самостоятельного обучения без разметки, готовые модели временных рядов и необученный ViT как нижняя планка.
Границы эксперимента проходят по американским акциям и историческим котировкам со сделками. Работа сравнивает представления состояния, а не готовые торговые системы: доход после комиссий и исполнения зависит также от построения портфеля, управления риском и фактической цены сделки.
Командам нужен набор проверок вместо одного рейтинга
Места методов по точности прогноза и по организации внутреннего пространства связаны слабо: коэффициент составил −0,19. Энкодеры с близкими прогнозами могли хранить принципиально разную картину рынка. Значит, итоговый показатель на одной целевой задаче не раскрывает, пригодно ли представление для планирования.
Различия возникали даже из-за способа формировать обучающие примеры. Когда модель сопоставляла разные фрагменты торгов одной акции, она лучше запоминала конкретную компанию через характерные объёмы заявок. Когда ей показывали разные акции в один момент, она сильнее выделяла общее движение рынка и меньше внимания уделяла идентичности отдельной бумаги.
Период проверки влиял на результат сильнее случайной инициализации: для каждой целевой задачи месяц объяснял не менее 97,2% наблюдаемого разброса. Поэтому проверка на одном недавнем периоде может дать команде ложного победителя, даже если эксперимент несколько раз повторили с разными начальными весами.
Увеличивать модель автоматически тоже невыгодно. При одинаковом вычислительном бюджете ViT-Tiny обошёл ViT-Base, который получил в десять раз больше вычислений. В этом масштабе полезнее сначала проверить объём доступного сигнала и частоту переобучения, а не выбирать более крупную архитектуру.
Работа меняет планы команд, которые строят не отдельный прогноз, а основу для финансового агента или модели рынка. В критерии приёмки стоит включить разные временные режимы, необученный энкодер как базовый уровень и проверки структуры: день, компания, отрасль и совместное движение активов. Если системе предстоит оценивать ликвидность, риск и последствия сделки одновременно, энкодер следует выбирать по всей этой матрице, а не по единственной корреляции будущей доходности.
Источники
Иллюстрация: рисунок из статьи «Towards Financial World Modeling», Humzah Merchant, Alec Guthrie, Simon Mahns и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


