
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
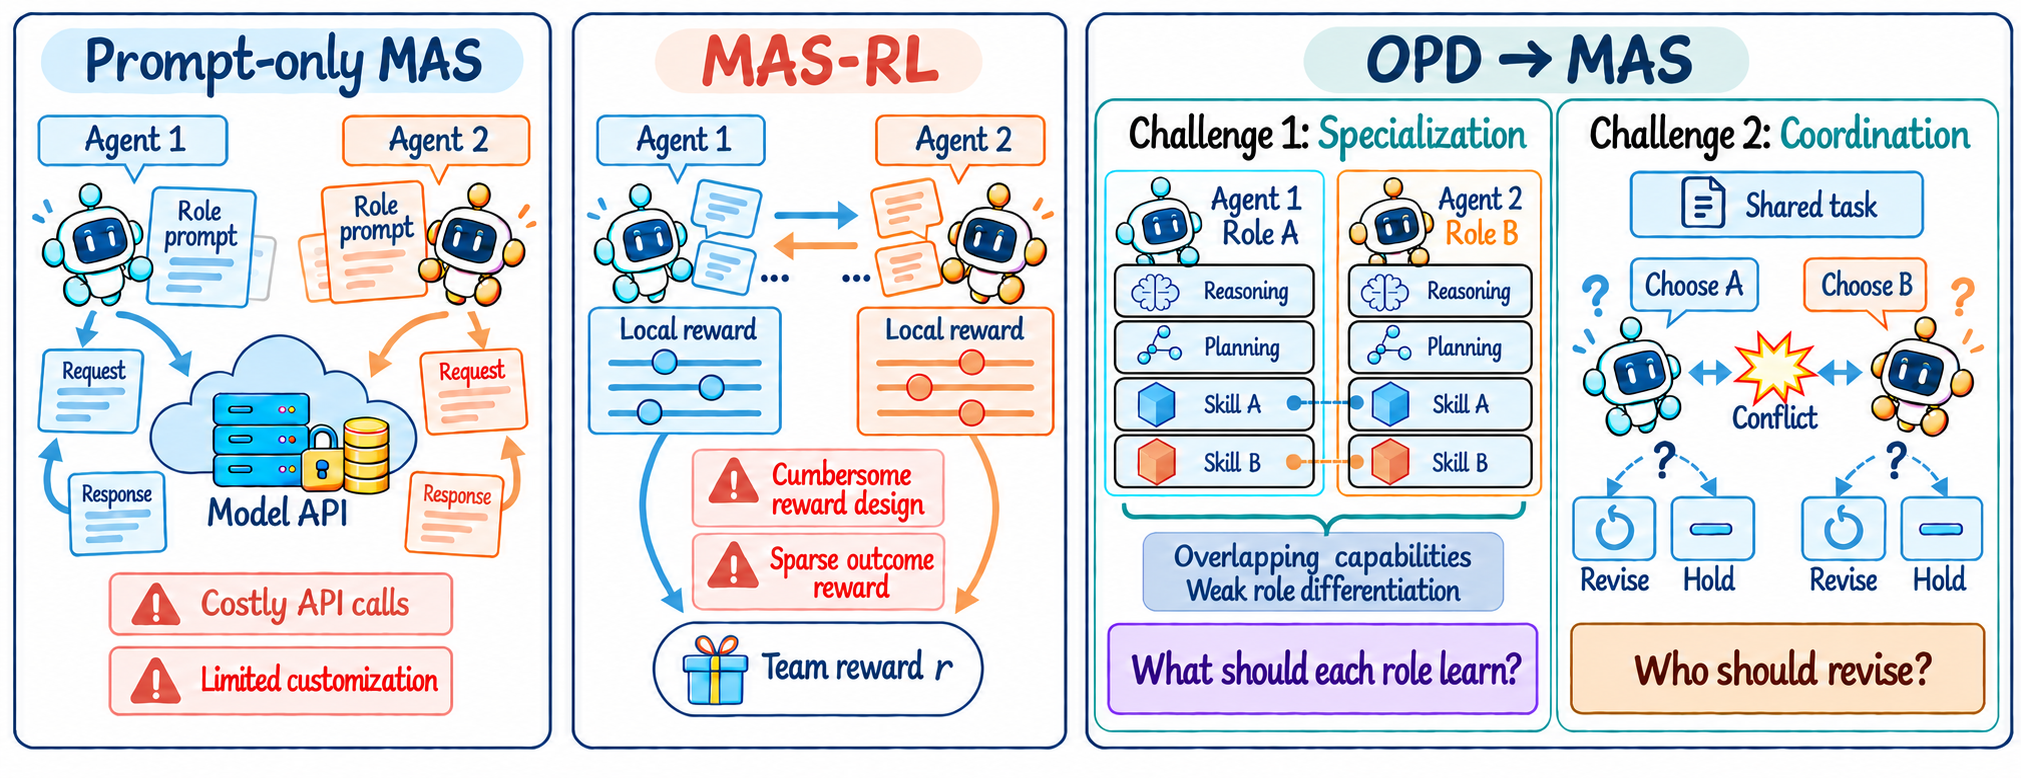
Малые языковые модели научили разделять обязанности и согласованно исправлять ошибки после совместного обучения. Хотя препринт Qiyong Zhong и коллег не рецензирован и все числа получили сами авторы, MAS-OPD показал лучший средний результат на всех шести тестах при обоих размерах моделей. Метод предлагает альтернативу системам, где роли задают только подсказками, а поведение агентов связывают программной оркестрацией.
MAS-OPD использует дистилляцию на собственных траекториях (on-policy distillation): ученики выполняют задачу, а более крупная модель-учитель оценивает каждый созданный ими токен. Чтобы агенты не копировали один и тот же набор навыков, учитель рассматривает ответ сначала от лица нужной роли, затем от лица соседней. Разница между оценками усиливает поведение, подходящее конкретному агенту, но сохраняет знания, которые нужны всей системе.
Вторая часть метода отвечает за координацию. Во время обучения автоматическая проверка определяет, какой ответ вызвал конфликт, и передаёт этот вердикт только учителю. Ученики видят обычную историю диалога и должны воспроизвести исправление без подсказки; после обучения проверка и дополнительные сведения не нужны. Так система усваивает не только отдельные навыки, но и решение о том, кто должен пересмотреть ответ, а кто — оставить его без изменений.
Метод проверяли на Qwen3 с учениками на 1,7 млрд и 4 млрд параметров и учителем на 14 млрд. Два агента работали параллельно: программист с тестировщиком в задачах на код и рассуждающий агент с пользователем инструментов в математике. На LiveCodeBench версия с Qwen3-4B набрала 32,11 пункта против 28,23 у ближайшей альтернативы; средние значения считали по пяти независимым запускам. Эти результаты относятся к такому двухролевому процессу и автоматической проверке кода и ответов.
Источники
Иллюстрация: рисунок из статьи «MAS-OPD: On-Policy Distillation for Multi-agent Systems», Qiyong Zhong, Mao Zheng, Mingyang Song и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


