
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для блочных диффузионных языковых моделей научились сокращать KV-кэш, не сохраняя всю историю генерации. В работе Gleb Molodtsov и коллег MaskAhead уменьшил средний объём KV-кэша в 9,5 раза при потере 1,2 пункта F1, хотя препринт не рецензирован, а числа в нём получили сами авторы. Метод позволяет по-разному управлять памятью и вычислениями, а не связывать их одним лимитом.
Как маски предсказывают ценность записей кэша
Блочная диффузионная модель генерирует блоки последовательно, но внутри каждого блока восстанавливает сразу несколько скрытых токенов. Завершённые блоки образуют причинный контекст, поэтому модель хранит их ключи и значения в KV-кэше и повторно читает его на каждом шаге восстановления.
Длинный контекст создаёт две разные затраты. Во-первых, весь кэш занимает память GPU. Во-вторых, модель многократно читает растущий набор записей. Прежние методы разреженного чтения могли выбирать небольшую часть кэша для текущего блока, но оставляли полную историю в памяти или переносили её в оперативную память сервера.
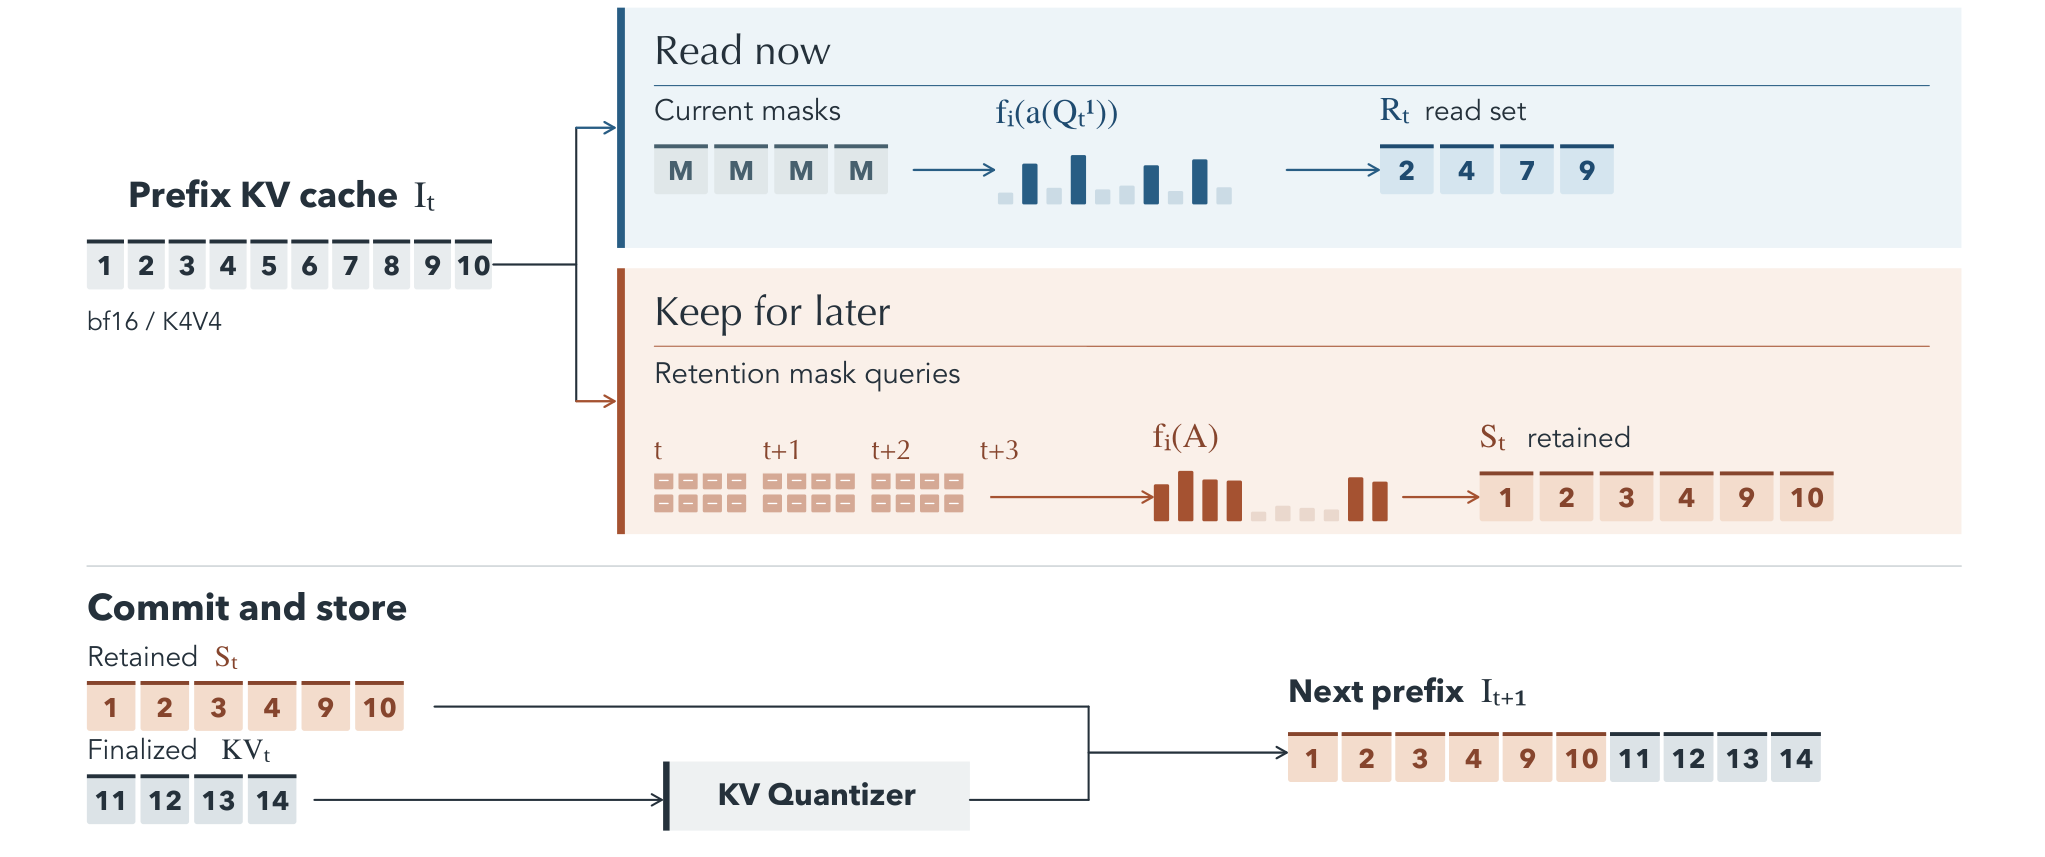
MaskAhead разделяет временный выбор записей и необратимое вытеснение. Маски текущего блока показывают, какие ключи и значения понадобятся во время его восстановления. Дополнительный проход с масками на позициях будущих блоков оценивает, какие записи следует оставить после физического уплотнения кэша. Этот проход не создаёт черновые токены и не дописывает данные в постоянный кэш.
Обе операции используют одну оценку важности. Она учитывает не только массу внимания, но и то, насколько значение конкретной записи меняет итоговый результат механизма внимания. Поэтому две записи с одинаковым весом могут получить разные места в рейтинге.
Начальные и недавние позиции метод защищает от удаления. Остальные записи ранжирует отдельно для чтения текущим блоком и для длительного хранения. Обучать модель или дополнительные адаптеры для этого не требуется.
Q-MaskAhead добавляет 4-битное хранение ключей и значений. Ранжирование и механизм внимания работают прямо с этим представлением: полной копии кэша в bf16 рядом нет. Это принципиально отличает вариант от схемы, где сначала выбирают записи в высокой точности и лишь затем сжимают их.
Сжатие памяти не гарантирует такой же ответ
Среди методов, которые действительно удаляют записи, MaskAhead показал лучший F1 во всех основных конфигурациях длинного вопросно-ответного теста, в одном случае разделив первое место. Q-MaskAhead увеличил среднее сокращение памяти до 20,1 раза, но потеря относительно полного кэша выросла до 2,3 пункта F1. Квантование почти сохраняло состав выбранных записей, однако искажение самих ключей и значений всё равно влияло на ответы.
В системном профиле при пакете из 32 запросов обычный MaskAhead ускорил этап декодирования в 1,68 раза, а весь запрос — в 1,23 раза. Одно лишь хранение полного кэша в низкой точности такого ускорения не дало: модель продолжала обрабатывать всю логическую историю. Выигрыш появился, когда она одновременно читала меньше записей и удаляла ненужные.
На задачах математического рассуждения результат сильнее зависел от бюджета. При жёстком лимите MaskAhead заметнее выигрывал у политики, которая сохраняет записи по накопленному вниманию, но при более свободном кэше другой метод с учётом значений мог оказаться лучше. Увеличение бюджета чтения иногда возвращало качество без роста постоянного кэша, поэтому объём хранения и число читаемых записей стоит настраивать отдельно.
Метод проверяли на Fast-dLLM-v2, DreamReasoner и LLaDA2.0-mini. Набор задач охватывал математические ответы, вопросы по длинному контексту и поиск фрагмента внутри большого текста. Профиль скорости проводили отдельно от оценки качества, с фиксированной длиной вывода и без естественной остановки генерации, поэтому он показывает эффект механизма, а не готовую пропускную способность сервиса.
Когда MaskAhead меняет архитектурный план
Работа касается именно блочных диффузионных моделей. Для обычной авторегрессионной LLM результат нельзя переносить напрямую: у неё нет масок будущих блоков, из которых MaskAhead получает прогноз. Если команда уже выбрала блочную диффузию для длинных ответов или контекстов, работа меняет устройство слоя инференса.
Вместо одного лимита кэша понадобятся два: сколько записей читать сейчас и сколько хранить до следующего вытеснения. Сервис также должен поддерживать пробный проход по будущим маскам, временный буфер чтения и физическое уплотнение KV-кэша. Такой план сложнее простого квантования, зато сокращает и занимаемую память, и повторные чтения.
Для длинных входных документов остаётся отдельная развилка. В основных тестах модель сначала обрабатывала весь контекст и только затем сжимала кэш, поэтому пик памяти на этом этапе оставался близок к плотному режиму. Раннее вытеснение с запросом в качестве подсказки сохраняло больше качества, чем обработка документа независимыми фрагментами, но сочетание этого режима с низкой точностью заметно ухудшало ответы.
Практический вывод — сначала проверять MaskAhead без квантования на собственных длинах контекста и пакетах запросов. Если качество держится, низкую точность следует добавлять как отдельный этап испытаний: она даёт следующий кратный выигрыш по памяти, но не считается бесплатной даже при почти неизменном наборе выбранных записей.
Источники
Иллюстрация: рисунок из статьи «Mask-Guided KV Cache Eviction in Block Diffusion Language Models», Gleb Molodtsov, Ekaterina Alimaskina, Evgeny Uskov и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


