
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
MoE-модель научили чаще повторно использовать одних и тех же экспертов, не запрещая ей обращаться к остальным. Команда Junfeng Wu представила метод MaskCoFT: эффект оказался заметнее на Mixtral-8×7B, чем на DeepSeek-V2-Lite, но работа пока не рецензирована, а все числа получили сами авторы. Для команд, которые выгружают часть весов в оперативную память, это переносит оптимизацию с уровня системы внутрь самой модели.
Почему кэш не решает проблему маршрутизации
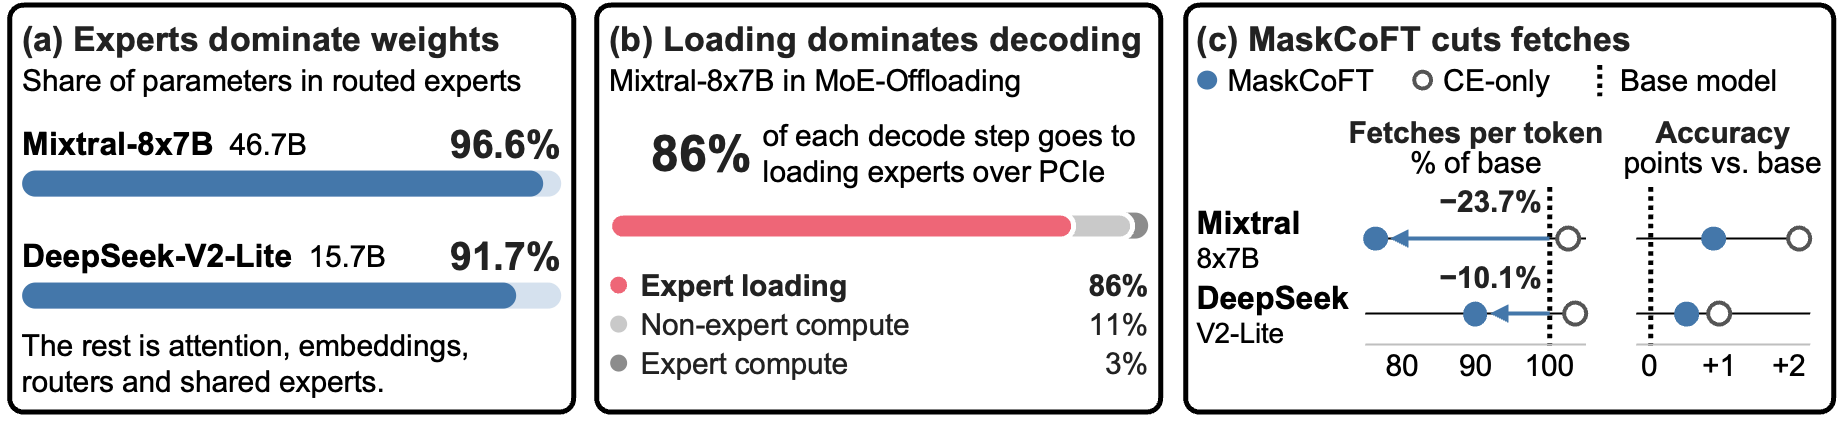
Модель со смесью экспертов, MoE, активирует для каждого токена только несколько специализированных блоков. Вычислений становится меньше, но хранить всё равно нужно веса всех экспертов: в Mixtral-8×7B на них приходится почти вся модель.
Если веса не помещаются в память GPU, система оставляет там небольшой кэш, а остальных экспертов держит в оперативной памяти. Когда роутер выбирает отсутствующего в кэше эксперта, его веса приходится передавать по PCIe. В измерении MoE-Offloading такие передачи занимали 86% времени декодирования Mixtral-8×7B, поэтому ускорять только вычисления в этом режиме почти бесполезно.
Кэширование и предварительная загрузка помогают, пока следующие токены обращаются к уже известному набору экспертов. Но обычный роутер выбирает их исходя из содержания каждого токена и не учитывает ограниченную память GPU. Даже точный прогноз не скроет задержку, если передача весов длится дольше доступных вычислений.
Как маска заставляет экспертов адаптироваться вместе с роутером
MaskCoFT дообучает модель в два этапа. Сначала в каждом MoE-слое обучаемая двоичная маска оставляет 75% экспертов, а выбор лучших экспертов работает только внутри этого набора. Одна маска действует на все токены пакета, поэтому модель ищет не локальные совпадения между соседними токенами, а набор, который можно повторно использовать для разных входов.
Маску нельзя обучать обычным обратным распространением ошибки, потому что выбор экспертов дискретен. Авторы применяют приближённую передачу градиента через операцию выбора: на прямом проходе маска остаётся двоичной, а на обратном её считают непрерывной. Градиенты накапливают по нескольким случайно выбранным наборам, чтобы маска не закрепилась на одном раннем варианте.
На втором этапе набор фиксируют. Роутеры продолжают обучаться полностью, а эксперты получают адаптеры LoRA и осваивают токены, которые раньше направлялись в другие блоки. Это отличает MaskCoFT от подходов, которые меняют только роутер: замороженный эксперт может не справиться с новой нагрузкой, даже если такая маршрутизация удобнее для кэша.
Для обучения хватает обычной перекрёстной энтропии. Дополнительный штраф за равномерную загрузку экспертов не используют, потому что он противоречил бы цели: системе нужно сосредоточить обращения на меньшем наборе, а не распределить их поровну.
Во время инференса жёсткую маску снимают. Вместо неё модель применяет обученный приоритет, который поднимает часто используемый набор в рейтинге роутера. Любой эксперт остаётся доступен, если исходный роутер считает его достаточно подходящим, поэтому метод не превращает обучение в необратимое удаление весов.
Когда MaskCoFT меняет план развёртывания
Метод проверили на Mixtral-8×7B и DeepSeek-V2-Lite — моделях с разным количеством и размером экспертов. Для каждого слоя симулировали кэш на четыре эксперта у Mixtral и на двенадцать у DeepSeek, применяли три политики вытеснения, а затем запускали модели в реальной системе MoE-Offloading. Качество оценивали на девяти задачах по языку, рассуждениям, математике и коду.
При политике, которая сохраняет самых часто используемых экспертов, число загрузок на токен сократилось на 23,7% у Mixtral и на 10,1% у DeepSeek. В реальном запуске время генерации одного выходного токена уменьшилось максимум на 16,4% и 5,5% соответственно. Средняя точность обеих моделей осталась выше исходной.
Среднее скрывает перестановку качества между задачами. У DeepSeek результат на MMLU снизился на 2,17 процентного пункта, тогда как HumanEval вырос на 1,22 пункта. Команде всё равно придётся проверять собственные сценарии: сохранение среднего балла не гарантирует, что не пострадает нужный тип запросов.
MaskCoFT меняет планы, если MoE-модель уже приходится обслуживать с выгрузкой экспертов и передачи по PCIe ограничивают скорость. В таком случае к настройке кэша и предварительной загрузке можно добавить дообучение маршрутизации. Цена этого решения — отдельный вариант модели: нужно обучать все роутеры и адаптеры экспертов, хранить новый контрольный снимок и заново прогонять оценку качества.
Если все веса помещаются в GPU или задержку определяет не перенос экспертов, работа не показывает сопоставимой выгоды. Сравнение с ReMoE также нельзя считать прямым: настройки части тестов и исходные результаты различаются, поэтому авторы сопоставляют прежде всего изменения относительно собственной базовой модели.
Источники
Иллюстрация: рисунок из статьи «MaskCoFT: Masked Co-Adaptive Fine-Tuning for Memory-Efficient MoE Inference», Junfeng Wu, Zehao Fan, Hadjer Benmeziane и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


