
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну и ту же LLM научили лучше решать открытые исследовательские задачи, не подключая более сильную модель внутри цикла обучения. В работе UC Berkeley и Sakana AI после двух циклов Qwen3.6-27B выдавала в 1,2–1,6 раза больше результата на токен; препринт не проходил рецензирование, а все числа получили сами авторы. Подход превращает многоагентную схему из постоянной обвязки продукта в источник данных для дообучения самой модели.
Как модель перестраивает собственную команду
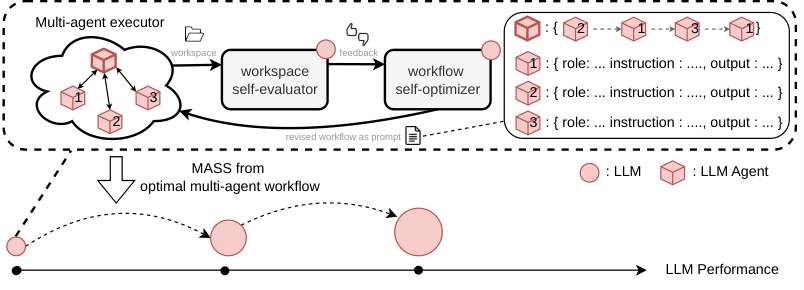
MASS чередует поиск рабочего графа и дообучение с учителем. Исполнитель, оценщик и оптимизатор используют одну Qwen3.6-27B, поэтому улучшение не зависит от скрытого учителя с более сильной моделью.
Рабочий граф задают текстом и добавляют к запросу. В нём перечислены роли подагентов, порядок их вызова, инструкции и контракт результата: какие сведения каждый подагент должен вернуть координатору. Все участники используют общие веса модели, но получают разные локальные задачи и контекст.
Во внутреннем цикле модель выполняет задачу по текущему графу. Затем её копия сравнивает полученные файлы с лучшим сохранённым вариантом и объясняет выбор. Ещё одна копия меняет граф с учётом этой оценки, причём запрос оптимизатора направляет поиск прежде всего на передачу информации: кто, кому, когда и в каком виде отдаёт результат.
Такой поиск меняет не только формулировки ролей. Он может переставить вызовы, потребовать от аналитика сохранить код для следующего подагента или добавить проверку перед сборкой итогового отчёта. Сохраняется только лучший на текущий момент граф, поэтому процесс напоминает эволюционный отбор с одним победителем.
Во внешнем цикле лучший граф запускают несколько раз, а оценщик проводит попарный турнир между результатами. Отобранные траектории координатора и подагентов становятся данными для дообучения. Сам граф из обучающего запроса убирают: модель должна усвоить делегирование, передачу файлов, проверку и сборку ответа, а не воспроизводить одну служебную инструкцию.
Что дала смена графов и дообучение
На отложенных синтетических задачах доля побед над базовой моделью выросла с 53,9% до 69,9%. Итоговые ответы оценивали GPT-5.5 и Claude Opus 4.8, которые не участвовали в поиске графов и подготовке обучающих траекторий.
Отдельное сравнение показывает, что результат связан не только с объёмом данных. Многоагентный ученик выигрывал у базовой модели в 68,3% сравнений, одноагентный — в 64,0%, хотя для второго обработали примерно в 1,4 раза больше обучающих токенов. Разделение длинной работы на локальные действия и координацию оказалось полезнее дополнительного объёма одноагентных рассуждений.
После дообучения модель начала сама вызывать подагентов и передавать им код даже с обычным заданием, без найденного ранее графа в запросе. Значит, часть поведения перешла в веса модели, а не осталась свойством внешней обвязки.
Проверка охватила одну базовую модель в фиксированном агенте qwen-code. Для обучения использовали синтетические исследовательские задачи из финансов, робототехники и фармацевтики, а для проверки — MLR-Bench, ScienceAgentBench, DSBench, AstaBench, Terminal-Bench 2.0, SWE-bench Verified и отдельные синтетические задания. Это задачи с кодом, файлами и отчётами, где можно сравнить готовые рабочие пространства; перенос результата на диалоги или бизнес-процессы без проверяемого результата работа не устанавливает.
Когда MASS меняет план разработки
Работа не даёт основания закладывать автономное рекурсивное самоулучшение в производственный продукт. Она показывает более узкий инженерный приём: сначала найти удачный способ координации копий одной модели, затем обучить модель на следах этой координации и повторить цикл.
Для команды, которая уже строит многоагентную систему, меняется объект оптимизации. Вместо ручного подбора ролей стоит хранить рабочий граф как версионируемую спецификацию: порядок вызовов, доступный контекст и контракт результата. Именно изменения маршрутов информации, а не добавление новых персонажей в запрос, дали модели полезные обучающие примеры.
Второе следствие касается архитектуры оценки. Внутри цикла модель может выбирать лучшие собственные результаты, но выпуск новой версии нужно проверять отдельным оценщиком, который не видел историю поиска. Иначе одна и та же ошибка может закрепиться одновременно в исполнителе, оптимизаторе и оценке.
Самый практичный сценарий — задачи, где агент оставляет проверяемые файлы: код, расчёты, отчёты или результаты экспериментов. Здесь можно сохранять полные траектории, сравнивать итоговые рабочие пространства и дообучать модель одновременно на локальной работе подагентов и действиях координатора.
MASS также предлагает способ сократить зависимость от сложной обвязки во время применения модели. Если делегирование и передача результатов переходят в веса, часть правил не придётся каждый раз помещать в длинный запрос. Работа показывает сам эффект, но не сравнивает полную стоимость поиска графов, дообучения и последующих запусков, поэтому экономику такого перехода каждой команде придётся считать на своих задачах.
Источники
Иллюстрация: рисунок из статьи «Recursive Self-Improvement through Multi-Agent Self-Supervision», Hyunin Lee, Jinglue Xu, Jeffrey Seely и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


