Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Новый способ обучения повысил точность вызова внешних инструментов у LLM. В нерецензированном препринте, где все числа получили сами авторы, MATCH достиг общей точности 72,19% на API-Bank и 62,87% на BFCL V3. Для команд, которые дообучают модели вызывать функции через API, работа предлагает связать подбор примеров и расчёт награды в один цикл.
Награда следует порядку выполнения вызова
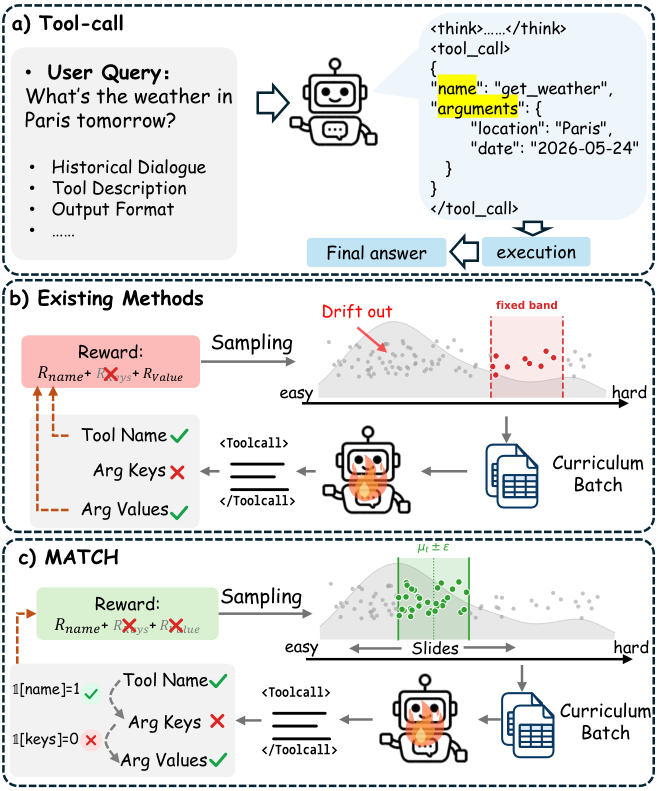
Обычная детальная награда складывает баллы за имя инструмента, ключи аргументов и их значения. Из-за этого модель может получить часть награды, если выбрала неверный инструмент, но случайно указала аргументы, похожие на эталонные. Для реального вызова такой ответ бесполезен: правильные параметры не исправляют неверно выбранную функцию.
MATCH вводит иерархию. Сначала модель получает балл за правильное имя инструмента. Ключи аргументов оцениваются только после этого, а значения — только при совпавшем наборе ключей. Отдельный небольшой сигнал проверяет формат ответа, но основная награда зависит от содержимого вызова.
Для последовательности из нескольких вызовов метод сопоставляет каждый эталонный вызов с ещё не использованным предсказанием того же инструмента. Лишний вызов не приносит баллов, но и не получает дополнительного штрафа. Если обязательного блока с вызовом нет, модель получает отрицательную награду.
Такой расчёт сохраняет более плотный учебный сигнал, чем проверка полного совпадения, но не поощряет бессмысленные аргументы. Награду можно вычислить после разбора JSON и сравнения с эталонной последовательностью, без отдельной модели-оценщика.
Сложность примеров движется вместе с моделью
Вторая часть MATCH меняет обучение по нарастающей сложности (curriculum learning). Фиксированный порог быстро устаревает: примеры, которые находились на границе возможностей модели в начале, через несколько эпох становятся слишком лёгкими. Метод поэтому заново оценивает сложность по мере обучения.
Перед обучением исходная модель несколько раз отвечает на каждый запрос. Доля полностью правильных вызовов задаёт начальную сложность примера. Затем MATCH обновляет оценку по наградам новых ответов и сглаживает её, чтобы отдельный удачный или неудачный вызов не менял расписание слишком резко.
На каждой эпохе метод выбирает примеры рядом со средней текущей сложностью и добавляет ограниченную долю самых трудных. Первая группа закрепляет задачи на границе возможностей, вторая постепенно сдвигает эту границу. Те же иерархические награды одновременно обучают модель через GRPO и определяют, какие примеры попадут в следующую эпоху.
В сравнении с сильнейшим основным конкурентом ToolSample общая точность выросла на 7,20 процентного пункта на API-Bank и на 2,62 пункта на BFCL V3. Когда из MATCH убирали адаптивный подбор примеров или иерархическую награду, результат снижался на обоих наборах. Полная иерархия особенно помогла на сложной части API-Bank L3.
Когда MATCH меняет план обучения продукта
Основной опыт использовал Qwen2.5-7B-Instruct и 4 000 учебных примеров, собранных из ToolACE, Hammer и xLAM; итог проверяли на API-Bank и BFCL V3. Многошаговые траектории при обучении разбивали на отдельные шаги, сохраняя предыдущий диалог, а ответы без вызова инструмента исключали из обновления модели. Дополнительная проверка охватила четыре базовые модели из двух семейств и в среднем также дала преимущество над ToolRL.
MATCH относится к этапу обучения, а не к архитектуре агента. Он не меняет целевую функцию GRPO и не требует нового формата инструментов, но предполагает, что для учебного запроса известна эталонная последовательность вызовов. Нужны также канонический разбор аргументов и правила их нормализации, иначе одинаковые по смыслу значения могут выглядеть разными.
Работа меняет планы команды, если та уже собирается дообучать модель с подкреплением на вызовах функций. Вместо случайной подачи всей выборки имеет смысл проверить ветку, где сложность регулярно пересчитывается по текущей политике, а награда блокирует баллы за аргументы после ошибки в имени инструмента. Обе части дали самостоятельный вклад, поэтому перенос только расписания или только награды оставляет часть результата.
Для систем с длинными агентными траекториями вывод уже: обучение проводили на отдельных шагах, хотя история диалога оставалась в запросе. Практический эксперимент стоит сначала ограничить функциями с проверяемыми JSON-аргументами и эталонными вызовами, а затем отдельно измерить, сохраняется ли преимущество на собственных многошаговых процессах.
Источники
Иллюстрация: рисунок из статьи «MATCH: Model-Aware Tool Learning with Curriculum Scheduling and Hierarchically Gated Rewards», Shihao Liu, Hao Yin, Lijun Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.