Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Точность ответа скрывает, на каком этапе LLM ломает математическое решение: модель часто умеет развить ключевую идею, но не находит её сама. Команда из Texas A&M University, Harvard University и других организаций в препринте, который не проходил рецензирование, сама получила на 12 моделях прирост точности на 17,58–29,67 процентного пункта, когда давала им верную идею. Для дообучения это предлагает отдельную цель: передавать структуру решения, а не только готовые рассуждения.
Примитив объясняет, почему задача решается
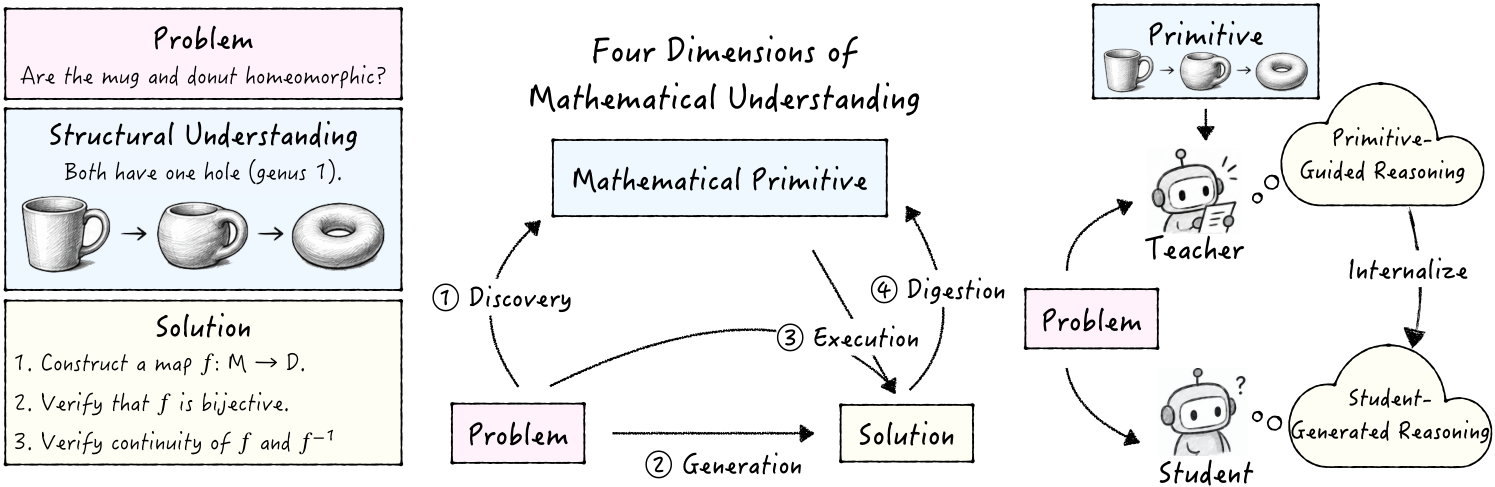
Авторы называют математическим примитивом короткое наблюдение, на котором держится решение. Это может быть инвариант, условие теоремы, подходящее представление, сведение к другой задаче или переформулировка.
Примитив отличается и от совета «применить индукцию», и от полного доказательства. Он должен назвать конкретное свойство задачи и объяснить, как оно открывает путь к решению. Например, недостаточно предложить заменить переменные: нужно указать, какое скрытое равенство или симметрию обнаружит такая замена.
Набор тестов Prim делит математическое рассуждение на четыре способности. Поиск проверяет, может ли модель выделить примитив только из условия. Решение измеряет обычную точность ответа без подсказки. Извлечение показывает, узнаёт ли модель ключевую идею в готовом верном решении. Исполнение проверяет, сможет ли она получить ответ, если примитив уже дан.
Prim собрали из текстовых математических задач HLE-Verified со свободной формой ответа. После отбора осталось 182 задачи; для каждой исходную формулировку примитива проверили три специалиста с математической подготовкой. В диагностике участвовали линейки OpenAI, Qwen и DeepSeek-R1, поэтому сравнение охватывает разные размеры и способы обучения моделей, но остаётся проверкой на сложной математике с однозначно оцениваемым итоговым ответом.
Верная структура открыла скрытую способность решать
Модели с близкой точностью ответов показали разные профили. Одни чаще заранее находили правильную структуру, но ошибались в вычислениях или пропускали условие теоремы. Другие приходили к идее только после длинного перебора шагов и могли дать верный ответ, не сформулировав, почему подход работает.
Предоставленный примитив улучшил исполнение у всех проверенных моделей. У Qwen3.6-27B точность выросла с 52,75% при обычном решении до 78,57% с примитивом. Значит, часть ошибок этой модели связана не с отсутствием вычислительных навыков, а с выбором подхода.
Поиск оказался главным узким местом: 83,6% неудачных решений пришлись на случаи, где модель не смогла самостоятельно определить примитив. При этом модели заметно лучше извлекали ту же идею из готового доказательства. Они чаще узнают полезную структуру задним числом, чем находят её до начала решения.
Обычный пошаговый план помогал слабее, чем примитив. Не сработало и механическое разделение на два запроса — сначала сформулировать идею, затем решить задачу: ошибочный собственный примитив мог ухудшить ответ. Ценность даёт не дополнительный этап сам по себе, а точная структурная подсказка.
Absorb меняет план дообучения, но не отменяет проверку на своей области
Метод Absorb переносит примитив в модель через самодистилляцию. Во время обучения ученик продолжает генерировать полное решение, а версия той же модели в роли учителя видит ещё и эталонный примитив. Учитель подсказывает, какие продолжения лучше согласуются с ключевой идеей; во время обычной работы примитив модели уже не нужен.
Авторы ограничивают силу такой подсказки. Учитель не может безусловно подавить варианты, которым ученик уже назначил заметную вероятность. Это снижает риск испортить задачи, которые базовая модель и так решала, и отличает Absorb от прямого обучения на готовых доказательствах или на текстах самих примитивов.
На нескольких размерах моделей и математических наборах Absorb прибавил в среднем 2,42–4,48 процентного пункта относительно базовых способов дообучения. В разборе вариантов полный эталонный ответ как привилегированная подсказка ухудшал модель, тогда как короткий примитив улучшал её. Значит, больше сведений для учителя не обязательно создаёт более полезный учебный сигнал.
Для команды практический первый шаг — разделить собственную проверку на поиск идеи и исполнение. Если модель заметно лучше решает задачу после короткой структурной подсказки, имеет смысл собирать такие примитивы и испытывать дистилляцию наподобие Absorb. Если подсказка не помогает, узким местом, вероятнее, остаются знания или техника исполнения, и этот метод его не закрывает.
Работа не даёт основания переносить результат на любые рассуждающие системы: диагностика построена на математике, а обучение требует эталонных примитивов. Она меняет план эксперимента для математических продуктов — сначала определить тип ошибки, затем выбирать данные и способ дообучения, — но не заменяет проверку на задачах конкретного продукта.
Источники
Иллюстрация: рисунок из статьи «The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models», Shuo Xing, Zilin Dai, Chengyuan Qian и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.