
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Поиск Монте-Карло по дереву (MCTS) научили отличать новую стратегию рассуждения от новой формулировки уже проверенной стратегии. Работа Fudan University, Meituan и партнёров, которая не прошла рецензирование и содержит замеры самих авторов, показывает прирост средней точности до 4,96 процентного пункта против стандартного MCTS. Для систем с поиском поверх LLM это точечное изменение механизма исследования, а не замена модели или всей схемы обучения.
Почему счётчик посещений повторно оплачивает одну стратегию
MCTS строит дерево возможных действий: выбирает перспективную ветку, расширяет её, оценивает результат и переносит оценку вверх по дереву. Правило UCT совмещает накопленную ценность ветки с бонусом за исследование: чем реже ветку посещали, тем выше шанс снова её проверить.
В языковой модели ветку обычно определяет последовательность токенов. Поэтому два текста, которые выражают один способ решения, получают независимые счётчики. Переформулированная стратегия выглядит новой и забирает вычислительный бюджет у действительно другого подхода.
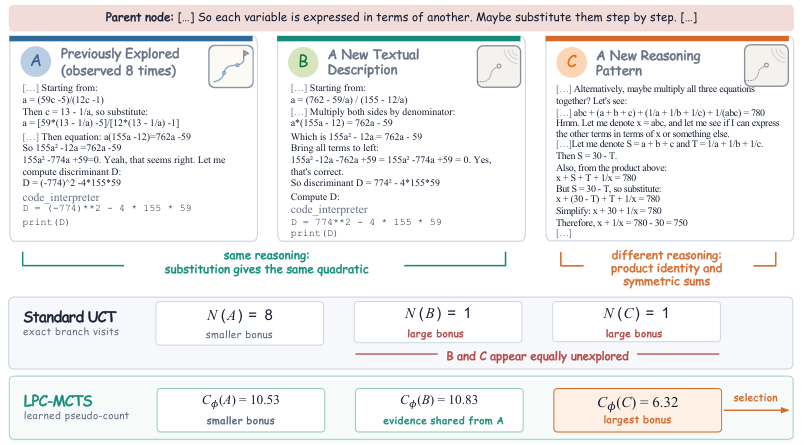
В примере из работы одна ветка уже прошла восемь посещений и решала задачу подстановкой. Вторая повторяла тот же вывод другими словами, а третья применяла тождество и симметрические суммы. Стандартный UCT считал вторую и третью ветки одинаково неисследованными, хотя новой стратегией была только третья.
Теоретическая модель объясняет цену такой фрагментации. Если несколько действий эквивалентны, независимые счётчики заставляют алгоритм отдельно исследовать каждое из них. Общий счётчик для группы платит эту цену один раз, поэтому при нескольких равнозначных формулировках накопленная потеря растёт пропорционально их количеству.
Как псевдосчётчик узнаёт знакомое рассуждение
LPC-MCTS заменяет точное число посещений обучаемым псевдосчётчиком. Его вычисляет линейная вспомогательная головка Coin-Flipping Network (CFN), которая получает скрытые представления токенов из самой языковой модели. Основная модель при обучении головки не меняется.
Для каждого встреченного представления CFN получает новую случайную двоичную цель. Если похожие состояния появляются регулярно, предсказания усредняются, а их норма уменьшается. Так головка оценивает не точное совпадение текста, а накопленную знакомость представленного им состояния.
Метод выбирает участки ответа с высокой неопределённостью, отбрасывает одиночные всплески и объединяет оставшийся сигнал в оценку узла. Низкий псевдосчётчик означает, что соответствующий ход ещё плохо покрыт поиском, поэтому UCT повышает его бонус. Похожие формулировки получают близкие оценки, а новый способ решения сохраняет преимущество.
Оценки качества веток при этом остаются раздельными: LPC-MCTS объединяет только свидетельства об исследованности. Во время обучения тот же сигнал помогает выбирать траектории с менее знакомыми решениями. Во время вывода можно оставить политику фиксированной и заменить лишь правило, по которому поиск распределяет симуляции.
Математическую часть проверяли на Qwen2.5-7B и Qwen3-4B в пяти наборах задач, поисковую — на Qwen2.5-7B-Instruct и Llama-3.2-3B-Instruct в семи наборах. Главная метрика mean@16 показывает среднюю точность по 16 ответам на задачу. Эксперименты охватывают рассуждения с инструментами и поиск информации, поэтому выводы относятся прежде всего к агентам с явным деревом действий.
Когда LPC-MCTS меняет технический план
На Qwen3-4B применение LPC-MCTS и при обучении, и при выводе прибавило 4,37 процентного пункта к стандартному MCTS. При фиксированной обученной политике одна замена счётчика во время вывода дала 3,79 пункта на Qwen2.5-7B и 2,71 пункта на Qwen3-4B. Это отделяет эффект распределения поискового бюджета от эффекта дополнительного обучения политики.
В задачах поиска полный вариант прибавил 2,26 пункта на Qwen2.5-7B-Instruct и 1,71 пункта на Llama-3.2-3B-Instruct. Математические деревья содержали больше конкурирующих способов решения, поэтому совместный учёт похожих веток помогал сильнее. В поисковых задачах траектории чаще следовали одной стандартной схеме, и перераспределять бюджет было сложнее.
Команде с уже работающим MCTS имеет смысл проверять LPC-MCTS до увеличения числа симуляций. Изменение локализовано: потребуется собирать скрытые представления во время развёртываний, обучать дополнительную головку и заменить статистику в правиле UCT. Отдельная модель представлений и кластеризация веток не нужны.
Для продукта без древовидного поиска работа не служит аргументом срочно добавлять MCTS. Она показывает более узкий результат: если система уже тратит вычисления на разветвлённые рассуждения, точный счёт текстовых посещений может быть неверной единицей учёта. Чем чаще модель порождает несколько формулировок одной идеи, тем вероятнее, что псевдосчётчик улучшит использование существующего бюджета.
Источники
Иллюстрация: рисунок из статьи «MCTS Is Counting the Wrong Thing: Learning Exploration Counts for LLM Reasoning», Xuan Zhang, Zhijian Zhou, Zicheng Hu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


