
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Систему научили надёжнее считать клинические показатели прямо по свободным заметкам о пациенте. В работе Dalian University of Technology она дала 86,73% правильных итоговых ответов, хотя препринт не рецензирован и числа получили сами авторы. Вместо попытки решить задачу одним запросом LLM здесь разделяет понимание текста и выполнение формул.
Калькулятор сначала превращают в проверяемый код
Обычный прямой запрос смешивает несколько разных задач. Модель должна вспомнить нужную формулу, найти параметры в заметке, привести единицы, выполнить арифметику и оформить результат. Ошибка на любом шаге портит ответ, а по итоговой строке трудно понять причину.
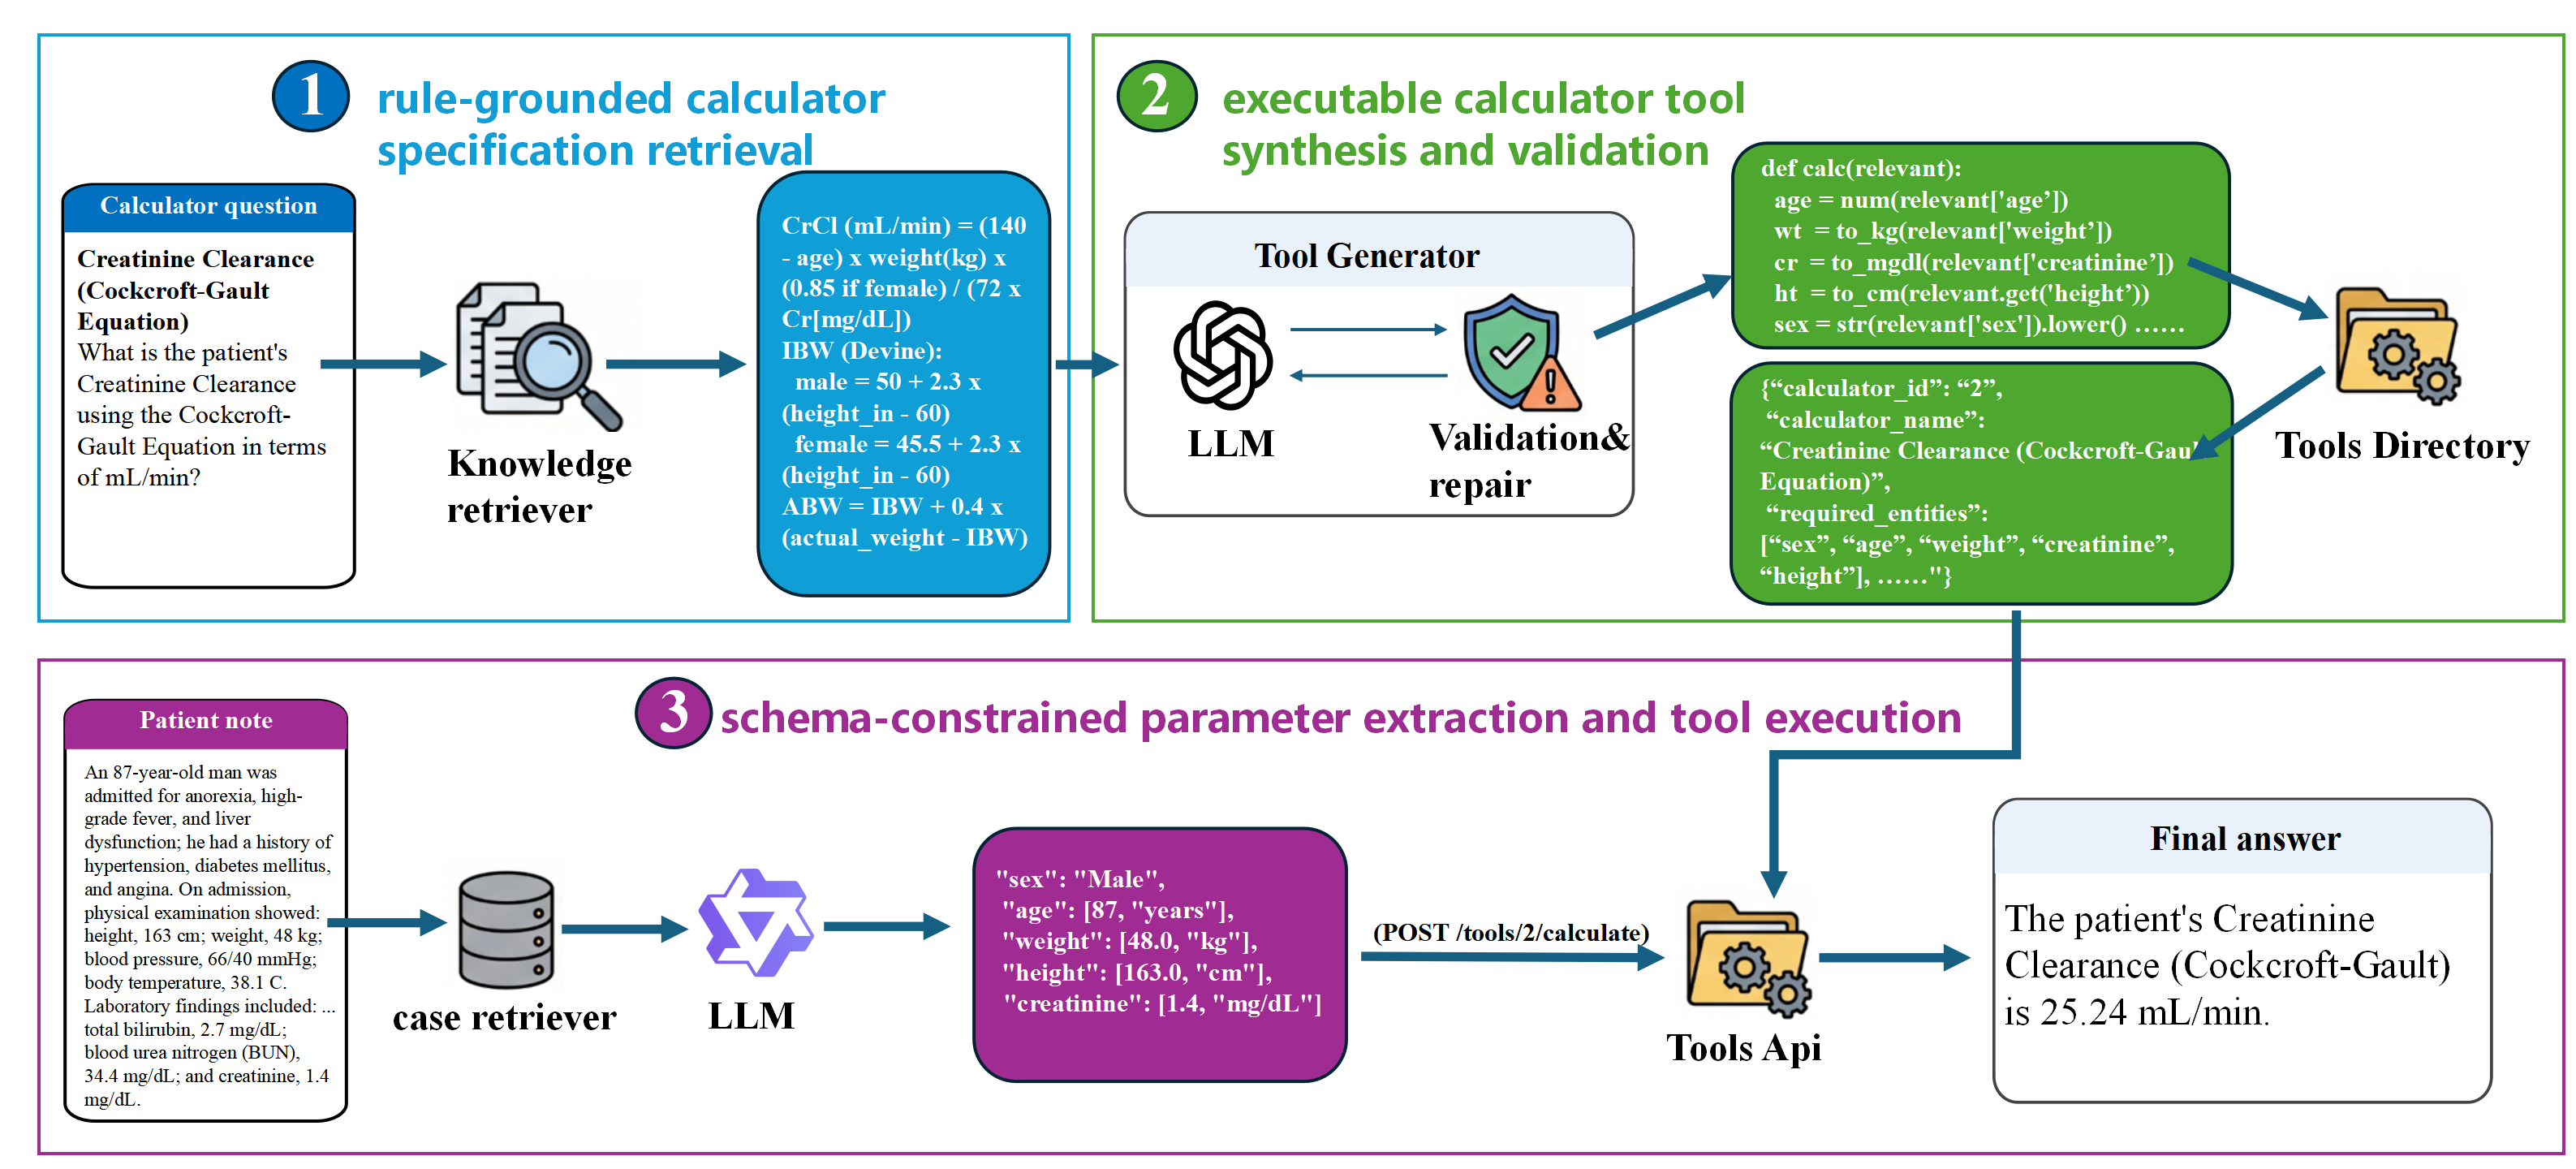
Новая схема сначала находит описание нужного медицинского калькулятора. Из него система собирает структурированную спецификацию: обязательные параметры, допустимые единицы, формулу, условия выбора ветви, граничные случаи и требования к форме ответа. Спецификацию сохраняют вместе с источником, чтобы повторно использовать для следующих пациентов.
Затем отдельная LLM пишет функцию на Python. Она принимает подготовленные параметры, проверяет их типы, переводит единицы, выбирает нужную ветвь формулы и возвращает результат в заданном формате. Функцию прогоняют на исторических примерах; ошибки выполнения и расхождения с эталоном возвращают модели для исправления.
При обработке новой заметки формула уже не генерируется заново. Дообученная Qwen3-8B извлекает значения по схеме конкретного калькулятора и выдаёт объект JSON с числами, категориями, датами и логическими признаками. Сохранённая функция получает этот объект и выполняет расчёт обычным кодом.
Так система оставляет LLM ту часть, где нужен разбор естественного языка, но не поручает ей арифметику. Одновременно появляется проверяемая цепочка: исходное правило, схема параметров, сгенерированный код, извлечённые значения и результат выполнения.
Разрыв с прямым запросом составил 24 процентных пункта
Система обошла прямой запрос с одним примером на 24 процентных пункта, а вариант только с обучением на размеченных ответах — на 17,27 процентного пункта. Выигрыш дали прежде всего код, построенный по найденным правилам, и извлечение параметров в заранее заданную схему.
Ошибки при этом не исчезли, а разделились на две понятные группы. В первой модель неверно читает клинический смысл: например, не выводит гиперхолестеринемию из назначения аторвастатина. Во второй правильно извлечённые данные попадают в ошибочную функцию.
Один такой дефект возник из-за порядка проверки названий препаратов. Функция искала подстроку cortisone раньше hydrocortisone, поэтому отнесла Hydrocortisone к другому препарату и применила неверный коэффициент. Код выполнился без сбоя, но детерминированность лишь стабильно воспроизвела заложенную ошибку.
Проверка охватывает 1 100 новых заметок для тех же 55 калькуляторов, по которым строили инструменты. Поэтому результат показывает качество повторного применения уже подготовленной библиотеки, но не подтверждает перенос на ранее неизвестные калькуляторы или работу в клинической системе.
Командам стоит разделить смысл и вычисление
Работа меняет архитектурный выбор для продуктов, где LLM должна применять формальные правила к неструктурированному тексту. Формулу, таблицу коэффициентов или ветвление не стоит каждый раз помещать в запрос и надеяться, что модель точно воспроизведёт их в рассуждении.
Практический шаблон выглядит так: команда фиксирует спецификацию правила, описывает схему входных данных, собирает исполняемый модуль, проверяет его на примерах и только затем подключает извлечение из текста. Подготовленный модуль версионируют и переиспользуют, а не генерируют для каждого обращения.
Автоматическая сборка кода не отменяет обычную инженерную проверку. Пример с Hydrocortisone показывает, что тесты должны покрывать не только известные ответы, но и похожие названия, границы диапазонов, единицы, округление и разные ветви условий. Для медицинского продукта сгенерированный инструмент также требует проверки специалистом до использования в работе с пациентами.
Сам результат не доказывает, что LLM стала надёжным клиническим калькулятором общего назначения. Он подтверждает более узкую инженерную идею: если правило можно выразить кодом, модель лучше использовать как переводчик из человеческого текста в строгие параметры, а вычисление оставить проверяемой программе.
Источники
Иллюстрация: рисунок из статьи «Tool-Augmented Large Language Models for Reliable Medical Calculation from Patient Notes», Yang Zhong, Ling Luo, Xuanlyu Zhu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


