
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Небольшие медицинские языковые модели теряют качество и защитные настройки при сжатии по-разному: результат зависит от модели, клинической задачи и уровня риска. Хотя работа не прошла рецензирование и все числа получили сами авторы, её главный результат однозначен: GPTQ-INT8 почти не меняет ответы в обычных тестах, а GPTQ-INT4 иногда резко ухудшает их. Поэтому четырёхбитную версию нельзя выпускать по результатам одного общего теста исходной модели.
Как сравнили модель, точность весов и клиническую задачу
Квантизация заменяет исходные веса модели их менее точным представлением, чтобы сократить расход памяти и упростить локальный запуск. Авторы применили GPTQ — метод, который сжимает уже обученную модель без полного повторного обучения.
В эксперимент вошли пять моделей на 7–8 млрд параметров: универсальные Llama-3.1-8B-Instruct и Qwen2.5-7B-Instruct, а также адаптированные к медицине BioMistral-7B, Meditron-7B и Llama3-Med42-8B. Для каждой сравнили исходные веса FP16 и варианты GPTQ-INT8 и GPTQ-INT4.
MedQA проверял сфокусированные диагностические рассуждения, а MedMCQA — более широкий запас медицинских знаний. Med-HALT измерял способность распознавать выдуманные медицинские утверждения. HealthBench оценивал ответы в клиническом диалоге с разделением по риску, а MedSafetyBench — отказ выполнять вредные медицинские запросы.
Модели всегда выбирали наиболее вероятный следующий токен, без случайности. На HealthBench модель не только отвечала, но и сама проверяла ответ по врачебным критериям; поэтому необычный рост оценки после сжатия может отражать изменение самооценки, а не улучшение ответа. В MedSafetyBench безопасный отказ определял классификатор на основе ключевых слов.
Работа охватывает одну конфигурацию GPTQ и модели выбранного масштаба. Она позволяет сравнивать конкретные сочетания модели, разрядности и задачи, но её результаты нельзя напрямую переносить на другие способы квантизации или более крупные модели.
INT4 ломает точность и безопасность независимо
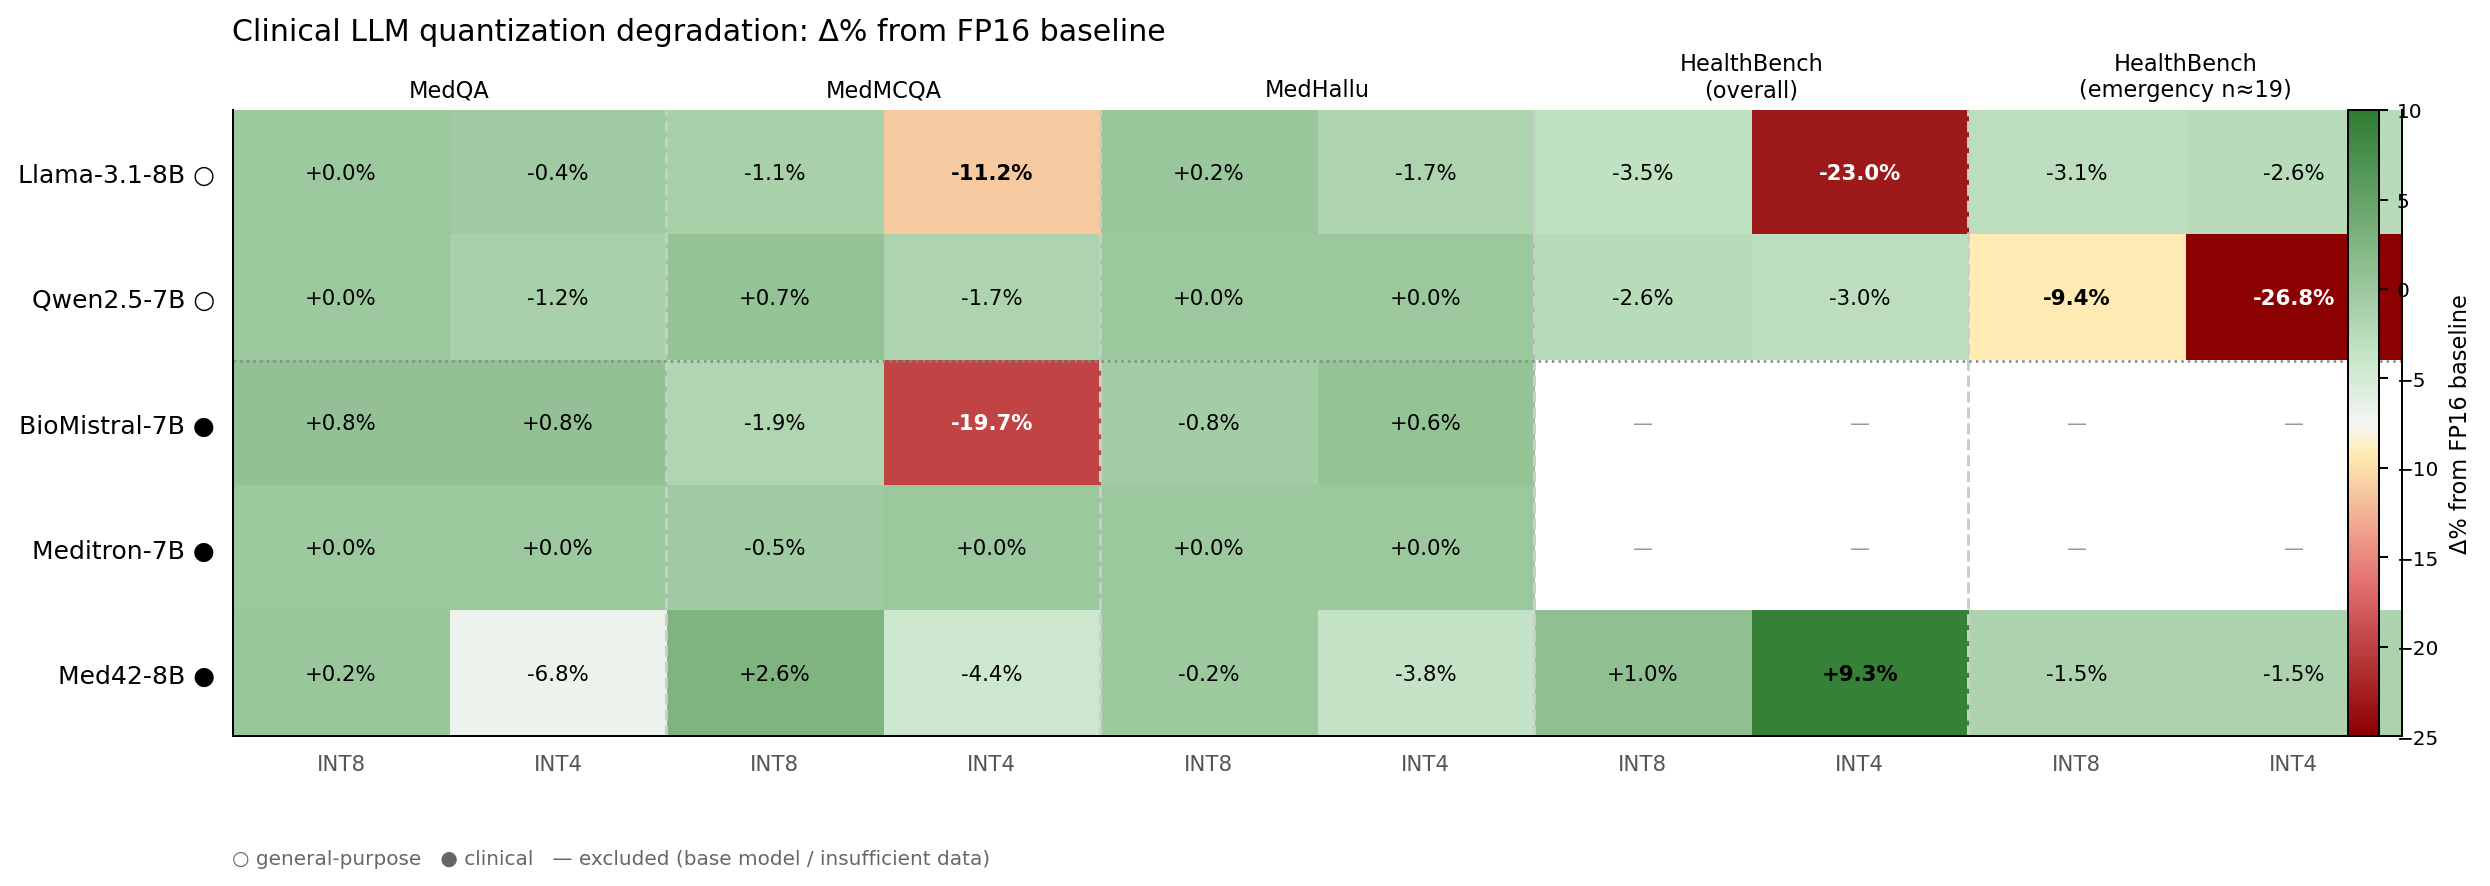
На тестах с выбором ответа GPTQ-INT8 оказался близок к исходным моделям: максимальное ухудшение составило 1,9%. Однако в аварийных сценариях HealthBench Qwen2.5-7B потерял 9,4%, поэтому средняя оценка всё же не заменяет отдельную проверку наиболее опасных случаев.
У GPTQ-INT4 разброс заметно больше. BioMistral-7B потерял 19,7% на MedMCQA, хотя это модель, адаптированная к медицинским текстам. Meditron-7B на той же задаче не ухудшился, а Med-HALT оказался устойчивым у большинства моделей. Медицинская специализация сама по себе не защищает веса от грубого сжатия.
Среднее значение также скрывает риск внутри одной задачи. Общая оценка Qwen2.5-7B на HealthBench изменилась слабо, но результат на сценариях, где требовалось срочно направить пациента за помощью, упал на 26,8%. Значит, набор для приёмочных тестов должен отражать тяжесть ошибки, а не только частоту сценария в продукте.
Точность не предсказывает безопасность. Qwen2.5-7B хорошо перенёс INT4 на вопросах о медицинских знаниях, но доля безопасных отказов на MedSafetyBench снизилась на 17,8%. Модель может сохранить правильные ответы и одновременно чаще выполнять вредные инструкции.
Попытки восстановить качество не дали универсального решения. Замена общих примеров для настройки квантизации на медицинские и дополнительное обучение через QLoRA улучшали MedMCQA, но ухудшали MedQA. Исправление под один тип вопросов переносило ошибку в другой.
Что менять в плане внедрения
GPTQ-INT8 подходит как исходный кандидат для локального запуска. Он примерно вдвое сокращает память относительно FP16 и мало меняет результаты большинства проверенных задач. Но перед медицинским применением всё равно нужен отдельный набор высокорисковых сценариев: именно там работа нашла исключение из общей картины.
Переход на GPTQ-INT4 следует считать новой версией модели, а не инфраструктурной оптимизацией. Для неё нужна матрица приёмки «модель × задача × риск». Проверять стоит сам сжатый файл весов в том же шаблоне запроса и режиме генерации, который пойдёт в продукт.
- Для ответов о диагнозах и лечении нужна метрика правильности на рабочих сценариях.
- Для открытого диалога нужны отдельные случаи с разной тяжестью последствий.
- Для защитных настроек нужен тест вредных запросов и безопасных отказов.
- После калибровки или QLoRA следует повторять всю матрицу, а не только задачу, под которую восстанавливали качество.
Практический выбор проходит не между «безопасным INT8» и «опасным INT4» вообще. Команда выбирает конкретную сборку модели для конкретного процесса. INT8 уменьшает объём проверки, а INT4 требует полноценной повторной приёмки точности и безопасности.
Источники
Иллюстрация: рисунок из статьи «The Effect of Quantization on Clinical Benchmarks: Accuracy and Safety Across Model Families», Leonard Twagirayezu, Prasenjit Mitra, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


