
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Медицинские LLM отвечают на разные вопросы, поэтому система может выиграть, если выбирает специалиста для каждого запроса, а не закрепляет одну модель за целым набором задач. В нерецензированном препринте, где числа получили сами авторы, MedRouter превзошёл сильнейший сравниваемый роутер на 8% по средней доле правильных ответов. Для продукта это аргумент в пользу отдельного обучаемого роутера, если в пуле уже есть модели с разными знаниями.
Различия между специалистами видны на уровне отдельных вопросов
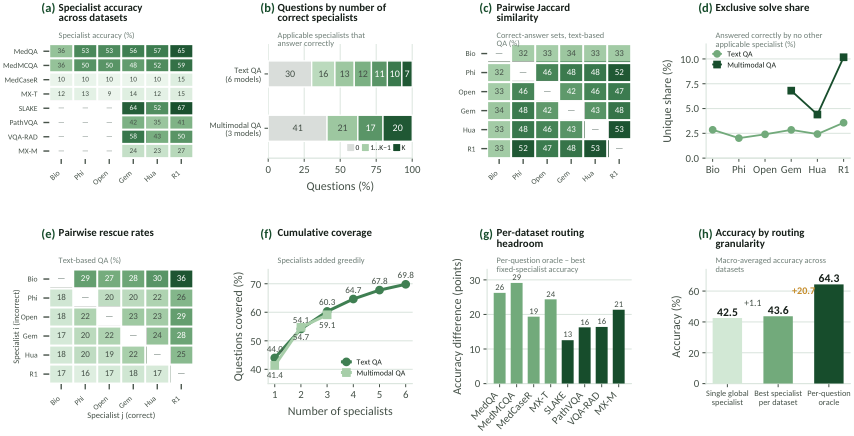
Лучшая модель в среднем не закрывает весь набор вопросов, на которые способны ответить остальные. Даже MediX-R1, который лидировал на всех текстовых наборах, пропускал задания, решённые другими медицинскими LLM.
Выбор лучшего специалиста отдельно для каждого набора дал 43,6% правильных ответов. Идеальный выбор модели для каждого вопроса поднял бы результат до 64,3%. Такой разрыв показывает, что название набора или медицинской специальности слишком грубо описывает нужные знания: внутри одной категории модели ошибаются на разных примерах.
MedRouter использовал эти различия и получил средний результат 45,9% с Qwen3.5-2B в роли модели, собирающей итоговый ответ, и 46,1% с Gemma-4-E2B. На 332 вопроса система ответила правильно, хотя ни один вызванный специалист не дал правильного готового ответа. Генератор смог собрать решение из частично полезных рассуждений, поэтому роутеру недостаточно угадывать, какая модель назовёт верный вариант.
Роутер учится отличать правильный ответ от полезной подсказки
Архитектура разделяет выбор источников и подготовку результата. Кодировщик превращает вопрос в числовое представление, небольшой многометочный классификатор оценивает каждого специалиста, а затем вызывает все модели выше заданного порога. Если порог не прошла ни одна модель, система выбирает модель с наибольшей оценкой.
Ответы выбранных специалистов вместе с исходным вопросом поступают генератору. Он не голосует за самый частый вариант и не копирует вывод одной модели, а формирует собственный ответ из полученной информации.
Обучение проходит в два этапа. Сначала роутер видит, какие специалисты самостоятельно решили каждый учебный вопрос. Для одного примера правильными целями могут стать сразу несколько моделей, поэтому система не сводит маршрутизацию к выбору единственного победителя.
Затем роутер доучивают с подкреплением. Генератор дважды отвечает на один вопрос: с материалами выбранных специалистов и без них. Награда растёт, если дополнительные ответы исправили ошибку, и снижается, если они испортили правильный результат. Когда генератор справляется сам, роутер получает более слабый сигнал, чем в случае, где специалист действительно изменил исход.
Такой критерий учитывает промежуточную ценность ответа. Специалист может ошибиться в диагнозе, но указать релевантный симптом или исключить неподходящий вариант. Обучение только по правильности самого специалиста отбросило бы эту информацию.
Планы меняются, если пул моделей уже собран
Подход не требует совместно доучивать все компоненты. Кодировщик, медицинские специалисты и генератор оставались замороженными; менялась только небольшая головка роутера. Это упрощает замену моделей в рабочей системе и снижает риск, что обучение маршрутизации изменит стиль или знания генератора.
Практическая схема состоит из журнала вопросов с эталонными ответами, заранее полученных ответов специалистов и повторного прогона через итоговый генератор. Первый этап даёт роутеру устойчивую начальную стратегию, а второй проверяет, приносит ли каждый маршрут пользу именно тому генератору, который работает в продукте. Запуск обучения с подкреплением без такой подготовки чаще сводил вызовы к узкой группе специалистов.
Проверка охватила шесть медицинских LLM на текстовых и мультимодальных наборах вопросов и два небольших генератора. Для заданий с изображениями использовалась только часть пула, способная обрабатывать визуальные данные. На некоторых таких наборах MedRouter не стал лучшим: специалисты могли опустить важную деталь изображения или передать противоречивые сведения, а замороженный генератор не учился лучше анализировать изображение.
Работа измеряет точность ответов на медицинские тесты, включая отдельную проверку на наборах вне обучающего распределения. Она не проверяет клинические исходы. Поэтому архитектурный вывод переносится в продукт — разделять маршрутизацию и генерацию и обучать выбор по добавленной пользе, — а полученную точность нельзя использовать как оценку готовности системы к работе с пациентами.
Источники
Иллюстрация: рисунок из статьи «MedRouter: Demystifying Knowledge Differences Across Medical LLMs for Routing-Based Reasoning», Lang Cao, Binghang Lu, Yuhao Shen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


