
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Память LLM-агента научили отбирать прошлый опыт по его пользе для новой задачи, а не по одному сходству запросов. В работе UIUC и Amazon, которая не прошла рецензирование и все числа для которой получили сами авторы, MemComposer обошёл лучшие базовые методы на τ2-bench. Для продуктовых команд это переносит точку оптимизации с поиска воспоминаний на сборку контекста после поиска: какие примеры дать агенту, сколько и в каком порядке.
Почему ближайшее воспоминание может мешать агенту
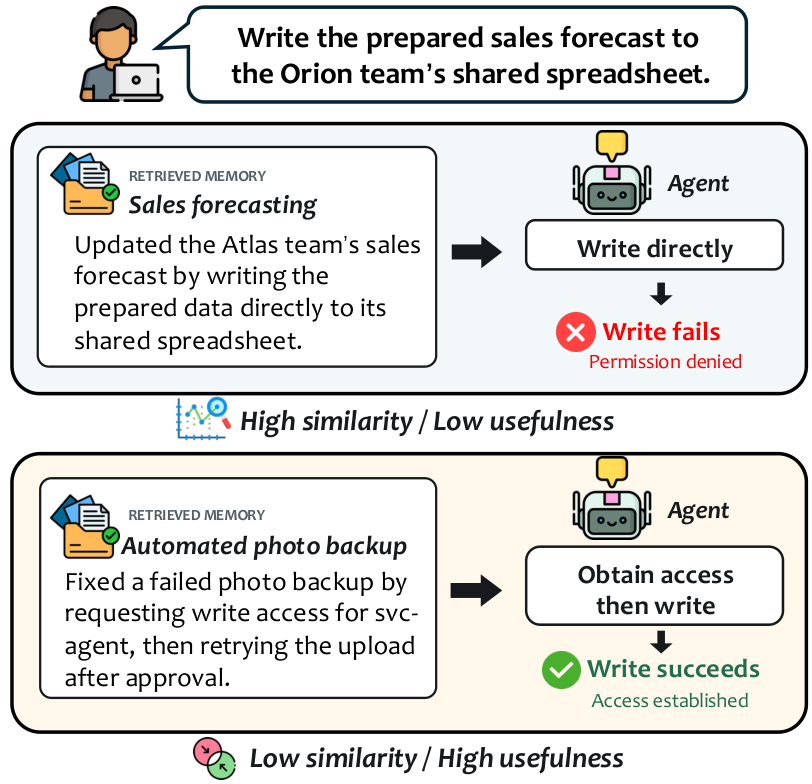
Память агента здесь состоит из прошлых диалогов, вызовов инструментов, итогов задачи и последующего разбора ошибок. Для нового запроса обычный поиск извлекает записи с похожими формулировками и передаёт несколько первых модели-исполнителю.
Сходство не отвечает на главный вопрос: поможет ли запись выполнить текущую задачу. Похожий диалог может повторять ту же тему, но не содержать нужного правила. Менее похожий пример может показывать подходящий вызов инструмента, ограничение политики или ошибку, которую нельзя повторять.
Число записей тоже нельзя задать один раз для всех запросов. Дополнительный опыт иногда помогает, а иногда размывает полезную инструкцию. Порядок влияет отдельно: один и тот же набор из пяти воспоминаний обеспечил успех во всех прогонах при порядке MemComposer и провал во всех прогонах при сортировке по сходству.
Из этого следует другая постановка задачи. Поиск формирует пул кандидатов, а отдельная модель рассматривает запрос и весь пул совместно. Она может пропустить часть записей, выбрать переменное количество и расположить их в нужной последовательности.
Как полный прогон задачи превращается в сигнал обучения
Сначала замороженная модель-исполнитель решает учебные задачи и сохраняет траектории взаимодействия. Та же модель разбирает результат, после чего прошедшие автоматическую проверку записи попадают в фиксированный банк памяти. Для каждого нового запроса обычный поиск по сходству подбирает кандидатов.
MemComposer читает запрос вместе с кандидатами и выдаёт упорядоченный список. Затем исполнитель проходит задачу целиком: общается с имитатором пользователя, вызывает инструменты и получает двоичный результат — успех или неудачу. Несколько повторных прогонов снижают влияние случайности.
Сборщик обучают через ExPO, вариант GRPO, который сравнивает предложенные контексты внутри одной группы. Награда учитывает долю успешных прогонов, штрафует лишние записи и неверный формат ответа. Обновляется только MemComposer; исполнитель, поиск и банк памяти остаются неизменными.
На среднем показателе успешности MemComposer обошёл сильнейший базовый метод на 5,9 процентного пункта с Qwen3-4B-Instruct и на 4,6 пункта с Ministral-3-8B-Instruct. При этом контекст памяти стал короче на 16,9% и 4,9% соответственно. В объединённом сравнении преимущество по средней успешности оказалось статистически значимым.
Метрика pass1 показывает среднюю долю успешных запусков. pass4 строже: задача засчитывается, только если агент решил её во всех повторных запусках. MemComposer лидировал по обеим метрикам, хотя преимущество по устойчивости над частью базовых методов осталось в пределах погрешности.
Когда сборщик памяти стоит добавить в архитектуру агента
Работа меняет планы команд, которые уже сохраняют траектории и выбирают их векторным поиском. Увеличивать число извлечённых записей или переходить на более сильную модель для создания памяти недостаточно: полезность возникает из сочетания записей и их порядка.
Практическая архитектура разделяется на два этапа. Поиск быстро сужает банк памяти, после чего обучаемый сборщик формирует контекст для исполнителя. Такой слой можно менять без дообучения основной модели и без перестройки самого банка.
Цена подхода — обучение на полных взаимодействиях. Среда должна надёжно определять успех задачи, а команда должна запускать исполнителя несколько раз для одного варианта контекста. Для процессов без проверяемого результата ExPO не получает достаточно чёткого сигнала.
Перенос между условиями снижает риск привязки к одной конфигурации. Сборщик, обученный на розничной торговле, сохранил пользу в задачах авиаперевозок и телекома; политика также работала с другим исполнителем и банками, созданными более сильными моделями, без дополнительного обучения.
Область проверенного результата — процедурная память для многошаговой поддержки клиентов в τ2-bench, где агент следует правилам, вызывает инструменты и разговаривает с имитатором пользователя. Эксперименты использовали замороженные Qwen3-4B-Instruct и Ministral-3-8B-Instruct. Для фактов, истории конкретного пользователя и моделей другого масштаба эффект отдельного сборщика предстоит проверять заново.
Источники
Иллюстрация: рисунок из статьи «MemComposer: Learning to Assemble Memories for LLM Agents via Reinforcement Learning», Yixuan Xie, Xueqiang Xu, Xinyi Fan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


