
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обработку документов длиннее окна контекста удалось ускорить без снижения точности на самых длинных входах. В нерецензированном препринте команда Xi’an Jiaotong University и Imperial College London сама получила для MemDuet ускорение в 9,74 раза и сокращение числа выходных токенов на 73,91% относительно RL-MemAgent. Для систем анализа больших архивов это предлагает альтернативу увеличению окна контекста: крупную модель можно вызывать только там, где память действительно требует обновления.
Небольшая модель ищет факты, крупная переписывает память
Агенты с рекуррентной памятью читают документ частями. После каждого фрагмента модель решает, какую информацию оставить, и записывает новое текстовое состояние фиксированного размера. Такой подход снимает жёсткую зависимость от окна контекста, но создаёт последовательную цепочку дорогих вызовов: чем длиннее документ, тем чаще крупная модель переписывает память.
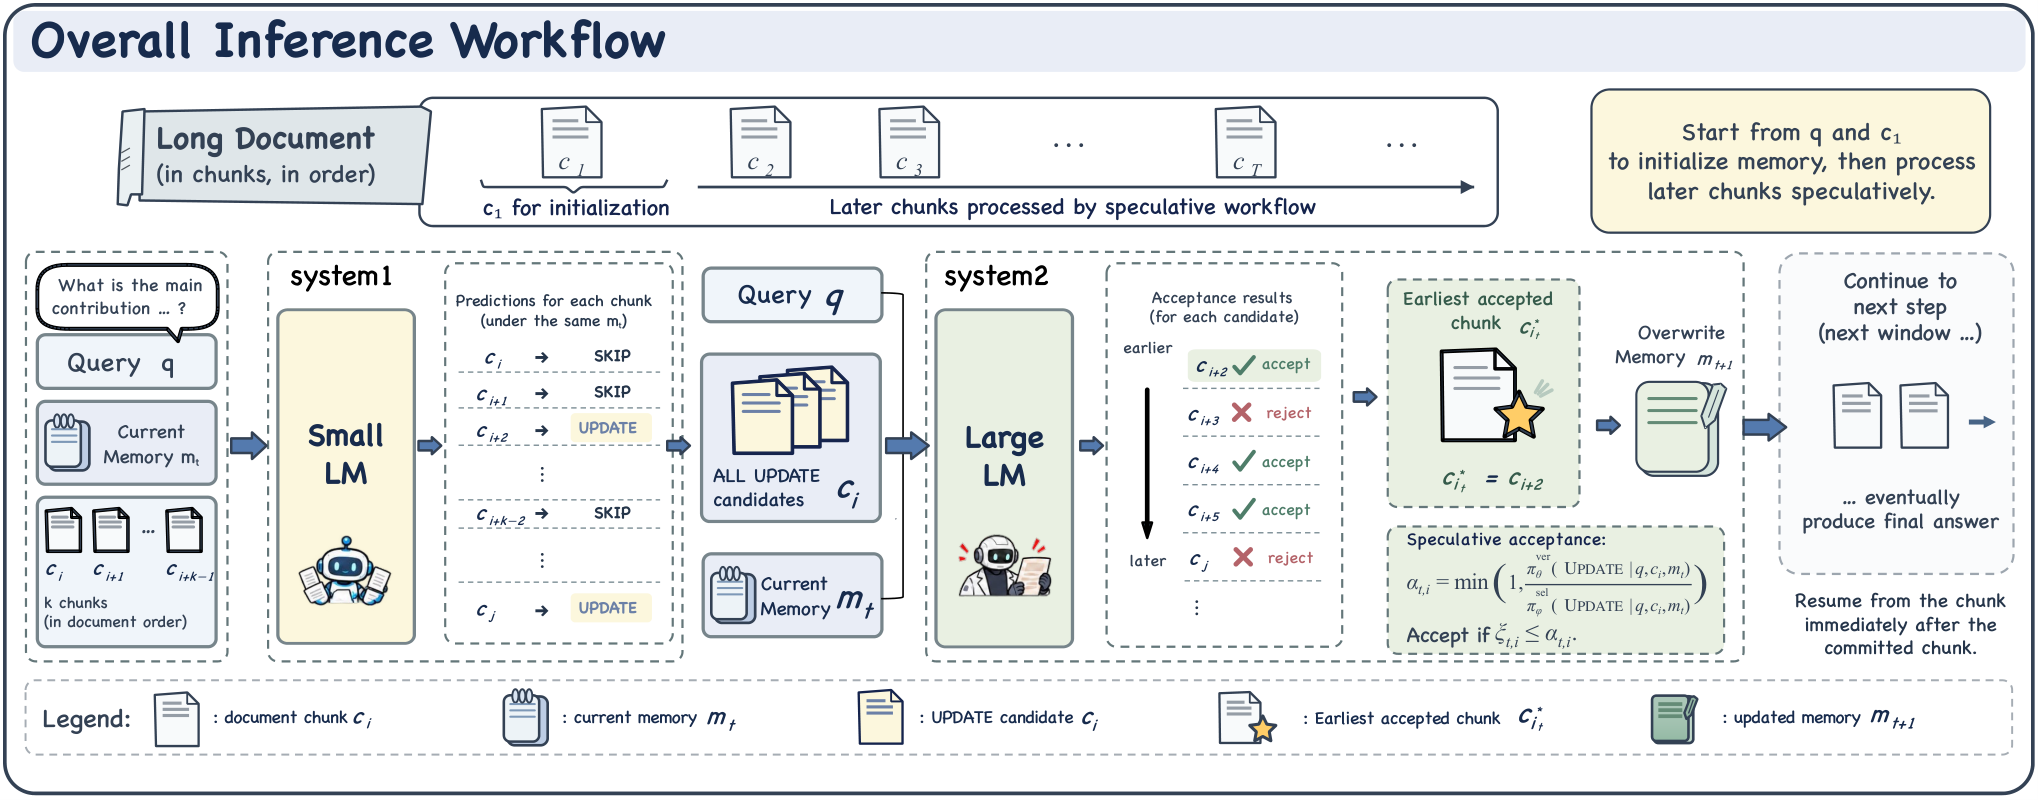
MemDuet делит эту работу между двумя моделями. Qwen3.5-2B просматривает исходные фрагменты параллельно, учитывает вопрос и текущую память, а затем помечает каждый фрагмент как подходящий для обновления или пропуска. Отобранный текст передаётся без предварительного сжатия, поэтому следующая модель видит исходное доказательство, а не его пересказ.
Qwen2.5-7B-Instruct повторно проверяет кандидатов. Если обновление оправдано, модель выбирает первый принятый фрагмент в порядке документа и переписывает память. Все более поздние решения после этого рассчитываются заново уже с новым состоянием: факт, полезный до обновления, может оказаться лишним после него.
Такое устройство напоминает черновой отбор с последующей проверкой. Небольшая модель должна пропускать как можно меньше полезных фактов, а крупная отсекает ложные срабатывания. Ошибка в обратную сторону опаснее: если первый этап не выбрал нужный фрагмент, второй уже не сможет его восстановить.
Обучение тоже разделено по ролям. Сначала отборщик учится на размеченных фактах HotpotQA и получает отдельные примеры, где уже записанный факт нужно пропустить, а не добавить повторно. Затем крупную модель обучают с подкреплением через GRPO: награда за итоговый ответ одновременно настраивает проверку кандидатов, переписывание памяти и генерацию ответа. На последнем этапе обе модели совместно подстраивают LoRA-адаптеры, сохраняя основные параметры замороженными.
Выигрыш появляется по мере роста документа
На RULER-HQA MemDuet обработал контекст до 3,5 млн токенов. На максимальной длине точность оказалась выше RL-MemAgent на 3,90 процентного пункта, обработка ускорилась в 49,61 раза, а число выходных токенов сократилось на 99,14%. Экономия растёт вместе с документом, потому что фиксированные расходы на первичный отбор распределяются по большему числу пропущенных фрагментов.
На LongBench v2 картина зависит от длины. MemDuet уступает на коротких и средних заданиях, где весь вход ещё можно обработать напрямую, но лидирует среди сравниваемых методов в длинных группах. На 2WikiMultiHopQA переход такой же: преимущество возникает после того, как последовательные обновления памяти становятся основным источником затрат.
Проверка охватывает RULER-HQA, LongBench v2 и длинную версию 2WikiMultiHopQA. MemDuet сравнивали с RL-MemAgent, LycheeMemory, ReMemR1 и моделями, которые принимают длинный контекст напрямую. Основная конфигурация построена на семействе Qwen, поэтому перенос результата на кодовые базы, юридические архивы или журналы событий требует отдельной проверки на данных конкретного продукта.
Параллельная обработка сама по себе дала небольшой прирост. Обновления памяти обязаны сохранять порядок документа, поэтому после принятого фрагмента часть заранее выполненных вычислений приходится отбрасывать. Основную экономию создаёт не параллелизм, а сокращение числа вызовов крупной модели и объёма текста, который она генерирует.
Когда MemDuet меняет архитектурный план
Подход стоит прототипировать, если продукт регулярно обрабатывает документы, которые не помещаются в окно модели, а текущий агент переписывает память после каждого фрагмента. Вместо перехода на модель с ещё большим контекстом команда может добавить дешёвый слой отбора перед существующим механизмом памяти. При коротких запросах такая схема лишь добавит координацию и риск потерять доказательство.
Для API отдельное обучение не обязательно. В опытах с DeepSeek-V4 и GPT-5.6 готовая небольшая модель предлагала кандидатов, а крупная принимала или отклоняла их перед обновлением памяти. Задержка снизилась примерно на 71%, стоимость — примерно на 59%, а точность изменилась не более чем на 0,60 процентного пункта.
Это делает MemDuet практическим вариантом маршрутизации вызовов, а не только новым способом обучать LLM. Для внедрения понадобятся журнал выбранных фрагментов, доступ к исходным документам и проверка полноты на рабочих сценариях. В задачах, где пропуск одного условия опаснее лишнего вызова модели, первый этап следует настраивать на широкий охват, оставляя фильтрацию крупной модели.
Источники
Иллюстрация: рисунок из статьи «MemDuet: Learning Dual-Process Memory for Long-Context Reasoning», Jiangcheng Song, Haodong Jing, Yulin Mu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


