
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агент научился уточнять правила незнакомой среды и использовать новые версии для следующих решений, не меняя параметры LLM. В нерецензированном препринте, где все числа получили сами авторы, Memento 3 прошёл уровни всех 25 публичных игр ARC-AGI-3, затратив 44% от числа действий человека. Такая схема отделяет накопление знаний от дообучения модели.
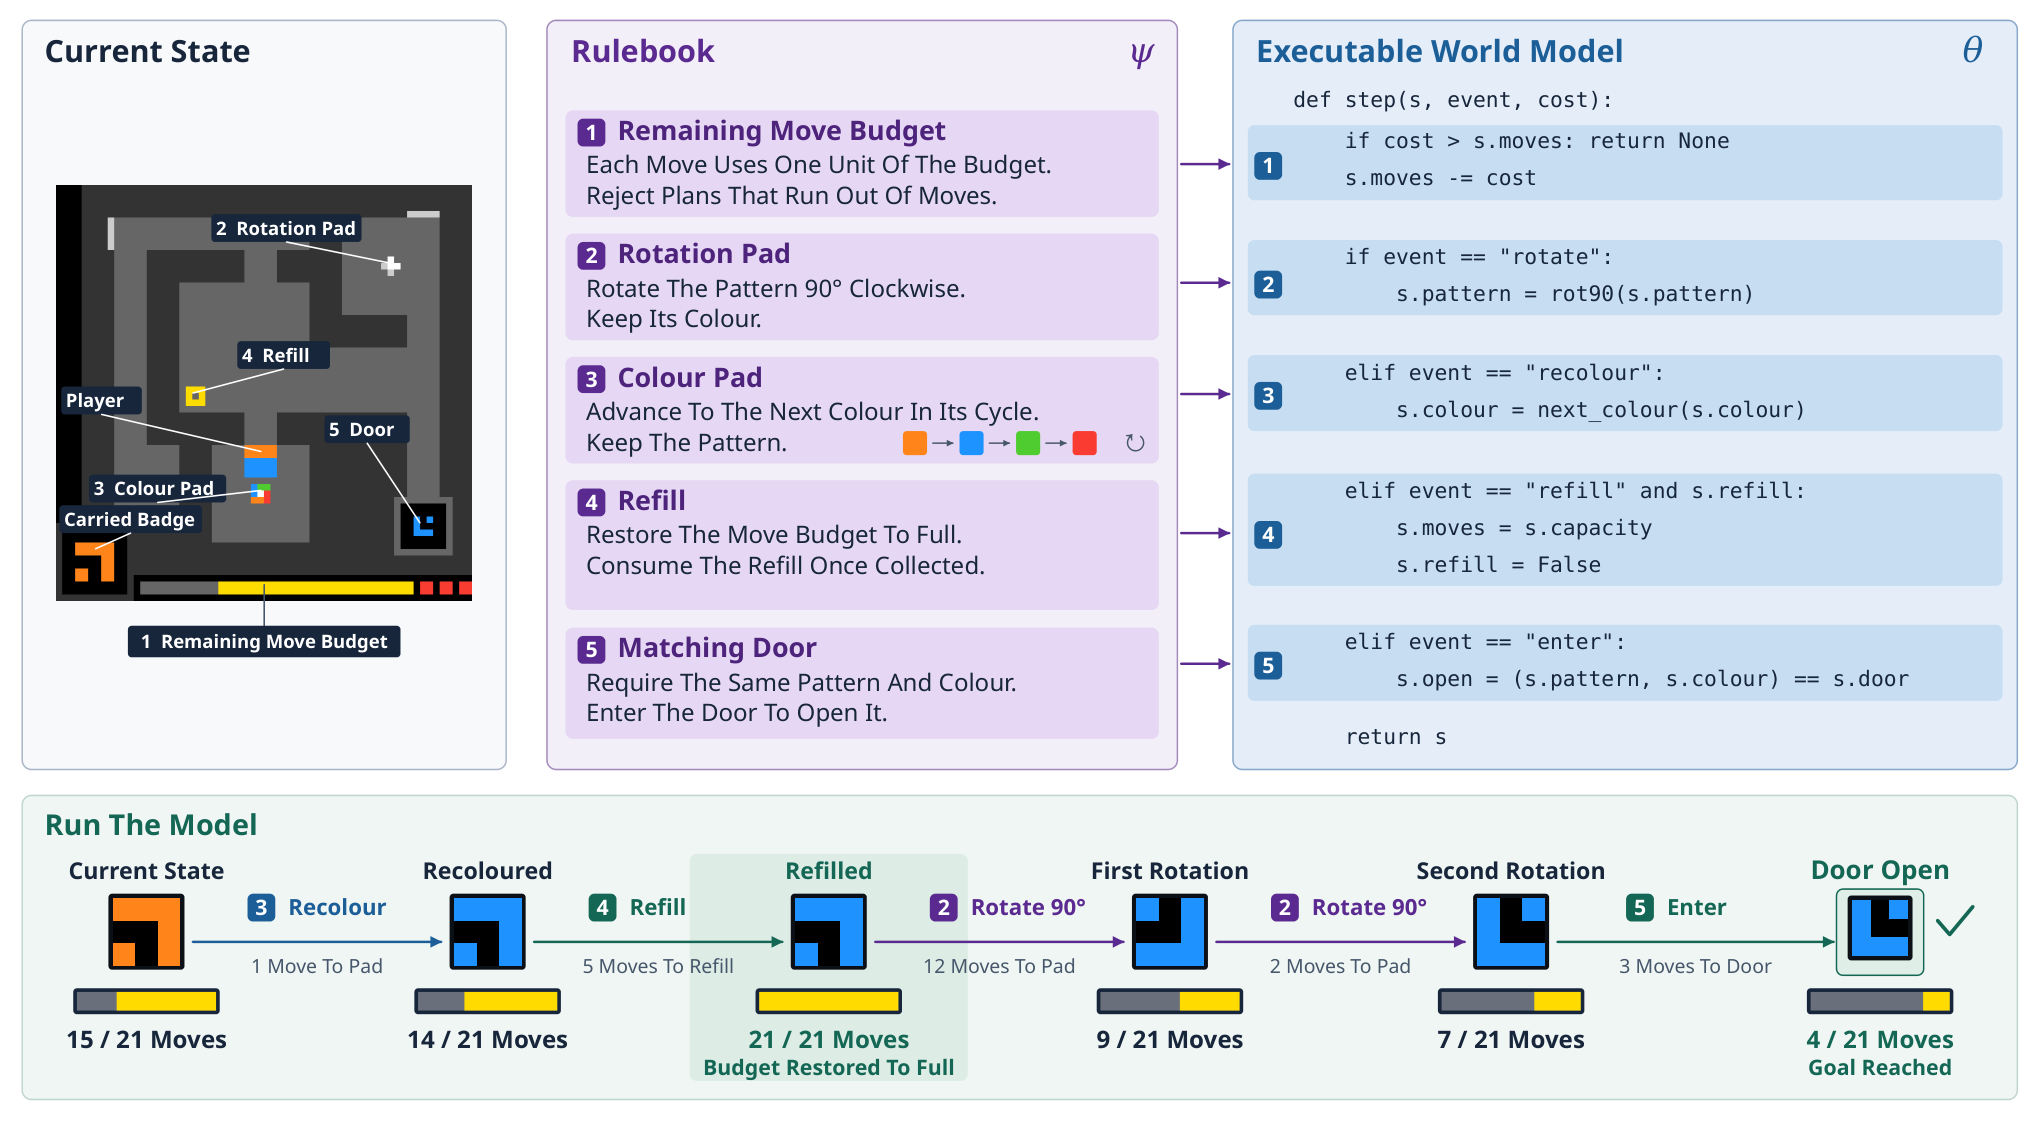
Memento 3 хранит предположения об объектах, действиях, динамике и цели во внешнем текстовом своде правил. Затем LLM превращает этот свод в исполняемый код: планировщик запускает его, прогнозирует последствия действий и выбирает маршрут к цели. Сама LLM остаётся неизменной, а обучаемым состоянием служат история взаимодействий, правила и код.
Ошибки прогноза запускают следующий цикл: агент пересматривает правило, заново создаёт код и проверяет обновление. Новая версия проходит два фильтра: LLM сверяет код со сводом правил, а точное воспроизведение истории подтверждает, что программа повторяет все наблюдавшиеся переходы. В расширенном варианте агент поддерживает несколько моделей среды параллельно, проверяет их на общей истории и поочерёдно использует для исследования.
На ARC-AGI-3 средняя RHAE достигла предельного значения 100: эта метрика учитывает прохождение игры и расход действий относительно человека. Отдельно схему проверили в Atari Pong: созданный по выученной модели регулятор выиграл 21:0 в каждой из трёх партий и во время игры больше не обращался к LLM.
Проверка охватывает публичный набор коротких детерминированных игр и один пример непрерывного управления. Она показывает не универсальное самоулучшение модели, а более узкий механизм: агент улучшает внешний, доступный для просмотра и исполнения образ среды, а затем использует его, чтобы собрать данные для следующей правки.
Источники
Иллюстрация: рисунок из статьи «Memento 3: Model-Based Recursive Self-Improvement through Reflective Rulebooks», Haoyu Zhao, Zhengxu Yu, Zhiyuan He и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


