
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Свёрточную нейросеть научились дообучать на устройстве, не сохраняя до обратного прохода полноразмерные промежуточные тензоры слоёв — активации. MemFLoRA от команды Technical University of Munich сократила пиковую память состояния обучения на 94,9–97,3% относительно полного дообучения, хотя препринт не рецензирован и все числа получили сами авторы. Для разработчиков периферийных систем это меняет главный критерий выбора адаптера: считать нужно не только обучаемые параметры, но и данные, которые граф вычислений удерживает для градиентов.
Почему малое число параметров не гарантирует малый расход памяти
LoRA замораживает основную модель и обучает небольшие низкоранговые добавки к её слоям. Это сокращает память под градиенты и состояние оптимизатора, но в свёрточной сети основное место могут занимать активации, сохранённые во время прямого прохода.
Обычный низкоранговый адаптер состоит из понижающей и повышающей проекций. Если обе обучаются, для градиента первой проекции приходится удерживать полный вход слоя. В результате параметров мало, а объём сохранённых признаков остаётся сопоставимым с полным дообучением.
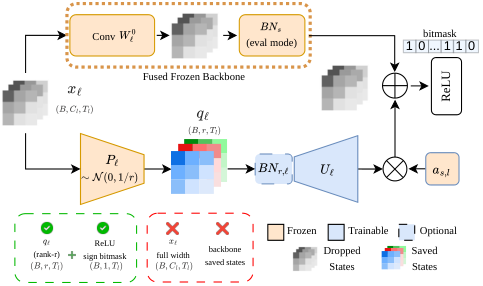
MemFLoRA вводит более жёсткое правило: ни одна обучаемая операция при обратном проходе не должна зависеть от полноразмерного входа слоя. Понижающую проекцию замораживают, поэтому сохранять нужно только её узкий выход. Повышающая проекция остаётся обучаемой и получает пространственное ядро, чтобы адаптер мог менять временные или пространственные фильтры, а не только смешивать готовые признаки.
Этого недостаточно без изменений в остальном графе. Пакетную нормализацию основной сети переводят в режим оценки с зафиксированной статистикой, а для ReLU сохраняют битовую маску знаков вместо полного тензора. Свёртку, нормализацию и ReLU объединяют в оператор с собственным обратным проходом, который освобождает широкие промежуточные результаты после каждого слоя.
Выход адаптера масштабируют коэффициентами из исходной пакетной нормализации. Без такого согласования узкая ветвь и основная сеть работают в разных масштабах, из-за чего обучение в эксперименте практически разрушалось. Фиксированный коэффициент не требует дополнительного состояния и оказался лучше отдельной нормализации внутри адаптера.
Метод проверяли на трёх наборах данных распознавания человеческой активности и двух архитектурах, T-ResNet и MobileNetV2. Эксперименты охватывали перенос между людьми, положениями устройства на теле и вариантами размещения датчика; MemFLoRA сравнивали с полным дообучением, LoRA-C, LoRA-Edge и вариантами TinyTL.
Реальный пик памяти снизился слабее расчётного, но всё ещё примерно в семь раз
Замеры на NVIDIA Jetson Orin Nano проводили при ранге адаптера 2 и пакете из 64 примеров. Для MobileNetV2 полный пик запрошенной CUDA-памяти составил 95,4 МБ у MemFLoRA против 673,4 МБ у полного дообучения. Эта метрика включает не только состояние, которое сохраняют для обратного прохода, но также входные данные, временные тензоры и рабочие области операций.
Разница между двумя метриками важна для проектирования устройства. MemFLoRA почти устраняет накопление активаций, однако ранние слои MobileNetV2 создают крупные временные тензоры. Они освобождаются после обработки слоя, но всё равно задают кратковременный пик, который нельзя увидеть по размеру параметров или сохранённого состояния.
Экономия памяти не потребовала пропорционального роста вычислений: базовый вариант MemFLoRA потратил 70–71% операций полного дообучения и почти совпал по этому показателю с LoRA-Edge. По средней F1 для классов он соответствовал или превосходил проверенные низкоранговые методы при разных архитектурах и размерах узкой ветви.
Эти результаты относятся к короткому дообучению моделей для показаний датчиков. Они показывают жизнеспособность устройства и вычислительного графа, но доказательная база пока ограничена двумя компактными CNN и задачами распознавания активности.
Когда MemFLoRA меняет план разработки
Работа влияет на планы команд, которым нужно персонализировать CNN после развёртывания: под конкретного пользователя, положение датчика или изменившуюся среду. Если расчёт памяти основан только на числе обучаемых весов и состоянии оптимизатора, его стоит пересмотреть до выбора оборудования.
Первый практический шаг — измерить полный цикл обновления на целевом ускорителе. Отдельно полезно учитывать сохранённые для градиентов данные и максимальный объём памяти, который запрашивает среда исполнения. Второй показатель определяет, запустится ли обучение на устройстве, даже когда архитектурная оценка выглядит безопасной.
Второй шаг — проверить зависимости обратного прохода. Обучаемая понижающая проекция, пакетная нормализация в режиме обучения и стандартный ReLU могут вернуть полноразмерные активации в граф. Простая замена адаптера без объединённого оператора поэтому не воспроизведёт заявленную экономию.
Цена подхода — более специализированная реализация обучения. Команде потребуется собственный оператор или управляемый обратный проход, фиксированная статистика нормализации и проверка масштаба адаптера. Зато MemFLoRA даёт понятный архитектурный ориентир: память должна зависеть от ширины узкой ветви, а не от числа каналов основного слоя.
Для продукта, который только выполняет вывод, работа ничего не меняет. Для локальной адаптации сенсорной CNN она предлагает более полезный порядок проектирования: сначала устранить широкие зависимости в обратном проходе, затем выбирать ранг и считать обучаемые параметры.
Источники
Иллюстрация: рисунок из статьи «MemFLoRA: Memory-Floor LoRA for CNN Adaptation at the Edge», Mehmet Emre Akbulut, Johannes Geier, Ulf Schlichtmann, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


